Databricks Tips #16: Data Quality — expectations dinámicas, cuarentena y DQX
Databricks Tips
Data Engineering
Warn es el default y no filtra nada: cómo pasar de checks sueltos a un sistema de calidad en Databricks, con reglas cargadas dinámicamente desde una tabla Delta, cuarentena que no pierde registros, monitoreo post-escritura y DQX de Databricks Labs.
Configuraste expectations en tu pipeline, el grafo corre verde y las métricas de calidad se acumulan en el event log. Y sin embargo la tabla silver tiene montos negativos. No es un bug: warn es la acción default de una expectation, y warn no filtra nada. El registro inválido suma uno a una métrica que nadie mira, y se escribe igual.
En el Tips #11 vimos las expectations como una feature más de Lakeflow pipelines, el producto que antes se llamaba Delta Live Tables (en el resto del post, DLT). Este post las toma como punto de partida para armar el sistema completo: las trampas que no aparecen en el tutorial, las reglas definidas como datos en vez de código, la cuarentena que no pierde registros, el monitoreo estadístico posterior a la escritura, y DQX, la librería de Databricks Labs que cubre lo que pasa fuera de un pipeline.
NotaTL;DR
- Las expectations validan por registro dentro de un pipeline con tres acciones: warn (default, escribe igual), drop (descarta) y fail (revierte el update). Lo básico está en el Tips #11; acá van las trampas.
- Las reglas pueden vivir como datos en una tabla Delta (o en Lakebase, si las edita una app) y cargarse dinámicamente con Python: un solo lugar para las reglas de todos tus pipelines. Solo en Python; SQL no soporta carga dinámica.
- El Quarantine Pattern oficial no usa drop: marca cada registro con una columna
is_quarantinedy lo separa en dos vistas, sin perder nada y leyendo la fuente una sola vez. - Data quality monitoring (lo que antes se llamaba Lakehouse Monitoring) agrega la pata estadística posterior a la escritura: detección de anomalías (freshness y completeness) y perfiles con drift.
- DQX, de Databricks Labs, lleva los checks a cualquier DataFrame, dentro o fuera de pipelines, con cuarentena de fábrica y el porqué de cada rechazo, fila por fila. Es pre-1.0: fijá la versión.
1. El mapa: cuatro mecanismos, cuatro momentos
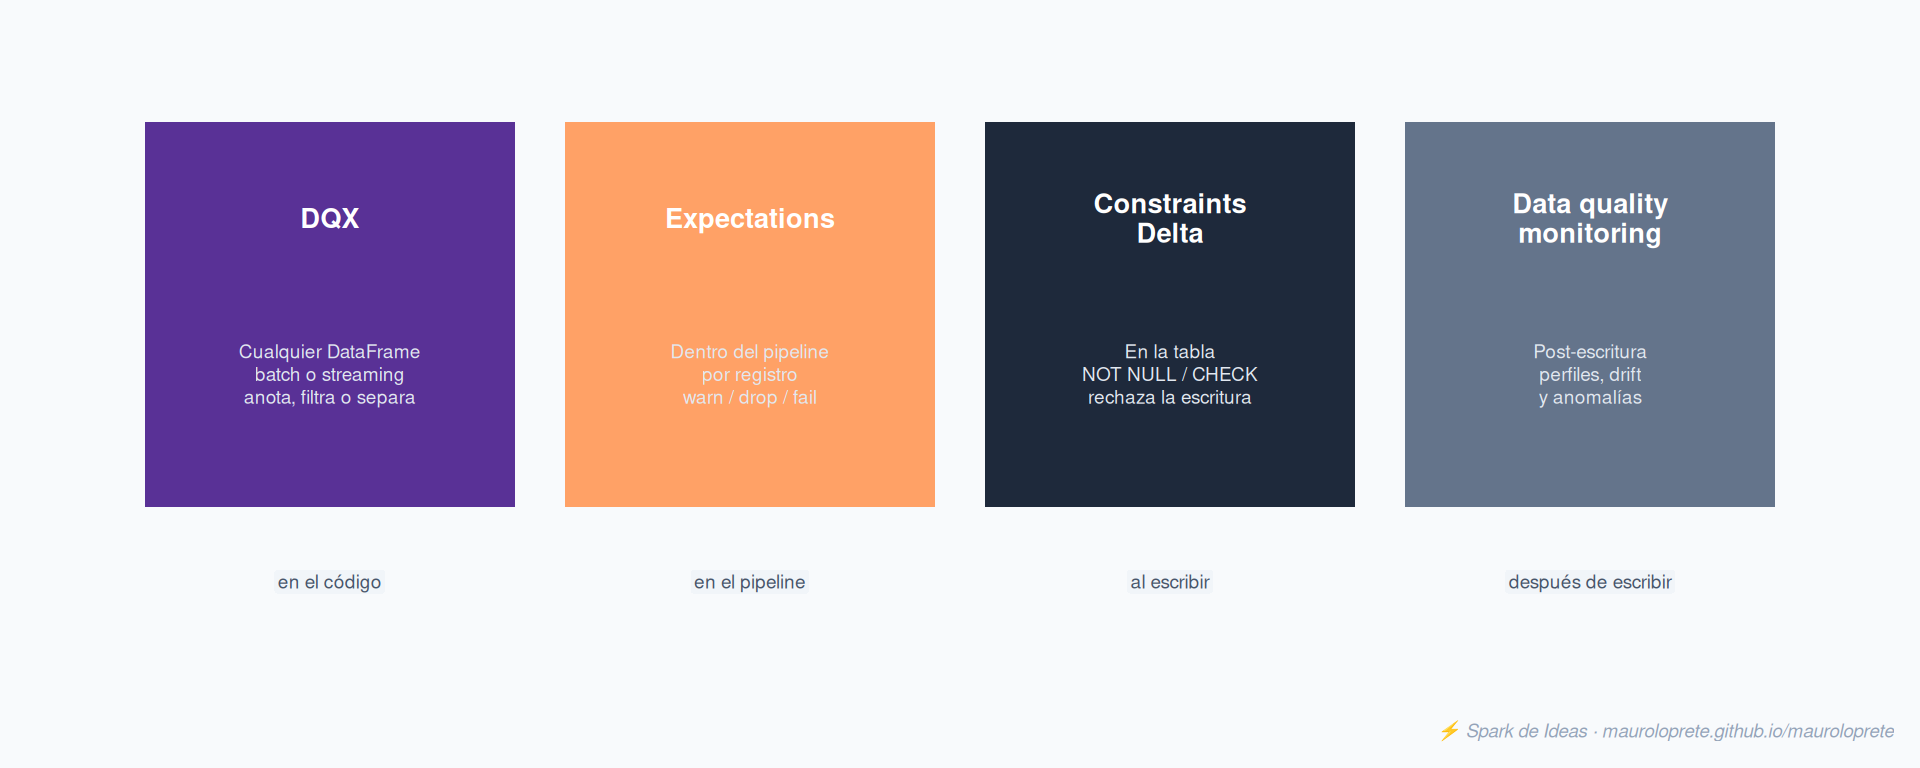
“Data quality en Databricks” no es una herramienta, son cuatro que actúan en momentos distintos del flujo. Elegir mal cuál usar es la fuente de la mayoría de las frustraciones: pedirle a una expectation que valide una tabla histórica, o a un monitor que frene un registro inválido, es pedirle al mecanismo algo que no hace.
| Mecanismo | Dónde corre | Granularidad | Qué hace con lo inválido |
|---|---|---|---|
Constraints de Delta (NOT NULL, CHECK) |
En la tabla, venga de donde venga la escritura | La transacción entera | Rechaza la escritura completa |
| Expectations | Solo dentro de un pipeline DLT | Por registro | warn, drop o fail |
| DQX (Databricks Labs) | Cualquier DataFrame, dentro o fuera de pipelines | Por registro, con detalle por regla | Anota columnas de error, filtra o separa en cuarentena |
| Data quality monitoring (Unity Catalog) | Sobre la tabla ya escrita | Estadística: perfiles, drift, anomalías | Observa y alerta, no bloquea |
Los constraints de Delta son la red de contención más dura: si un registro viola un CHECK, falla la escritura entera, no la fila. Sirven como garantía de último recurso, pero no como sistema de calidad: no te dicen cuántos registros venían mal ni cuáles, y un solo registro inválido te tira el job. El resto del post se concentra en los otros tres mecanismos, que son los que dan visibilidad.
2. Expectations: el repaso en una tabla y las trampas
El repaso completo está en el Tips #11; lo esencial entra en una tabla:
| Acción | SQL | Python | Los registros inválidos |
|---|---|---|---|
| Warn (default) | EXPECT (cond) |
@dp.expect |
Se escriben igual, se loguean métricas |
| Drop | EXPECT ... ON VIOLATION DROP ROW |
@dp.expect_or_drop |
Se descartan antes de escribir |
| Fail | EXPECT ... ON VIOLATION FAIL UPDATE |
@dp.expect_or_fail |
El update falla y la transacción se revierte |
Lo que no estaba en el Tips #11 son las trampas:
- Warn no filtra, y es el default. Una expectation sin
ON VIOLATIONdeja pasar todo. Si nadie consulta las métricas, tenés validación decorativa: la tabla “validada” acumula basura con contador. - Fail no deja métricas. El update falla antes de loguear, así que en el event log no queda registrado cuántas filas violaron la regla. Para diagnosticar tenés que mirar el error del update, no las métricas de calidad.
- Fail revierte el flow, no el pipeline. Cada dataset del grafo se actualiza con su propio flow (el proceso que lo refresca). En un pipeline triggered, la falla revierte ese flow; las demás tablas del grafo pueden haber actualizado igual. En modo continuous sí se detienen el flow y sus dependientes.
- Solo SQL booleano. El constraint de una expectation no acepta funciones Python definidas por el usuario, llamadas a servicios externos ni subqueries contra otras tablas. Si tu regla necesita eso, es territorio de DQX (sección 6).
- Las expectations no orquestan. Una tabla de validación con
expect_or_failno bloquea a sus tablas downstream: el grafo sigue. Si necesitás que “nada corra si la validación falla”, la doc oficial recomienda separar validación y procesamiento en pipelines distintos coordinados por un job. - Lo ya escrito no se revalida solo. Las expectations se evalúan sobre cada registro que la query procesa durante un update. En una streaming table con refresh incremental eso significa solo los datos nuevos: lo que ya está en la tabla no vuelve a validarse salvo que fuerces un full refresh (que reprocesa toda la fuente). En una materialized view, la recomputación sí puede revalidar el dataset entero. Para validar una tabla existente sin tocar el pipeline: DQX o un job aparte. (Es la versión más precisa del gotcha #10 del Tips #11.)
- No cualquier dataset las soporta. Streaming tables, materialized views y temporary views sí;
AUTO CDC FROM SNAPSHOTno. Y en una view la expectation se evalúa recién cuando otro dataset la consulta, así que las métricas pueden faltar o venir duplicadas.
NotaNovedad 2026: expectations sin pipeline
Desde junio de 2026 se pueden declarar expectations en materialized views standalone, con la sintaxis CONSTRAINT ... EXPECT (...), sin definir un pipeline. La brecha “expectations solo dentro de DLT” se está cerrando de a poco: vale la pena revisar las release notes antes de descartar la herramienta para un caso.
3. Reglas como datos: metaprogramación de expectations
En el Tips #11 las reglas eran un diccionario Python arriba de la tabla:
quality_rules = {
    "monto_positivo": "monto > 0",
    "cliente_presente": "cliente_id IS NOT NULL",
}
Funciona hasta que tenés 15 pipelines con las mismas reglas copiadas y pegadas, y un cambio de criterio de negocio se convierte en 15 pull requests. La solución que recomienda la propia doc es tratar las reglas como datos: una tabla Delta con una fila por regla, y una función que las carga al armar el pipeline.
CREATE TABLE gobernanza.calidad.reglas (
  nombre    STRING,   -- identificador de la regla
  condicion STRING,   -- el constraint SQL booleano
  etiqueta  STRING    -- agrupa reglas por criterio o por tabla
);

INSERT INTO gobernanza.calidad.reglas VALUES
  ('monto_positivo',   'monto > 0',                 'validez'),
  ('cliente_presente', 'cliente_id IS NOT NULL',    'validez'),
  ('moneda_conocida',  "moneda IN ('UYU', 'USD')",  'validez'),
  ('fecha_no_futura',  'fecha <= current_date()',   'plausibilidad');
from pyspark import pipelines as dp
from pyspark.sql import functions as F
def get_rules(etiqueta):
filas = (
spark.read.table("gobernanza.calidad.reglas")
.filter(F.col("etiqueta") == etiqueta)
.collect()
)
return {fila["nombre"]: fila["condicion"] for fila in filas}
@dp.table
@dp.expect_all_or_drop(get_rules("validez"))
def silver_transacciones():
return spark.readStream.table("bronze_transacciones")El decorador @dp.expect_all_or_drop recibe el diccionario completo y aplica todas las reglas de la etiqueta. Las ventajas se sienten rápido:
- Un solo lugar para las reglas. Cambiar un umbral es un
UPDATEa la tabla (con su historial en Delta), no un deploy de código. - Las reglas quedan historiadas.
DESCRIBE HISTORYregistra cada cambio a la tabla, y con time travel podés comparar versiones. Ojo con las ventanas por defecto (30 días de historial, 7 de datos para time travel): para auditoría de largo plazo, versioná las reglas aparte o extendé la retención. - Otros equipos pueden proponer reglas sin tocar el repo del pipeline: escribir una fila es más accesible que un pull request.
TipLas reglas tampoco tienen por qué vivir en Delta
Si las reglas las administra una aplicación (un backoffice donde el equipo edita umbrales, con escrituras transaccionales y latencia baja), ese es justo el caso de Lakebase, el Postgres gestionado de Databricks: registrás la base como catálogo de solo lectura en Unity Catalog y get_rules() la lee igual que cualquier tabla. DQX (sección 6) va por el mismo camino: Lakebase está entre sus opciones oficiales de storage de checks.
AdvertenciaDos letras chicas
La carga dinámica de reglas es solo Python: la doc lo dice explícito, en SQL no se puede. Y la tabla de reglas se lee cuando el pipeline interpreta el código fuente y arma su grafo, no en cada microbatch (la doc no documenta relectura durante la ejecución; sí avisa que el código puede evaluarse varias veces durante la planificación). En la práctica: no cuentes con que un INSERT en la tabla de reglas cambie un pipeline andando; el momento seguro para que entre una regla nueva es el próximo update.
NotaReglas gestionadas en Unity Catalog
Desde enero de 2026, las release notes anuncian soporte para almacenar y gestionar expectations directamente en tablas de Unity Catalog: reglas centralizadas, versionadas y compartibles entre pipelines. Es la misma idea de este patrón, pero con soporte de primera clase de la plataforma.
4. El Quarantine Pattern bien hecho
Drop tiene un problema que se nota tarde: los registros descartados no van a ningún lado. Las métricas te dicen cuántos se fueron, pero cuando negocio pregunta “mostrame las filas que rechazaste esta semana”, no están.
La respuesta es el Quarantine Pattern: en vez de descartar los inválidos, separarlos en una tabla de cuarentena para investigarlos, corregirlos y reprocesarlos. En el Tips #11 mostré la versión simple, que hoy me parece mejorable: una tabla con expect_or_drop y otra leyendo la misma fuente con el filtro invertido. Funciona, pero lee la fuente dos veces, y las dos listas de condiciones (la regla y su negación) evolucionan por separado hasta que un día no coinciden.
El patrón que recomienda la doc oficial resuelve las dos cosas con una sola lectura:
from pyspark import pipelines as dp
from pyspark.sql import functions as F

reglas = get_rules("validez")

# Un registro va a cuarentena si NO cumple todas las reglas
condicion_cuarentena = "NOT({0})".format(
    " AND ".join(f"({c})" for c in reglas.values())
)

@dp.table(partition_cols=["is_quarantined"])
@dp.expect_all(reglas)   # warn: deja métricas, no filtra
def transacciones_marcadas():
    return (
        spark.readStream.table("bronze_transacciones")
        .withColumn("is_quarantined", F.expr(condicion_cuarentena))
    )

@dp.table
def silver_transacciones():
    return (
        spark.readStream.table("transacciones_marcadas")
        .filter("is_quarantined = false")
        .drop("is_quarantined")
    )

@dp.table
def cuarentena_transacciones():
    return (
        spark.readStream.table("transacciones_marcadas")
        .filter("is_quarantined = true")
    )
Tres decisiones de diseño que valen la pena entender:
- La marca se calcula una vez. La columna
is_quarantinedes la negación de las mismas reglas que ves en las métricas, generada desde el mismo diccionario. No hay dos listas que mantener sincronizadas. expect_allen modo warn, a propósito. Acá warn es exactamente lo que queremos: métricas por regla en el event log, sin filtrar, porque el filtro lo hacen las tablas downstream con la marca.- Particionar por
is_quarantinedhace que leer solo los válidos (o solo la cuarentena) no escanee la tabla entera.
TipLa cuarentena es una bandeja de entrada, no un archivo muerto
Una tabla de cuarentena que solo crece es un síntoma de que el patrón está a medias. El circuito completo tiene tres salidas: investigar (por qué entran registros inválidos), corregir (arreglar el origen o transformar el registro) y reprocesar (reinsertar lo corregido al flujo). Si en tu equipo nadie es dueño de ese circuito, la cuarentena es un drop con más storage.
5. Lo que pasa después de escribir: Data quality monitoring
Todo lo anterior valida registros en el camino. Pero hay problemas de calidad que ningún check por registro detecta: la tabla que dejó de actualizarse ayer, el volumen diario que cayó a la mitad, la distribución de una columna que se corrió sin que ninguna fila individual sea inválida.
Para eso Unity Catalog trae Data quality monitoring (el data profiling de esta suite es lo que antes se llamaba Lakehouse Monitoring, si lo tenías fichado por ese nombre). Corre sobre tablas ya escritas, con cómputo serverless gestionado, sin tocar el pipeline ni modificar las tablas monitoreadas. Son dos patas:
Anomaly detection (en Public Preview) se habilita a nivel schema o catálogo y vigila dos cosas en todas sus tablas: freshness (¿esta tabla se actualizó cuando el historial de commits predice que debía?) y completeness (¿el volumen de filas de las últimas 24 horas cae dentro del rango esperado según el historial?). Los resultados quedan en la tabla de sistema system.data_quality_monitoring.table_results, y el Catalog Explorer muestra indicadores de salud por tabla. El análisis de causa raíz corre aparte: usa el linaje de Unity Catalog para razonar sobre las dependencias y señala la fuente probable del problema en la columna Root Cause de la UI de Data Quality Monitoring.
Data profiling se configura por tabla y calcula estadísticas descriptivas (nulos, distribuciones, cuantiles) y métricas de drift entre ventanas de tiempo o contra una tabla baseline: cuánto se movió la distribución respecto de la semana pasada o respecto del dataset de referencia. Tres tipos de análisis según la tabla (time series, inference para outputs de modelos, snapshot), dos tablas Delta de métricas como salida y un dashboard autogenerado. Acepta métricas custom y alertas sobre las métricas.
¿Cuándo usar esto en vez de expectations? No es “en vez”: es la otra mitad.
| Pregunta | Herramienta |
|---|---|
| ¿Este registro es válido? | Expectations / DQX, en el pipeline |
| ¿Esta tabla está llegando a tiempo, completa? | Anomaly detection |
| ¿La distribución de esta columna se corrió? | Data profiling (drift) |
| ¿El modelo está degradando sus predicciones? | Data profiling en modo inference |
NotaCostos y límites
El monitoreo corre en serverless y se factura bajo el SKU compartido de serverless jobs (SKU es el código de facturación); en system.billing.usage lo identificás con billing_origin_product = 'DATA_QUALITY_MONITORING' para los registros desde febrero de 2026. Antes de habilitarlo sobre un catálogo entero, probalo en un schema: la habilitación masiva a nivel catálogo acepta hasta 50 schemas por operación, anomaly detection no monitorea views ni foreign tables, y data profiling solo trabaja sobre tablas Delta.
6. DQX: calidad para lo que vive fuera del pipeline
Las expectations tienen una frontera clara: viven en pipelines (hasta las materialized views standalone de la sección 2 van respaldadas por un pipeline gestionado). Las tablas Delta que escribís con jobs de Spark clásico, notebooks o scripts quedan afuera. Ahí entra DQX, un framework Python de Databricks Labs, el paraguas de proyectos abiertos que Databricks publica fuera del producto (lo presenté en el mapa de GitHub de Databricks, y es de los repos que más uso: valido datos entre capas del medallion con él en producción).
DQX aplica checks de calidad a cualquier DataFrame de PySpark, batch o streaming, y resuelve tres cosas que las expectations no:
- Funciona en cualquier lado: pipelines, jobs, notebooks, incluso sobre una tabla histórica completa (justo el caso que las expectations no cubren).
- Te dice por qué falló cada fila: anota columnas de error con la regla violada, en vez de un contador agregado.
- Cuarentena de fábrica:
apply_checks_and_splitdevuelve directamente dos DataFrames, válidos y cuarentena, sin armar el patrón a mano.
El flujo típico arranca con el profiler, que analiza una muestra de tus datos y genera reglas candidatas:
%pip install databricks-labs-dqx==0.15.0

from databricks.labs.dqx.profiler.profiler import DQProfiler
from databricks.labs.dqx.profiler.generator import DQGenerator
from databricks.labs.dqx.engine import DQEngine
from databricks.sdk import WorkspaceClient

ws = WorkspaceClient()
profiler = DQProfiler(ws)
_, perfiles = profiler.profile(df_entrada)

# Genera checks desde el perfil estadístico. Revisalos antes de aplicar:
# son candidatos, no verdades.
checks = DQGenerator(ws).generate_dq_rules(perfiles)

# Válidos por un lado, cuarentena por el otro
df_validos, df_cuarentena = DQEngine(ws).apply_checks_by_metadata_and_split(
    df_entrada, checks
)
Los checks se definen como metadata declarativa (una lista de diccionarios o un YAML, el formato de texto para archivos de configuración) y se pueden guardar en un archivo del workspace, un volumen de Unity Catalog, una tabla Delta o una base Lakebase. Es el mismo espíritu de la sección 3: las reglas son datos, versionables y compartibles, no código enterrado en cada job. Y cierra el círculo con DLT: el generador puede emitir las reglas como expectations para usarlas en un pipeline.
AdvertenciaLabs no es producto
DQX es pre-1.0 (v0.15.0 a junio de 2026) y los proyectos de Databricks Labs vienen sin soporte oficial ni SLA (acuerdo de nivel de servicio): se mantienen a pull requests y issues. La licencia es la Databricks License, no una licencia certificada por la OSI (Open Source Initiative, la organización que valida licencias open source). Nada de esto me impidió llevarlo a producción, pero sí implica una regla de higiene: fijá la versión (databricks-labs-dqx==0.15.0) y leé el changelog antes de subirla, porque la API todavía cambia entre releases.
7. El lab: reglas en una tabla, cuarentena y métricas
El lab junta las piezas de las secciones 3 y 4 en un pipeline chico y verificable: una tabla de reglas, un flujo con cuarentena y la consulta de métricas al event log. El paso a paso completo queda en spark-de-ideas-labs/tips/data-quality.
Paso 1: datos sucios a propósito. Una tabla bronze con un 10% de registros rotos conocidos: montos negativos, clientes nulos y una moneda inventada.
CREATE OR REPLACE TABLE lab.bronze.transacciones AS
SELECT
  id AS transaccion_id,
  CASE WHEN id % 20 = 0 THEN NULL
       ELSE concat('cliente_', id % 500) END      AS cliente_id,
  CASE WHEN id % 25 = 0 THEN -1 * (id % 900)
       ELSE (id % 900) + 10 END                   AS monto,
  CASE WHEN id % 50 = 0 THEN 'XXX'
       ELSE element_at(array('UYU', 'USD'), CAST(1 + id % 2 AS INT)) END AS moneda,
  date_add(DATE '2026-07-01', CAST(id % 30 AS INT)) AS fecha
FROM range(100000) AS t(id);
Paso 2: la tabla de reglas y el pipeline. El DDL de reglas de la sección 3 y el pipeline con is_quarantined de la sección 4, tal cual, con los nombres reales del lab: la fuente es lab.bronze.transacciones, las reglas se leen de gobernanza.calidad.reglas, y el pipeline (serverless, triggered) publica en lab.dq. El grafo queda: bronze a transacciones_marcadas, y de ahí silver_transacciones y cuarentena_transacciones. El update completo tardó menos de un minuto.
Paso 3: las métricas, por regla. La misma consulta al event log del Tips #11, que acá por fin muestra algo interesante, porque cada regla tiene su contador:
SELECT
  row_exp.dataset AS dataset,
  row_exp.name AS expectation,
  SUM(row_exp.passed_records) AS pasan,
  SUM(row_exp.failed_records) AS fallan
FROM (
  SELECT explode(
    from_json(
      details:flow_progress:data_quality:expectations,
      'array<struct<name:string, dataset:string, passed_records:int, failed_records:int>>'
    )
  ) AS row_exp
  FROM event_log('<pipeline_id>')
  WHERE event_type = 'flow_progress'
)
GROUP BY row_exp.dataset, row_exp.name
ORDER BY fallan DESC
La salida, corrida contra el pipeline del lab en el warehouse serverless:
dataset                        expectation       pasan  fallan
lab.dq.transacciones_marcadas  cliente_presente  95000    5000
lab.dq.transacciones_marcadas  monto_positivo    96000    4000
lab.dq.transacciones_marcadas  moneda_conocida   98000    2000
Cada regla con su contador, exactamente los rotos que sembramos en el paso 1: 5.000 clientes nulos, 4.000 montos inválidos, 2.000 monedas desconocidas.
Paso 4: la verificación que importa. Contar filas de silver_transacciones más cuarentena_transacciones y comparar contra bronze: la suma tiene que dar exacta. Ese es el contrato del patrón: acá no se pierde nada.
SELECT
  (SELECT count(*) FROM lab.bronze.transacciones)        AS bronze,
  (SELECT count(*) FROM lab.dq.silver_transacciones)     AS silver,
  (SELECT count(*) FROM lab.dq.cuarentena_transacciones) AS cuarentena;
bronze silver cuarentena
100000 92000 800092.000 más 8.000 dan los 100.000 de bronze, exacto. Y hay un detalle que enseña más de lo que parece: las métricas por regla suman 11.000 violaciones, pero la cuarentena tiene 8.000 registros. No es un error: las métricas cuentan violaciones por regla y la cuarentena cuenta registros, y un registro puede violar más de una regla a la vez (por cómo sembramos los datos, los múltiplos de 50 violan dos reglas y los de 100 violan las tres). Si alguna vez auditás un pipeline de calidad y los números “no cierran”, empezá por ahí.
8. Gotchas
1. La tabla de reglas se lee al interpretar el código. get_rules() corre cuando el pipeline arma su grafo, y la doc no documenta ninguna relectura por microbatch. No diseñes asumiendo que un INSERT en la tabla de reglas cambia el comportamiento de un pipeline andando: el momento garantizado para que una regla nueva entre es el próximo update.
2. Drop no deja rastro de los datos. Las métricas cuentan cuántos registros se descartaron, pero los registros no están en ningún lado. Si hay chance de que te pidan verlos (auditoría, reclamos, debugging), cuarentena desde el día uno: migrar después implica aceptar que hay un período sin evidencia.
3. En la API nueva, cada tipo de dataset tiene su decorador. Con import dlt, @dlt.table creaba streaming table o materialized view según la query. En from pyspark import pipelines as dp, @dp.table es el decorador para streaming tables (con una query batch todavía crea una materialized view por compatibilidad, pero Databricks recomienda @dp.materialized_view para eso), y @dlt.view pasó a llamarse @dp.temporary_view. El código viejo con import dlt sigue funcionando sin migración.
4. El event log y el billing siguen diciendo “dlt”. El rename a Lakeflow no tocó los schemas: tus queries sobre details:flow_progress y los filtros por usage_metadata.dlt_pipeline_id en las system tables no cambian.
5. Anomaly detection tiene bordes. Sin soporte para views ni foreign tables (las de federation del Tips #15 quedan afuera), requiere serverless disponible en el workspace, y la habilitación masiva a nivel catálogo va de a 50 schemas por operación. Si tu tabla crítica es una foreign table, el monitoreo automático todavía no llega ahí.
6. Data profiling tiene los suyos. Solo tablas Delta, snapshot hasta 4 TB, y los análisis time series e inference computan por defecto solo los últimos 30 días. Para un perfil histórico completo hay que pedirlo explícitamente.
7. El monitoreo se factura como serverless jobs. No tiene SKU propio: comparte el de serverless jobs, y en system.billing.usage lo separás con billing_origin_product = 'DATA_QUALITY_MONITORING'. Habilitarlo en un catálogo entero sigue siendo una decisión de presupuesto, no solo un toggle: empezá por el schema que más duele.
8. DQX rompe API entre releases. Pre-1.0 significa que el changelog es lectura obligatoria. Fijá la versión en tus jobs y actualizá a conciencia, no por arrastre del %pip install sin versión.
9. Cuándo usar cada mecanismo
| Necesitás | Usá |
|---|---|
| Garantía dura a nivel tabla, venga de donde venga la escritura | Constraints de Delta (NOT NULL, CHECK) |
| Validar por registro dentro de un pipeline DLT | Expectations |
| Las mismas reglas en muchos pipelines, sin copy-paste | Reglas en tabla Delta + get_rules() (sección 3) |
| Guardar los inválidos para investigar y reprocesar | Quarantine Pattern (sección 4), o DQX con apply_checks_and_split |
| Validar DataFrames fuera de pipelines: jobs, notebooks, históricos | DQX |
| Saber por qué falló cada fila, regla por regla | DQX |
| Enterarte de que una tabla llegó tarde o incompleta | Anomaly detection |
| Detectar drift en distribuciones o en outputs de modelos | Data profiling |
| Bloquear el downstream cuando la validación falla | Pipelines separados coordinados por un job (las expectations no orquestan) |
Si tuviera que resumir el criterio en una línea: las expectations y DQX validan registros en movimiento, el monitoreo vigila tablas en reposo, y los constraints de Delta son el cinturón de seguridad para lo que se saltó todo lo demás.
Referencias
- Manage data quality with pipeline expectations — Databricks
- Expectation recommendations and advanced patterns
- Python reference: expectations (
dp.expect*) - Data quality monitoring — Unity Catalog
- Anomaly detection (Public Preview)
- Data profiling (ex Lakehouse Monitoring)
- What happened to Delta Live Tables?
- Lakeflow pipelines release notes 2026
- DQX — GitHub (databrickslabs/dqx)
- DQX — documentación oficial
- Delta Lake constraints (NOT NULL / CHECK)
Otros posts de la serie
Si te sirvió este post, mirá los anteriores de Databricks Tips:
- Tips #1: Databricks Asset Bundles — IaC para Databricks
- Tips #2: Delta Lake — las 7 cosas que te hubiera gustado saber
- Tips #3: Unity Catalog — gobernanza que nadie implementa bien
- Tips #4: Structured Streaming — watermarks, triggers y micro-batch
- Tips #5: MLflow + Unity Catalog — del experimento al modelo
- Tips #6: Feature Engineering — features que sobreviven a producción
- Tips #7: Docker en Databricks — contenedores custom
- Tips #8: Jobs & Workflows — streaming y triggers event-driven
- Tips #9: SQL Warehouses — el compute que se prende solo
- Tips #10: AI Gateway — governance centralizada para LLMs
- Tips #11: Lakeflow Declarative Pipelines — pipelines declarativos con calidad built-in
- Tips #12: Photon — el motor C++ que acelera tus queries
- Tips #13: OpenSharing — compartir sin copiar
- Tips #14: Liquid Clustering — el reemplazo de particiones y Z-ORDER
- Tips #15: Query Federation — consultar Postgres y MySQL sin mover datos
Próximo Tips: dbt on Databricks — transformaciones SQL-first sobre el Lakehouse, y qué lugar les queda a las expectations cuando los tests viven en dbt.