Databricks Tips #13: OpenSharing — compartir sin copiar
Databricks Tips
Data Engineering
Delta Lake
Qué hereda OpenSharing de Delta Sharing y qué agrega: zero-copy real, shares a clientes Iceberg como Snowflake y Trino, modelos y agent skills como assets compartibles, storage on-premises conectado al lakehouse. Con la sintaxis SQL para armar tu primer share.
Compartir datos con otra empresa, versión clásica: exportás a CSV, subís a un SFTP, del otro lado alguien baja el archivo, lo importa, y a los tres meses nadie sabe cuál de las cuatro copias es la buena. Versión “moderna”: un pipeline que replica tablas a un bucket del partner, que hay que mantener, monitorear y pagar — por duplicado.
Delta Sharing vino a matar eso en 2021 con una idea simple: el que recibe lee tus datos directo de tu storage, sin copia. En el Data + AI Summit 2026 (junio pasado — las novedades completas las cubrimos en el recap de DAIS 2026) Databricks anunció su evolución: OpenSharing, ahora como proyecto independiente bajo la Linux Foundation, y con un alcance que ya no es solo tablas — modelos, agent skills y datos no estructurados. En este post vemos cómo funciona el protocolo por abajo, la sintaxis real para armar shares hoy, qué agrega OpenSharing y qué estado tiene cada feature (spoiler: no todo es GA).
NotaTL;DR
- OpenSharing es la evolución de Delta Sharing, no un reemplazo: mismo protocolo zero-copy, ahora bajo la Linux Foundation, retrocompatible con lo que ya tengas armado.
- Zero-copy significa que el receptor lee tus archivos Parquet directo de tu object storage con URLs temporales — los datos nunca se duplican ni viajan por un servidor intermedio.
- Lo nuevo que ya es GA: compartir a cualquier cliente Iceberg (Snowflake, Trino) vía el REST Catalog, y credenciales de storage vendidas por el protocolo para performance nativa.
- Lo nuevo en preview/beta: compartir modelos y agent skills, Genie Agents con quotas y controles, tablas Lakebase con su change data feed, SecureConnect para redes corporativas y storage on-premises (MinIO ya es GA).
- ¿Bases on-premise como SQL Server, Oracle, MySQL o Postgres? Por OpenSharing no — para eso está Lakehouse Federation: consultarlas desde Unity Catalog sin replicarlas. Y el SFTP del partner tiene conector administrado en Lakeflow Connect.
- Sigue siendo read-only y zero-copy no es zero-cost: el egress del storage lo pagás vos. La cuenta importa cuando el receptor está en otra región o nube.
1. De Delta Sharing a OpenSharing: qué cambió de verdad
Primero lo que no cambió: el protocolo de datos es el mismo. Si hoy tenés shares de Delta Sharing funcionando, siguen funcionando — OpenSharing es retrocompatible. Lo que cambió es la gobernanza del proyecto y el alcance:
| Delta Sharing (2021–2025) | OpenSharing (2026+) | |
|---|---|---|
| Gobernanza | Proyecto open source liderado por Databricks | Proyecto independiente en la Linux Foundation |
| Qué compartís | Tablas y archivos (Delta, Parquet) | Eso + Iceberg, modelos, agent skills, Genie Agents, datos no estructurados, métricas |
| Quién puede leer | Clientes Delta Sharing (Spark, pandas, Power BI, otro Databricks) | Eso + cualquier cliente Iceberg vía REST Catalog: Snowflake, Trino y compañía |
| De dónde salen los datos | Tu cloud object storage | Eso + on-premises: MinIO (GA) y más partners en camino |
La escala que trae de base no es menor: más de 28.000 receptores de datos activos y un 33% de los shares fluyendo entre plataformas distintas vía conectores abiertos. Amadeus, Atlassian, LSEG, SAP y Stripe están entre los usuarios del protocolo.
Nota
¿Por qué importa que esté en la Linux Foundation? Porque le baja el riesgo de vendor lock-in al que recibe. Adoptar un protocolo de sharing controlado por un solo vendor es incómodo si sos, por ejemplo, un cliente de Snowflake. Con gobernanza neutral, conectarse deja de ser una apuesta por Databricks y pasa a ser una apuesta por un estándar — que es exactamente el argumento que necesitás para convencer al partner del otro lado.
2. Zero-copy: cómo funciona por abajo
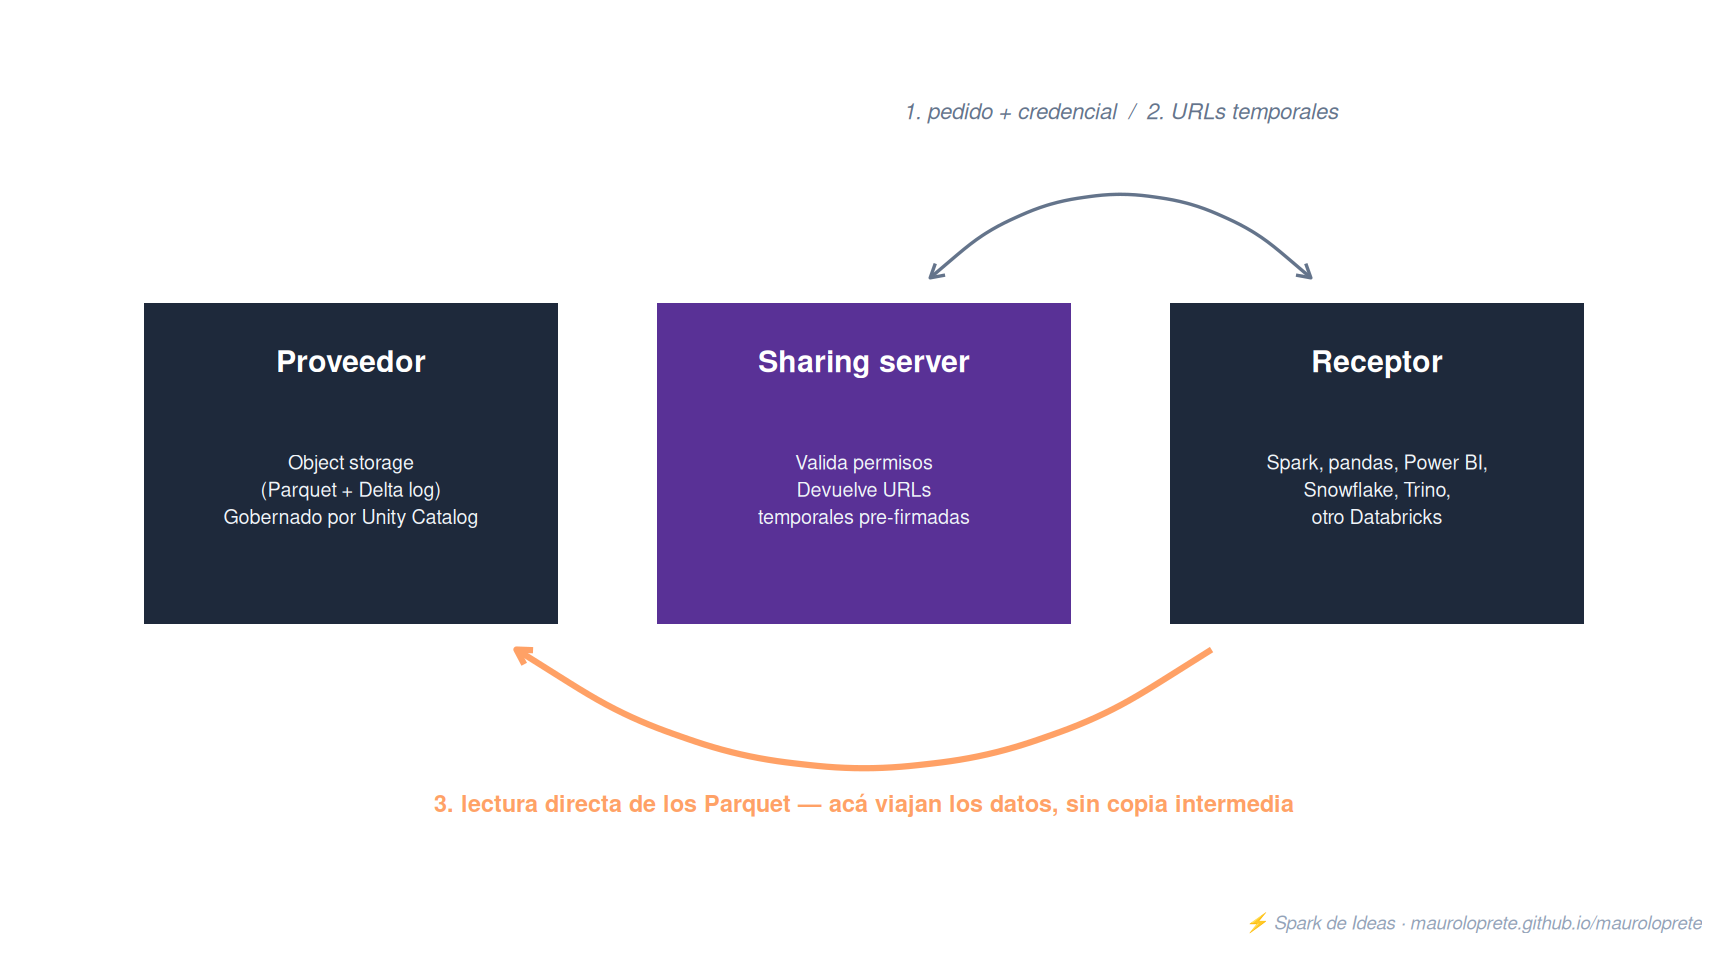
La pieza central del protocolo es que los datos nunca pasan por un servidor intermedio. El flujo tiene tres pasos:
- El receptor le pide una tabla al sharing server del proveedor, autenticándose con su credencial.
- El server valida contra Unity Catalog qué puede ver ese receptor y le devuelve URLs temporales pre-firmadas que apuntan a los archivos Parquet de la tabla, directo en el object storage del proveedor.
- El receptor lee esos archivos directo del storage, con el motor que quiera.
Tres consecuencias prácticas de este diseño:
- No hay copia que se desactualice. El receptor lee la última versión de la tabla, siempre. Si tu MERGE de la mañana actualizó los datos, el partner los ve actualizados a la tarde sin que nadie corra nada.
- Revocar acceso es instantáneo. Sacás el grant y las próximas URLs no se emiten. No hay que “pedir que borren el archivo”.
- El compute lo pone el receptor. Vos no pagás las queries del otro — solo el storage que ya estabas pagando (y el egress, que veremos en los gotchas).
4. El lado del que recibe
En Databricks-to-Databricks, el receptor monta el share como un catálogo más y consulta como si fuera local:
-- Del lado del receptor
CREATE CATALOG ventas_de_partner
  USING SHARE `proveedor-x`.ventas_partner;

SELECT * FROM ventas_de_partner.ventas.transacciones_diarias
WHERE fecha >= '2026-07-01';
En el modo abierto, el receptor descarga un archivo de credenciales (contiene el endpoint del sharing server y un token de acceso) y consume con el cliente que prefiera:
import delta_sharing

perfil = "/ruta/al/archivo/config.share"

# Explorar qué me compartieron
cliente = delta_sharing.SharingClient(perfil)
print(cliente.list_all_tables())

# Leer a pandas (datasets chicos)
df = delta_sharing.load_as_pandas(
    f"{perfil}#ventas_partner.ventas.transacciones_diarias"
)

# Leer con Spark (datasets grandes)
df = (spark.read
      .format("deltaSharing")
      .load(f"{perfil}#ventas_partner.ventas.transacciones_diarias"))
El mismo share se puede leer desde Power BI, Excel, o cualquier herramienta con conector Delta Sharing — y desde 2026, desde cualquier cliente Iceberg. Que es exactamente la sección que sigue.
5. Lo nuevo — Iceberg REST Catalog: compartirle a Snowflake sin pelearse
Hasta ahora, si el receptor vivía en Snowflake, necesitaba el conector de Delta Sharing. Con OpenSharing, el share se expone también vía el Iceberg REST Catalog (la API estándar con la que los motores del ecosistema Iceberg descubren y leen tablas — la sigla que vas a ver es IRC). Traducción: cualquier cliente compatible con Iceberg puede leer tu share como si fuera un catálogo Iceberg, sin instalar nada de Databricks.
Lo que ya está disponible y lo que viene:
| Capacidad | Estado |
|---|---|
| Compartir a cualquier cliente Iceberg (Snowflake, Trino, etc.) | GA |
| Credenciales de storage vendidas por el protocolo (performance nativa, sin proxy) | GA |
| Compartir tablas Iceberg foráneas (registradas en AWS Glue, Snowflake Open Catalog u otro catálogo IRC) | GA anunciada, en camino |
| Tablas Lakebase y su change data feed | Public Preview |
Importante
El detalle técnico que hace la diferencia: las credenciales de storage vendidas por OpenSharing significan que el cliente Iceberg lee los archivos directo del object storage con credenciales temporales — la misma jugada zero-copy de siempre, sin pasar por un servidor que re-sirva los datos. Sin esto, “compatible con Iceberg” sería un eufemismo para “lento”.
NotaDelta vs. Iceberg: qué es cada uno y cuándo se elige cuál
Si te preguntás por qué “compartir una tabla Delta a un cliente Iceberg” tiene sentido siquiera: los dos son formatos de tabla abiertos construidos sobre Parquet. Los datos son archivos Parquet comunes; lo que cada formato agrega es una capa de metadata arriba que aporta transacciones ACID, time travel y evolución de esquema. Las diferencias:
| Delta Lake | Apache Iceberg | |
|---|---|---|
| Origen | Databricks (open source vía delta.io) | Netflix, hoy proyecto Apache |
| Cómo lleva la metadata | Transaction log en _delta_log/ (JSON + checkpoints) junto a los datos |
Snapshots y manifests, coordinados por un catálogo externo |
| Ecosistema más fuerte | Databricks, Spark | Snowflake, Trino, Flink, BigQuery |
| Puntos fuertes | MERGE/upserts de primera, Change Data Feed, streaming nativo con Structured Streaming, y todo el stack de optimización de Databricks (Photon, Liquid Clustering, Predictive I/O) trabaja para este formato | Partition evolution (cambiar el esquema de particionado sin reescribir la tabla) y hidden partitioning (el motor deriva la partición de una expresión — nadie filtra mal por la columna equivocada); neutralidad multi-motor real desde el diseño |
¿Y cuándo se elige cuál en un proyecto de big data?
- Si tu plataforma es Databricks/Spark → Delta, sin vueltas: cada pieza del stack (el motor, el optimizador, las herramientas de mantenimiento) está construida y afinada para ese formato. Elegir otra cosa ahí es remar con el traje puesto.
- Si tu arquitectura es multi-motor por diseño → Iceberg: cuando Trino sirve el ad hoc, Flink el streaming y Snowflake el BI, Iceberg es el único contrato que todos hablan como ciudadano de primera, y el catálogo externo hace de árbitro entre motores.
- Si necesitás re-particionar tablas enormes con frecuencia → Iceberg tiene la ventaja técnica puntual (partition evolution)… aunque Liquid Clustering en Delta ataca el mismo dolor por otro camino: directamente dejar de particionar a mano.
- Si estás en Databricks pero te exigen interoperabilidad → no migres: UniForm expone tus tablas Delta como Iceberg, y con OpenSharing el cliente Iceberg las lee vía el REST Catalog. La respuesta 2026 es que esta guerra se está volviendo irrelevante: abajo son los mismos Parquet, y “compartir Delta a un cliente Iceberg” es traducir metadata, no datos.
Delta lo vimos a fondo en Tips #2.
Si venís siguiendo la interna Delta vs. Iceberg, notá el movimiento: la pelea de formatos se está terminando por arriba, en la capa de protocolo. Compartís una tabla Delta y el otro la lee como Iceberg. El formato de la tabla pasa a ser un detalle de implementación del proveedor.
6. Lo nuevo — AI assets: modelos, agent skills y Genie Agents
Acá está el salto conceptual de OpenSharing: lo que se comparte deja de ser solo datos. El protocolo ahora contempla:
- Modelos de AI: compartir un modelo registrado en Unity Catalog para que el partner lo cargue y lo sirva del otro lado, sin mandarle los weights por WeTransfer. Esto no es promesa de keynote — está documentado y operativo: el modelo se agrega al share como cualquier tabla (necesitás el privilegio
EXECUTEsobre él, y mantenerlo) y el receptor lo carga para inferencia desde su catálogo montado. - Agent skills: la lógica reutilizable de un agente — herramientas, instrucciones, contexto semántico — empaquetada y compartible entre organizaciones. Esta es la parte más “protocolo” y menos “producto” por ahora: figura como capacidad del estándar en el anuncio oficial, con el tooling llegando de a poco.
- Genie Agents (Beta): compartís una experiencia de chat en lenguaje natural sobre tus datos (doc oficial). El detalle técnico que no está en los keynotes: lo que se comparte es un snapshot point-in-time del Genie Space — los data assets y las instrucciones quedan congelados al momento de compartir, y si después modificás el space, el share no se actualiza (todos los receptores ven el mismo snapshot). El receptor monta el share y obtiene un Genie Space local precargado. Dos requisitos concretos: la preview de Genie Agent Sharing habilitada a nivel cuenta, y la configuración del space por debajo de 256 KB comprimida. Este anuncio lo habíamos anticipado en el día 3 de DAIS.
Para el caso Genie, los controles del proveedor son el punto fuerte (y algo que conviene configurar desde el día uno):
- Ocultar las instrucciones propietarias del agente (tu prompt engineering no viaja).
- Restringir el acceso a los datos solo a través del agente — el receptor conversa, no consulta.
- Quota diaria de prompts por receptor.
- Tope de filas exportables en las respuestas.
Advertencia
“Compartir un agente” suena a demo de keynote, pero el caso de uso real es concreto: sos un proveedor de datos y en vez de entregar 40 tablas con un data dictionary de 80 páginas, entregás un agente que las conoce. El costo de onboarding del receptor baja de semanas a una conversación. Eso sí: está en Beta — probalo con un partner amigo antes de venderlo como producto.
7. Lo nuevo — on-premises y SecureConnect
La otra frontera que cruza OpenSharing: los datos ya no tienen que estar en la nube para ser compartibles. Storage on-premises puede conectarse directo al protocolo:
| Partner de storage | Estado |
|---|---|
| MinIO | GA |
| Everpure (ex Pure Storage) | Private Preview |
| Qumulo | Private Preview (julio 2026) |
| VAST Data | Private Preview (agosto 2026) |
| Cohesity, Commvault, HPE, NetApp, Nutanix, Rubrik | Anunciados para fin de 2026 |
¿Y qué es MinIO, el único que ya está GA? Un object storage open source compatible con la API de S3 que corre donde vos quieras: tus propios servidores, un cluster de Kubernetes, un datacenter privado. Es el estándar de facto para tener “un S3 puertas adentro” — las mismas APIs y herramientas del ecosistema cloud, sin nube. Por eso es el partner natural para arrancar: si tus datos on-prem ya viven en MinIO como Parquet o Delta, ya hablan el idioma que el protocolo necesita.
Un ejemplo concreto de cómo queda el flujo, con un caso típico de la región — la empresa que por regulación (o por política interna) no puede subir ciertos datos a la nube:
- El histórico vive como tablas Delta sobre un cluster MinIO en el datacenter propio. Ahí se queda.
- Ese MinIO se registra como fuente de OpenSharing, y las tablas quedan gobernadas por Unity Catalog como cualquier otra.
- Los analistas consultan desde Databricks serverless — o le preguntan a Genie en lenguaje natural — y el motor lee los archivos directo del MinIO con URLs temporales, igual que si fuera un bucket de S3.
- Nada se replicó a la nube: lo que viaja es el resultado de cada query, no el dataset. Y el pipeline de replicación que hoy mantiene alguien del equipo deja de existir.
Y para el dolor de cabeza de conectar redes corporativas, SecureConnect (Public Preview): un proxy administrado por Databricks que elimina la configuración de firewall por receptor. Se configura una vez, y agregar receptores nuevos no requiere tocar reglas de red — que en una empresa grande significa no abrir un ticket a infraestructura por cada partner nuevo.
Completan el combo multi-cloud: Global Distribution (Private Preview) — réplica automática cross-region y cross-cloud para bajar egress y latencia — y sharing entre dominios regulatorios (Public Preview) para compartir entre ambientes Databricks que viven bajo regulaciones distintas.
8. ¿Y mis bases on-premise? Federation, SFTP y el fin de los pipelines de copia
La pregunta que aparece apenas contás esto en una empresa de acá: “tengo un SQL Server (u Oracle, MySQL, PostgreSQL) on-premise con 15 años de historia — ¿lo puedo compartir así?”. Respuesta honesta: por OpenSharing directamente no — el protocolo comparte archivos desde object storage, y tu base relacional no expone Parquet. Pero la pregunta de fondo es otra: “¿puedo laburar con esos datos sin armar pipelines de copia?”. Y ahí la respuesta es sí, con dos piezas que se complementan con OpenSharing:
Lakehouse Federation para bases relacionales: registrás la conexión en Unity Catalog y la base entera aparece como un catálogo más — se consulta sin replicar nada:
-- Una vez: la conexión y el catálogo foráneo
CREATE CONNECTION sqlserver_onprem TYPE sqlserver
  OPTIONS (host 'srv-ventas.interno', port '1433',
           user secret('kv', 'fed-user'), password secret('kv', 'fed-pass'));

CREATE FOREIGN CATALOG ventas_legacy
  USING CONNECTION sqlserver_onprem
  OPTIONS (database 'ventas');

-- Después: SQL normal, sin copiar una fila
SELECT * FROM ventas_legacy.dbo.clientes WHERE alta >= '2026-01-01';
Soporta SQL Server, Oracle, MySQL, PostgreSQL, Snowflake, Redshift, BigQuery y más — todo read-only y gobernado por Unity Catalog. El matiz técnico que importa: acá no hay URLs pre-firmadas. Cada query viaja por JDBC (Java Database Connectivity, el estándar de conectores a bases de datos) hasta la base origen: los filtros y agregaciones se empujan (pushdown) para que los resuelva la base, y el resto del plan lo termina Databricks. Sin réplicas que mantener, pero con un límite claro: si le apuntás 40 dashboards a la base transaccional de producción, el que sufre es el sistema transaccional. Federation es para acceso, exploración e integración — no para volumen analítico sostenido sobre un OLTP (online transaction processing: la base que atiende las operaciones del negocio en vivo).
Lakeflow Connect con conector SFTP para el otro clásico: el partner que “comparte” dejando archivos en un servidor SFTP (Secure File Transfer Protocol — la carpeta compartida remota de toda la vida). El conector administrado hace ingesta incremental con garantía exactly-once, inferencia y evolución de esquema, credenciales gobernadas en Unity Catalog, y lee CSV, JSON, XML, Parquet, Avro y ORC. Acá sí hay copia — es ingesta, no sharing — pero es un conector declarativo, no un pipeline artesanal que alguien tiene que mantener a mano. Y para la dirección contraria — vos dejándole archivos al partner en un SFTP — eso es exactamente lo que OpenSharing viene a jubilar.
¿Y cuál de los caminos conviene para la base on-premise? Porque en realidad son tres, no dos. Además de Federation, OpenSharing habilita un patrón nuevo: tu ETL escribe tablas Delta o Iceberg en un MinIO on-prem, y Databricks las monta como catálogo vía AIStor Table Sharing — la base transaccional se toca una vez por ciclo de carga, y los datos nunca salen del datacenter. Y si los datos sí pueden ir a la nube, la tercera vía es Lakeflow Connect con CDC administrado directo al lakehouse. La tabla de decisión:
| Federation directo | RDBMS → Delta en MinIO → OpenSharing | Lakeflow Connect (CDC a la nube) | |
|---|---|---|---|
| ETL propio que mantener | Ninguno | El pipeline a Delta/Iceberg | Ninguno (conector administrado) |
| Frescura | Estado actual, siempre | La frecuencia de tu pipeline | Near real-time (CDC) |
| Impacto en la base origen | Cada query le pega | Una pasada por ciclo | Lectura continua del change log |
| Performance analítica | Limitada (pushdown parcial) | Columnar completo | Columnar completo |
| ¿Los datos salen del datacenter? | No (viajan resultados, por query) | No | Sí — quedan en el lakehouse |
| Cuándo | Ad hoc, POCs, consultas esporádicas | Consumo pesado + datos que deben quedarse on-prem | Consumo pesado + la nube está permitida |
La regla corta: exploración esporádica → Federation; OLTP que proteger y regulación que ancla los datos on-prem → MinIO + OpenSharing; la nube está permitida → Lakeflow Connect. Y un atajo que aparece seguido: si ya tenés un proceso que baja las bases a Parquet, la mitad del costo del patrón MinIO ya está pagada — pasar de Parquet suelto a Delta y activar Table Sharing es el paso corto.
Tip¿Chau, Data Factory (y las herramientas de mover datos)?
Sumá las tres piezas: Federation consulta las bases sin copiarlas, Lakeflow Connect ingesta lo que sí hay que traer (SFTP incluido, y CDC administrado — captura incremental de cambios — desde SQL Server), y OpenSharing distribuye hacia afuera sin exports. El patrón “Copy Activity + Linked Services + triggers” de Azure Data Factory — que en la práctica es el 80% de los ADF productivos que existen — ya tiene reemplazo nativo completo dentro del lakehouse, con la gobernanza en un solo lugar.
Y no es solo Data Factory: aplica a toda la categoría de herramientas que vivía de ese hueco. Fivetran — durante años el camino recomendado para conectores administrados hacia Databricks, hasta que Lakeflow Connect ocupó ese rol nativo — y también Airbyte, Stitch, o los jobs de Informatica y Talend que solo mueven tablas de un lado a otro. Todas siguen teniendo sentido para orquestar o ingestar por fuera del ecosistema; como copiadoras oficiales de datos hacia y desde el lakehouse, les llegó el retiro.
10. Cuándo usarlo: los tres casos que justifican armarlo hoy
- Compartir con partners externos — el caso obvio. Reemplaza SFTPs, exports programados y buckets espejo. Si hoy tenés un pipeline cuyo único trabajo es copiarle datos a alguien, es candidato directo.
- Multi-org interna — grupos empresariales con varias unidades, cada una con su metastore o su nube. Compartir entre sedes respetando residencia de datos, sin replicación cruzada.
- Monetización — publicar datasets (o agentes, ahora) en Databricks Marketplace, que corre sobre OpenSharing. El receptor accede sin fricción y la distribución la maneja la plataforma.
11. Gotchas
- Zero-copy no es zero-cost: el egress existe. El receptor lee de tu storage — si está en otra región u otra nube, el egress de esas lecturas lo paga tu cuenta de storage. Para shares intensivos cross-cloud, hacé la cuenta antes; Global Distribution (preview) apunta justo a esto.
- Sin
WITH HISTORY, no hay time travel ni CDF del otro lado. Si el receptor necesita leer el change data feed o versiones anteriores, la tabla tiene que estar compartida con historia — y el CDF además tiene que estar habilitado en la tabla antes de compartirla. Ojo con el default: en DBR 16.2+ las tablas se agreganWITH HISTORYpor defecto; en runtimes anteriores, sin historia. - El lifetime de los tokens se configura a nivel metastore — hacelo corto. En recipients del protocolo abierto los tokens valen como máximo un año, pero un año es una eternidad: definí un lifetime corto y rotá. Un token vigente en el mail de alguien que ya no trabaja en el partner es un incidente esperando fecha.
- Features nuevas de Delta pueden romper clientes viejos. Una tabla con deletion vectors o column mapping habilitados exige clientes de sharing que soporten leer en formato Delta. Si tu receptor usa un conector viejo, coordiná versiones antes de habilitar features en la tabla compartida.
- El estado de cada feature importa. De este post: Iceberg clients y credenciales vendidas son GA; SecureConnect y Lakebase sharing, Public Preview; Genie Agent Sharing, Beta; Global Distribution, Private Preview. No armes tu roadmap comercial sobre una private preview.
- Vistas como interfaz, pero ojo con la lógica pesada. Compartir una vista con 14 joins le traslada ese costo de cómputo a cada query del receptor. Para interfaces estables sobre lógica compleja, materializá primero.
- El nombre del share es parte del contrato. El receptor monta el share y referencia sus esquemas y tablas por nombre. Renombrar cosas adentro de un share rompe queries ajenas que no ves ni controlás.
12. Cuándo NO usar OpenSharing
| Situación | Por qué | Alternativa |
|---|---|---|
| Compartir dentro de la misma metastore | Es agregar una capa de indirección innecesaria | GRANT normal de Unity Catalog |
| El receptor necesita escribir | El protocolo es read-only por diseño | Acceso al workspace, o ingesta inversa como pipeline explícito |
| Transferencia one-shot con cambio de dueño | No querés un vínculo vivo, querés entregar y desconectar | DEEP CLONE o export puntual |
| SLA de latencia estricto para un receptor en otra punta del mundo | Cada query cruza regiones; la física no negocia | Réplica regional (o Global Distribution cuando salga de preview) |
| El partner solo acepta “mandame el archivo” | El protocolo requiere que el receptor consuma, no que reciba | Export programado — y una charla sobre 2026 |
Referencias
- What is OpenSharing? — Azure Databricks
- Create shares for OpenSharing
- Create recipients for OpenSharing
- Share a Genie Space using OpenSharing (Beta)
- OpenSharing — página de producto
- Introducing OpenSharing — Databricks Blog
- New OpenSharing and Marketplace capabilities — Databricks Blog
- Databricks storage ecosystem: zero-copy sobre datos on-premises — Databricks Blog
- AIStor Table Sharing: tablas on-prem montadas en Databricks — MinIO Blog
- Press release: Databricks announces OpenSharing
- Lakehouse Federation — Azure Databricks
- Ingest files from SFTP servers — Azure Databricks
- Delta Sharing en GitHub
Otros posts de la serie
Si te sirvió este post, mirá los anteriores de Databricks Tips:
- Tips #1: Databricks Asset Bundles — IaC para Databricks
- Tips #2: Delta Lake — las 7 cosas que te hubiera gustado saber
- Tips #3: Unity Catalog — gobernanza que nadie implementa bien
- Tips #4: Structured Streaming — watermarks, triggers y micro-batch
- Tips #5: MLflow + Unity Catalog — del experimento al modelo
- Tips #6: Feature Engineering — features que sobreviven a producción
- Tips #7: Docker en Databricks — contenedores custom
- Tips #8: Jobs & Workflows — streaming y triggers event-driven
- Tips #9: SQL Warehouses — el compute que se prende solo
- Tips #10: AI Gateway — governance centralizada para LLMs
- Tips #11: Lakeflow Declarative Pipelines — pipelines declarativos con calidad built-in
- Tips #12: Photon — el motor C++ que acelera tus queries sin cambiar código
Próximo post de la serie: Liquid Clustering, el reemplazo de particiones y Z-ORDER.