Databricks Tips #9: SQL Warehouses — el compute que se prende solo
Databricks Tips
Data Engineering
Serverless
Classic, Pro o Serverless: cuál elegir, cómo dimensionarlo y qué gotchas te van a ahorrar plata. Con Photon, Query Federation, AI Functions y costos reales.
Tu equipo corre queries SQL contra el lakehouse. Dashboards, reportes, análisis exploratorio, algo de ETL ligero. Y probablemente lo hace con un cluster All-Purpose prendido todo el día.
Hay una forma mejor.
NotaTL;DR
- Serverless arranca en segundos, se apaga solo y el costo real suele ser menor que Classic (DBU más caro pero sin VMs aparte).
- Photon (C++ vectorizado) viene habilitado por defecto — hasta 12x speedup sin cambiar código.
- Query Federation te deja consultar PostgreSQL, Snowflake y BigQuery sin migrar datos.
- AI Functions aplican LLMs desde SQL puro (
ai_classify,ai_extract,ai_summarize). - Si ves spill to disk en el Query Profile, tu warehouse es chico. Si ves queries en cola, necesitás más capacidad.
0. SQL Warehouses en 2 minutos
Un SQL Warehouse no es un cluster general. Es un endpoint SQL especializado que:
- Corre exclusivamente SQL (no Python, no R, no Scala interactivo)
- Usa Photon por defecto — motor vectorizado en C++ que reemplaza la ejecución JVM
- Tiene concurrency scaling — escala automáticamente ante múltiples queries simultáneas
- Se prende solo cuando llega una query y se apaga solo cuando no hay actividad
- Se integra con Unity Catalog para gobernanza
Cuándo usarlo:
- BI y dashboards (Power BI, Tableau, Looker)
- SQL ETL ligero (
INSERT INTO ... SELECT,MERGE,CTAS) - Analytics ad-hoc (exploraciones SQL desde el editor)
- AI Functions (LLMs desde SQL)
- Query Federation (queries a fuentes externas)
Cuándo NO:
- Streaming continuo (Structured Streaming con
ProcessingTime) - ML training (Spark ML, MLlib, scikit-learn, PyTorch)
- Notebooks Python/R pesados
- ETL complejo con UDFs vectorizadas o pandas UDFs
1. Los 3 tipos: Classic vs Pro vs Serverless
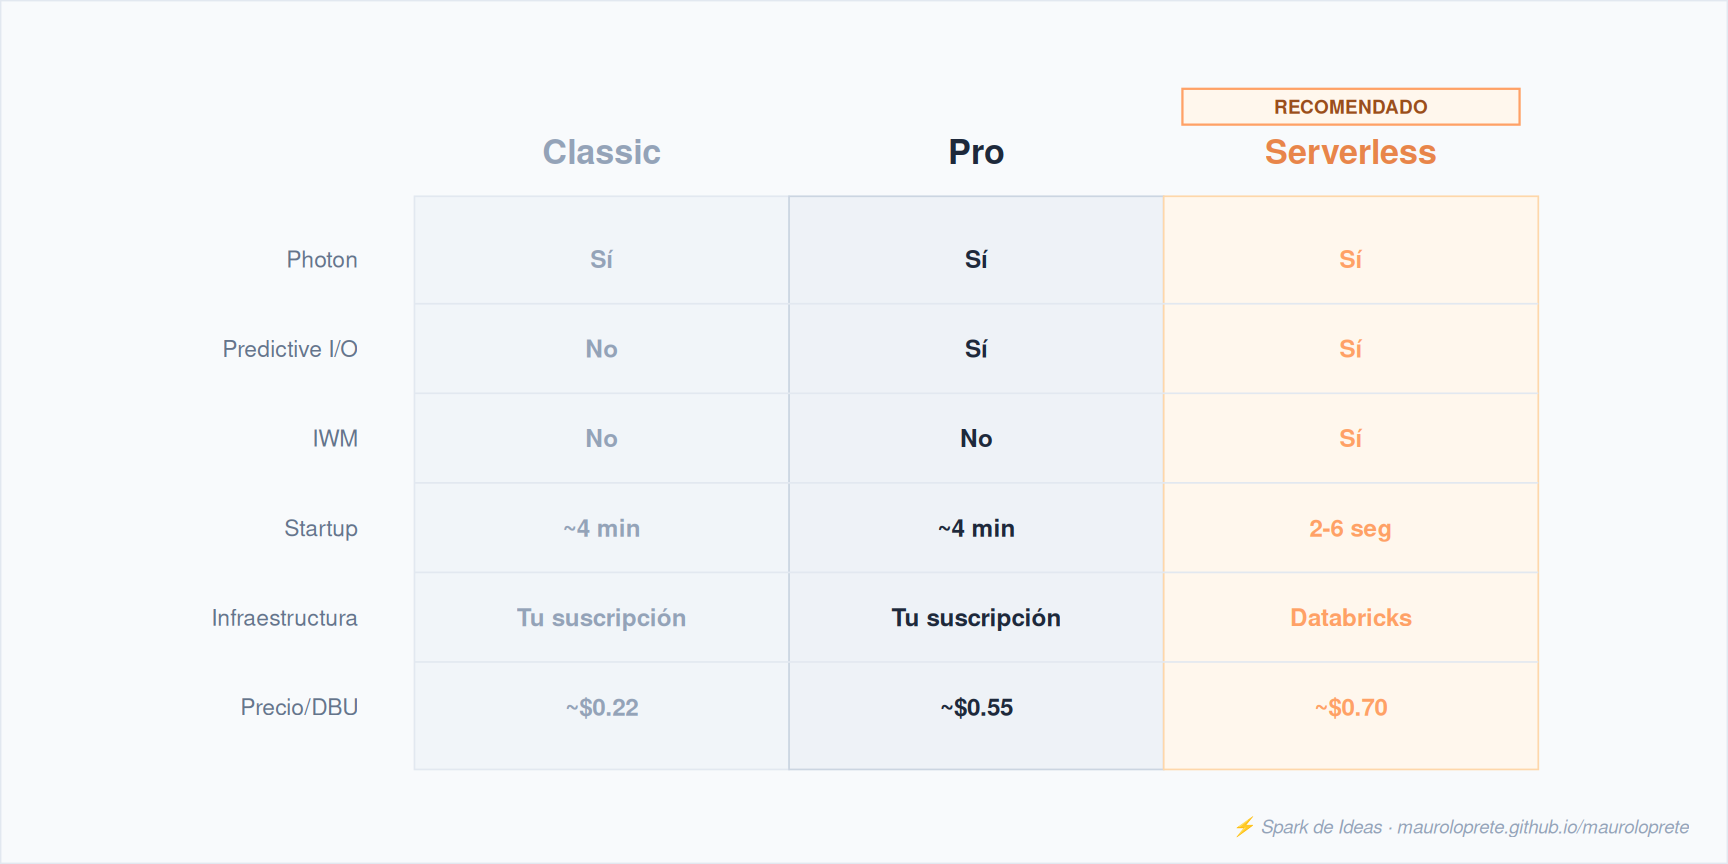
La tabla completa:
| Característica | Classic | Pro | Serverless |
|---|---|---|---|
| Photon | Sí | Sí | Sí |
| Predictive I/O | No | Sí | Sí |
| Intelligent Workload Management | No | No | Sí |
| Startup time | ~4 min | ~4 min | 2-6 seg |
| Infraestructura | Tu suscripción Azure | Tu suscripción Azure | Gestionada por Databricks |
| Spot instances | Sí (configurable) | Sí (configurable) | No aplica |
| Query Federation | No | Sí | Sí |
| AI Functions | No | Sí | Sí |
| Precio DBU (Azure, ref.) | ~$0.22 | ~$0.55 | ~$0.70 |
ImportanteEl precio no es lo que parece
Serverless es más caro por DBU ($0.70 vs $0.22 Classic), pero el precio del DBU incluye la infraestructura. Con Classic/Pro pagás DBU + VMs de Azure por separado. Para workloads intermitentes, el TCO de Serverless suele ser menor.
Cuándo usar cada uno:
- Serverless (por defecto): la mayoría de workloads. Startup instantáneo, scaling inteligente, sin gestión de infra.
- Pro: cuando necesitás VNet injection, conexión on-premises, o Serverless no está disponible en tu región.
- Classic: solo si tenés un Hive metastore externo legacy que no migraste a Unity Catalog.
2. Serverless: por qué cambia las reglas
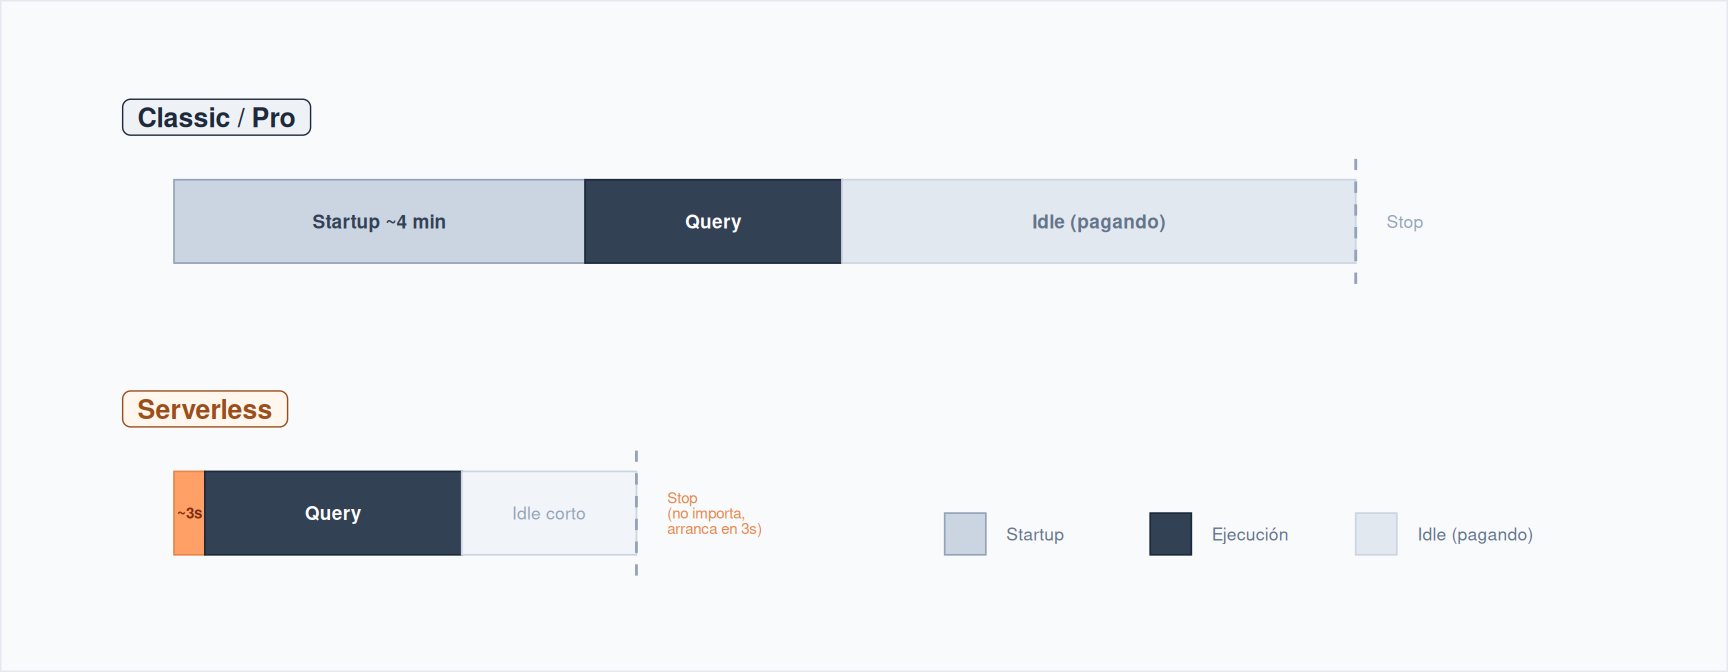
La diferencia entre Classic/Pro y Serverless no es solo el precio. Es un modelo operativo distinto.
Classic/Pro:
- Llega una query → el warehouse estaba apagado → 4 minutos de startup
- La query se ejecuta
- El warehouse queda idle → esperando más queries → pagando por no hacer nada
- Después de 10+ minutos sin actividad → se apaga
Serverless:
- Llega una query → 2-6 segundos de startup
- La query se ejecuta
- Sin queries → se apaga en 5 minutos (y no importa, porque arranca en segundos)
Intelligent Workload Management (IWM)
IWM es exclusivo de Serverless. Usa modelos de ML internos para:
- Predecir los recursos que necesita cada query antes de ejecutarla
- Enrutar la query al cluster con capacidad disponible
- Escalar en segundos si la cola crece (no minutos como Classic/Pro)
- Reducir clusters automáticamente cuando la demanda baja
Con Classic/Pro, el scaling sigue reglas fijas (umbrales estáticos). Con Serverless, es adaptativo.
TipAuto-stop agresivo en Serverless
Configurá auto-stop en 5 minutos sin miedo. Como arranca en 2-6 segundos, el usuario ni se entera. Con Classic/Pro, auto-stop bajo es inaceptable porque el cold start de 4 minutos arruina la experiencia.
3. Photon: el motor que hace la diferencia
Photon es el motor de ejecución vectorizado que Databricks construyó desde cero en C++. Está habilitado por defecto en todos los SQL Warehouses.
Qué hace:
- Optimizador de queries mejorado — mejora el plan de ejecución de Catalyst
- Capa de cache entre la ejecución y el object storage — hasta 5x más rápido en scans
- Ejecución vectorizada nativa en C++ — procesa datos en batches columnares, no fila por fila
Rendimiento reportado:
- Hasta 12x speedup vs otros cloud data warehouses
- Hasta 80% de ahorro en TCO
- Compatible con Spark SQL y DataFrame API — no necesitás cambiar código
NotaPhoton en clusters regulares
Photon también está disponible en clusters All-Purpose y Job Clusters, pero hay que habilitarlo explícitamente. En SQL Warehouses viene activado por defecto.
4. Sizing y concurrency scaling
T-shirt sizes
Los SQL Warehouses se configuran por tamaño, no por cantidad de nodos. Cada tamaño determina la cantidad de workers:
| Tamaño | Workers | Caso de uso típico |
|---|---|---|
| 2X-Small | 1 | Desarrollo, queries simples |
| X-Small | 2 | Equipos chicos, BI ligero |
| Small | 4 | Producción estándar |
| Medium | 8 | Producción con concurrencia media |
| Large | 16 | Producción con alta concurrencia |
| X-Large | 32 | Queries pesadas sobre tablas grandes |
| 2X-Large | 64 | Enterprise, alta concurrencia + tablas grandes |
| 3X-Large | 128 | Enterprise pesado |
| 4X-Large | 256 | Workloads extremos |
TipRegla práctica para sizing
Empezá con un warehouse más grande de lo que pensás necesitar y bajá después. Es más fácil diagnosticar un warehouse que sobra que uno que se queda corto. Monitoreá el spill to disk en el Query Profile como señal de under-sizing.
Concurrency scaling (Classic/Pro)
Classic y Pro escalan con reglas de umbrales fijos:
- 1 cluster por cada 10 queries concurrentes (ratio fijo)
- La lógica de upscaling se basa en la carga estimada:
< 2 min de carga: no escala
2-6 min: +1 cluster
6-12 min: +2 clusters
12 min: +3 clusters y +1 extra cada 15 min
- Si una query espera 5 minutos en cola, se fuerza upscaling
- Downscaling: si la carga es baja por 15 minutos consecutivos, reduce
- Máximo queries en cola: 1.000
Concurrency scaling (Serverless)
Serverless no usa reglas fijas. IWM predice y provisiona dinámicamente:
- Escala en segundos (no minutos)
- No hay ratio fijo de queries por cluster
- El autoscaler se anticipa a la demanda, no reacciona después
5. Query Federation
Query Federation (o Lakehouse Federation) permite ejecutar queries contra fuentes externas sin migrar los datos a Databricks.
Fuentes soportadas
- PostgreSQL, MySQL, SQL Server
- Oracle, Teradata
- Azure Synapse (SQL DW)
- Amazon Redshift
- Snowflake
- Google BigQuery
- Salesforce Data 360
- Otros workspaces de Databricks
Configuración
- Crear una connection en Unity Catalog (credenciales de la fuente externa)
- Crear un foreign catalog que mapea el catálogo remoto
- Consultar tablas externas como si fueran locales:
-- Después de configurar la connection y el foreign catalog
SELECT *
FROM postgres_catalog.public.customers
WHERE country = 'Uruguay'
Requisitos
- SQL Warehouse Pro o Serverless (Classic no soporta federation)
- Unity Catalog habilitado
- Warehouse version 2023.40 o superior
AdvertenciaSin cache para queries federadas
Las queries federadas no usan cache (ni Result Cache ni Disk Cache). Cada ejecución va a la fuente externa. Si consultás la misma tabla externa muchas veces, considerá migrar los datos que necesitás a Delta.
6. AI Functions: LLMs desde SQL
Las AI Functions permiten aplicar modelos de lenguaje directamente desde SQL. Son ideales para enriquecer datos a escala sin salir del warehouse.
Funciones disponibles
| Categoría | Función | Qué hace |
|---|---|---|
| Documentos | ai_parse_document |
Extrae contenido estructurado de documentos |
ai_extract |
Extrae campos con un schema definido | |
ai_classify |
Clasifica texto según labels | |
| Texto | ai_fix_grammar |
Corrige gramática |
ai_translate |
Traduce texto | |
ai_summarize |
Resume texto | |
ai_mask |
Enmascara entidades (PII) | |
| Análisis | ai_analyze_sentiment |
Análisis de sentimiento |
ai_similarity |
Score de similitud semántica | |
| Generación | ai_gen |
Genera texto a partir de prompt |
| Forecast | ai_forecast |
Forecasting de series temporales |
| General | ai_query |
Query a cualquier modelo del Model Serving |
Ejemplo práctico
-- Clasificar tickets de soporte por categoría
SELECT
  ticket_id,
  descripcion,
  ai_classify(descripcion, ARRAY('bug', 'feature_request', 'question', 'billing')) AS categoria
FROM soporte.tickets
WHERE fecha >= '2026-01-01'-- Extraer entidades de texto libre
SELECT
ai_extract(
comentario,
'producto STRING, sentimiento STRING, urgencia STRING'
) AS entidades
FROM feedback.comentarios-- Query a un modelo custom del Model Serving
SELECT ai_query(
'mi_modelo_endpoint',
'Resumí este contrato en 3 bullet points: ' || texto_contrato
) AS resumen
FROM legal.contratos
TipBatching automático
Las AI Functions manejan paralelización, retries y scaling internamente. Enviá el dataset completo en una sola query en vez de dividir en batches manualmente. Databricks optimiza la ejecución.
Costos
- Se registran bajo el producto
MODEL_SERVING(offering typeBATCH_INFERENCE) ai_parse_document,ai_extract,ai_classifyse registran bajoAI_FUNCTIONS- Consultables via system tables de billing
7. Monitoring: Query History y Query Profile
Query History
- Accesible desde sidebar → Query History
- Retiene datos de los últimos 30 días
- Filtros: usuario, rango de fechas, compute, duración, status, tipo de statement
- Para admins: system table
system.query.historycon datos de toda la cuenta
Query Profile
El Query Profile muestra el DAG de ejecución de cada query. Es tu herramienta principal de debugging:
- Top Operators: los operadores más lentos de la query
- Bytes spilled to disk: señal de que el warehouse es chico para esa query
- Rows processed: volumen de datos en cada etapa del plan
ImportanteSeñales de under-sizing
Si ves consistentemente spill to disk en el Query Profile, tu warehouse es demasiado chico. Subí un tamaño o considerá Serverless para que IWM ajuste automáticamente.
Warehouse Monitoring tab
Desde el detalle del warehouse en la UI:
- Running queries: queries ejecutándose ahora
- Queued queries: queries esperando cluster disponible
- Cluster count: cuántos clusters están activos
- Peak Queued Queries: si es consistentemente > 0, necesitás más capacidad
8. Optimización de costos
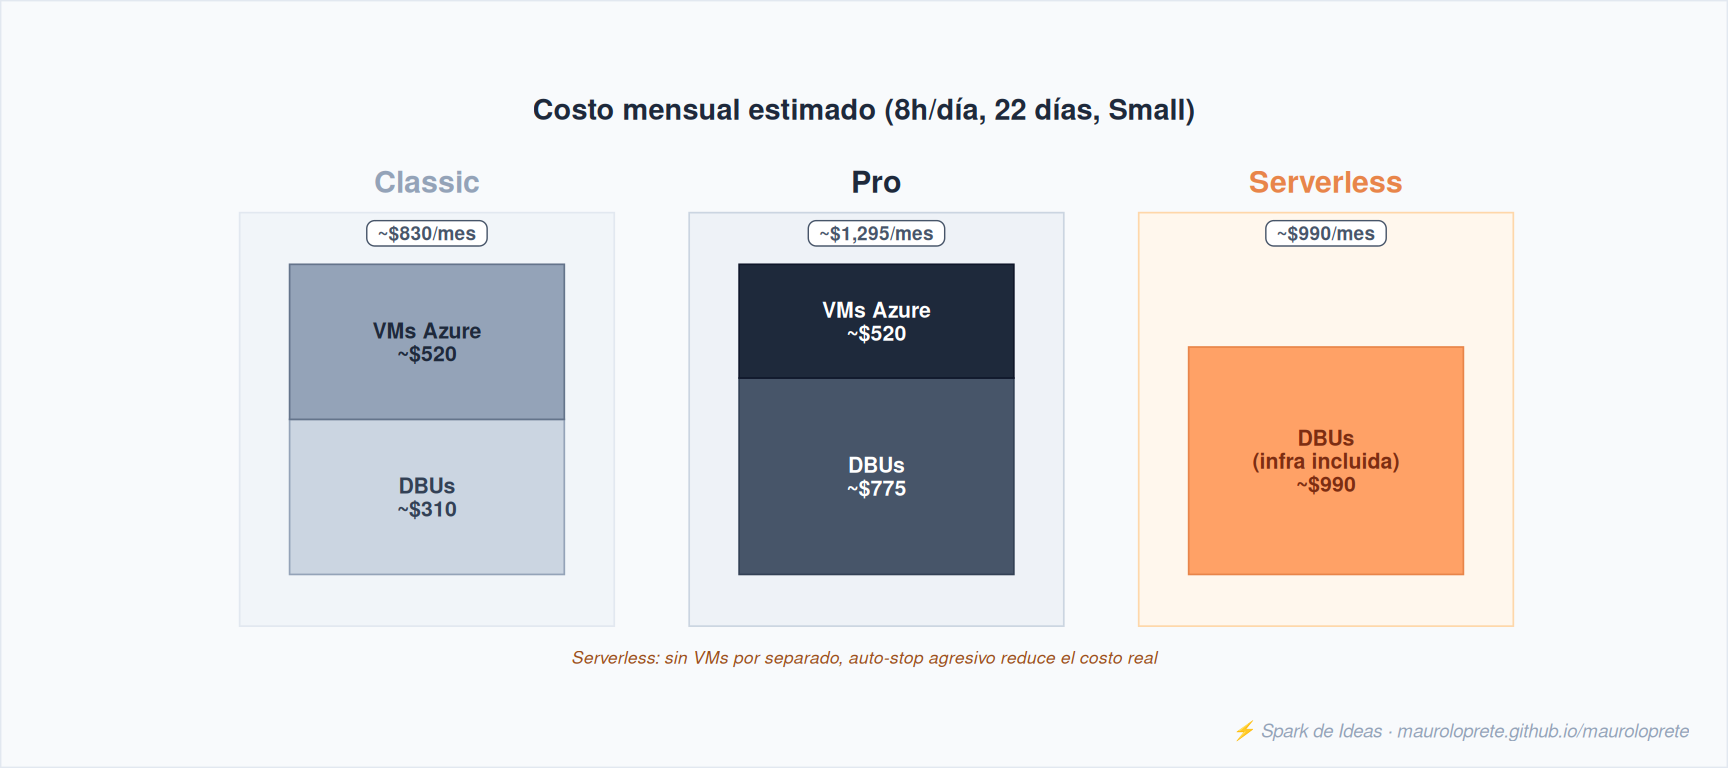
Reglas para optimizar costos
1. Auto-stop agresivo
- Serverless: 5 minutos (mínimo en UI). Arranca en segundos, no impacta.
- Pro/Classic: 10-15 minutos. Cold start de 4 min hace que menos sea impracticable.
2. Right-sizing
- Monitoreá spill to disk en Query Profile → warehouse chico
- Monitoreá Peak Queued Queries en Monitoring tab → necesitás más clusters o más tamaño
- Con Serverless, IWM ajusta dinámicamente — menos micro-management
3. Tagging para cost allocation
Implementá tags a nivel de workspace para rastrear costos por equipo:
Los tags aparecen en las system tables de billing para hacer chargeback por equipo.
4. Queries eficientes
- Filtrá temprano, seleccioná solo columnas necesarias
- Usá
ZORDER/OPTIMIZEen las tablas Delta subyacentes - Evitá
SELECT *contra tablas grandes - Photon ya está habilitado — no necesitás hacer nada extra
9. Serverless Compute para Jobs
Serverless no es solo para SQL Warehouses. Databricks extendió serverless a notebooks, workflows y Lakeflow Declarative Pipelines.
Qué cambia respecto a Job Clusters
| Aspecto | Job Cluster | Serverless Compute |
|---|---|---|
| Configuración | Instance type, workers, autoscaling | Nada — Databricks gestiona todo |
| Startup | 2-5 minutos | Segundos |
| Rendimiento | Depende de tu config | Hasta 80% mejor (auto-sizing) |
| Costo | ~$0.15/DBU + VMs | Todo incluido en DBU |
| Resiliencia | Manual (retry config) | Automática (89% más ejecuciones exitosas) |
Task types soportados
- Notebook, Python script, dbt, Python wheel, JAR
Modos de rendimiento
- Standard: 70% ahorro vs Performance-optimized
- Performance-optimized: para workloads críticos de latencia
NotaRelación con Tips #8
En el post anterior vimos cómo configurar Jobs con triggers event-driven. Serverless Compute para Jobs es el complemento perfecto: triggers que arrancan solos + compute que arranca en segundos = latencia mínima sin cluster 24/7.
10. Gotchas que te van a ahorrar problemas
SQL Warehouses no soportan streaming continuo. Nada de Structured Streaming con
ProcessingTime. Para streaming usá Job Clusters o All-Purpose (ver Tips #8).SQL Warehouses no soportan ML training. No hay Spark ML, MLlib, scikit-learn, PyTorch. Para ML usá Job Clusters con GPU (ver Tips #5 y Tips #6).
Serverless Compute no soporta R. Si tu equipo usa R, necesitás clusters Classic.
Serverless Compute no soporta Spark RDD APIs. Solo Spark Connect APIs (DataFrame, SQL). Si tenés código legacy con RDDs, hay que migrarlo.
No hay
df.cache()ni global temp views en Serverless. Databricks maneja el cache internamente. Reestructurá tu código si depende de estas APIs.Hive metastore externo = no Serverless. Si tu workspace usa un Hive metastore externo en vez de Unity Catalog, Serverless SQL Warehouses no están soportados. Migrá a UC primero.
Cold start de Classic/Pro mata la experiencia interactiva. 4 minutos esperando para correr un
SELECT count(*)es inaceptable para analistas. Usá Serverless o mantené un warehouse mínimo siempre prendido.Standard tier de Azure se retira en octubre 2026. Si estás en Standard, esperá un aumento mínimo del 35% en las rates de DBU. Planificá la migración a Premium.
Solo SQL UDFs en SQL Warehouses. Nada de pandas UDFs ni UDFs vectorizadas. Para transformaciones complejas que requieren Python, usá un Job Cluster.
Query Federation no tiene cache. Cada query a una fuente externa va al origen. Si consultás la misma tabla PostgreSQL 50 veces, considerá ingestarla en Delta.
11. Cuándo NO usar SQL Warehouses
| Necesidad | Usá en su lugar |
|---|---|
| Streaming continuo | Job Cluster + Structured Streaming |
| ML training | Job Cluster con GPU |
| Notebooks Python/R pesados | All-Purpose Cluster |
| ETL con UDFs vectorizadas | Job Cluster |
| Orquestación compleja | Job Cluster + orquestador |
La tabla de decisión completa:
| Aspecto | SQL Warehouse | All-Purpose | Job Cluster |
|---|---|---|---|
| Caso de uso | SQL analytics, BI, dashboards | Desarrollo interactivo | Jobs de producción |
| Lenguajes | SQL | Python, SQL, Scala, R | Python, SQL, Scala, R |
| Optimizado para | Queries SQL concurrentes | Flexibilidad | Ejecución batch |
| Ciclo de vida | Auto-start/auto-stop | Manual o idle timeout | Automático con el job |
| Costo DBU | $0.22-0.70 | ~$0.55 | ~$0.15 |
| Concurrencia | Alta (multi-cluster) | Media | Baja (1 job/cluster) |
| Photon | Siempre | Opcional | Opcional |
| Streaming | No | Sí | Sí |
| ML Training | No | Sí | Sí |
Referencias
- SQL warehouse types — Azure Databricks — Classic vs Pro vs Serverless
- SQL warehouse sizing, scaling, and queuing — T-shirt sizes y concurrency scaling
- What is Photon? — Motor vectorizado C++
- Serverless compute limitations — Lo que no se puede hacer
- Query Federation — Queries a fuentes externas
- AI Functions — LLMs desde SQL
- Query history — Monitoring de queries
- Query profile — DAG de ejecución
- Serverless compute for Jobs — Serverless más allá de SQL
Otros posts de la serie
Si te sirvió este post, mirá los anteriores de Databricks Tips:
- Tips #1: Databricks Asset Bundles — IaC para Databricks
- Tips #2: Delta Lake — las 7 cosas que te hubiera gustado saber
- Tips #3: Unity Catalog — gobernanza que nadie implementa bien
- Tips #4: Structured Streaming — watermarks, triggers y micro-batch
- Tips #5: MLflow + Unity Catalog — del experimento al modelo
- Tips #6: Feature Engineering — features que sobreviven a producción
- Tips #7: Docker en Databricks — contenedores custom
- Tips #8: Jobs & Workflows — streaming y triggers event-driven
Próxima semana: Delta Live Tables — pipelines declarativos con expectations y monitoreo.