Databricks Tips #10: Unity AI Gateway — governance centralizada para LLMs en producción
Databricks Tips
Data Engineering
MLOps
Rate limiting, guardrails, usage tracking, cost attribution, fallbacks y traffic splitting. Todo lo que necesitás para gobernar LLMs en tu organización.
Tu equipo tiene 5 endpoints de LLMs en producción. Marketing usa GPT para clasificar tickets, el equipo legal usa Claude para resumir contratos, data science tiene un modelo fine-tuned para NER. Nadie sabe cuánto está gastando cada uno, no hay límites de uso, y si un modelo externo se cae… bueno, se cae.
Unity AI Gateway es la capa de governance que falta: un punto central para controlar acceso, costos, calidad y resiliencia de todo el tráfico de LLMs en tu organización.
NotaTL;DR
- Un endpoint, múltiples modelos: ruteo, fallbacks y traffic splitting transparentes.
- Rate limiting por endpoint, usuario o grupo — gratis.
- Guardrails con LLMs como evaluadores: PII, contenido unsafe, jailbreak, alucinaciones y custom.
- Usage tracking en
system.ai_gateway.usagecon tokens, latencia y tags de costo. - Cost attribution por equipo, proyecto y modelo vía
system.billing.usage. - API OpenAI-compatible: cambiás la
base_urly listo.
0. Qué es AI Gateway
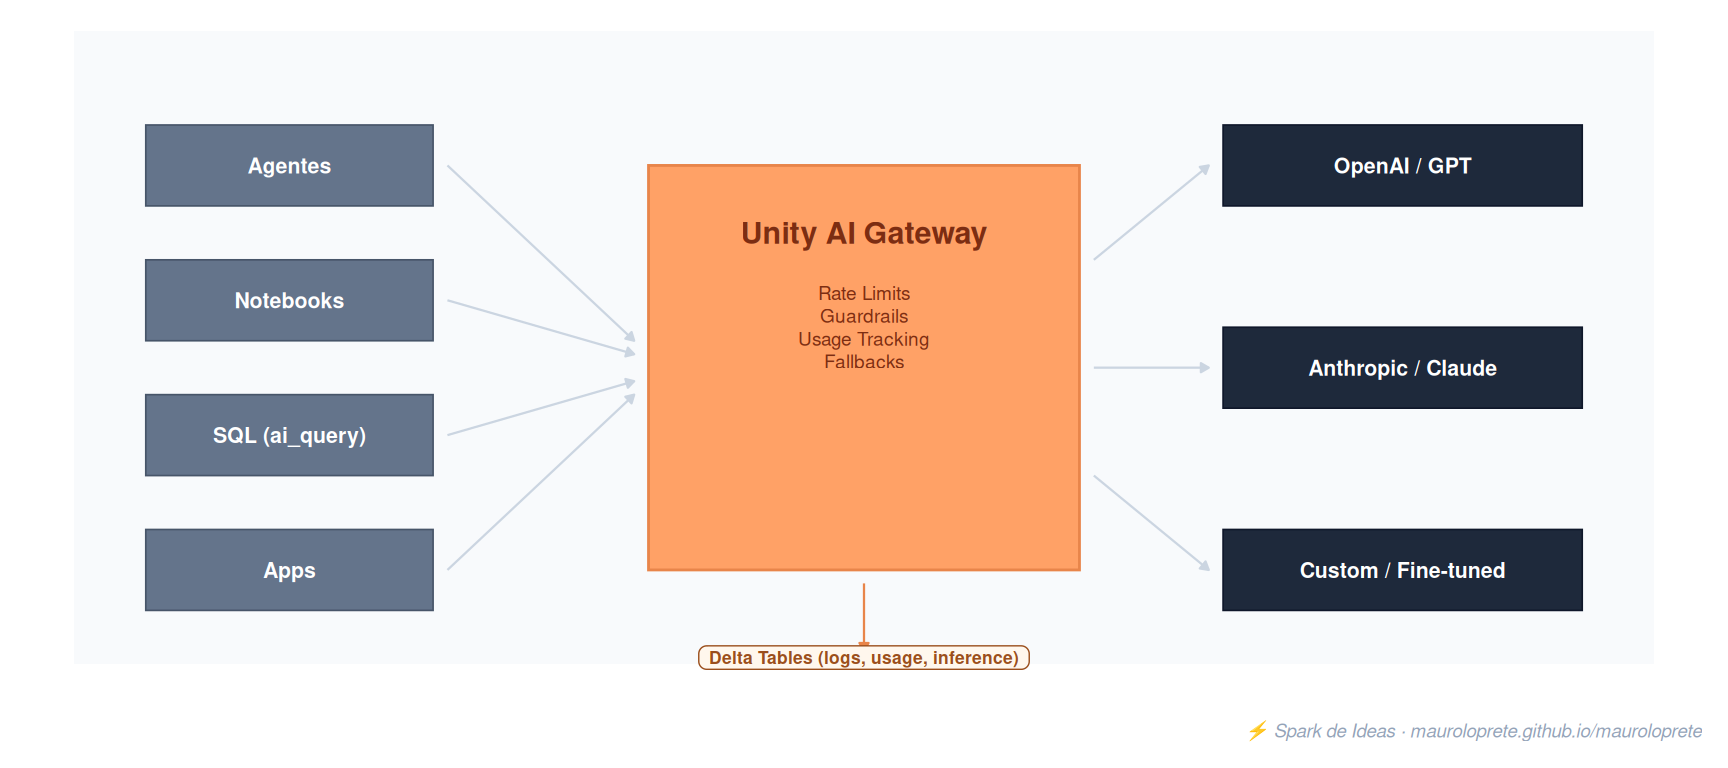
AI Gateway es una capa de proxy entre tus consumidores (agentes, notebooks, apps, SQL) y los modelos de LLM (OpenAI, Anthropic, Google, modelos custom). Todo el tráfico pasa por el gateway, que aplica reglas de governance y loguea todo en Delta Tables dentro de Unity Catalog.
Qué controla:
- Quién puede usar qué modelo (permisos de Unity Catalog)
- Cuánto puede usar cada usuario/grupo (rate limits)
- Qué contenido pasa y qué se bloquea (guardrails)
- Cuánto cuesta cada equipo/proyecto (cost attribution)
- Qué pasa si falla el modelo primario (fallbacks)
1. API OpenAI-compatible
La clave de AI Gateway es que expone una API compatible con OpenAI. Cualquier SDK que soporte OpenAI funciona cambiando solo la base_url:
from openai import OpenAI

client = OpenAI(
    api_key=DATABRICKS_TOKEN,
    base_url="https://<workspace>.azuredatabricks.net/ai-gateway/mlflow/v1"
)

response = client.chat.completions.create(
    model="databricks-claude-sonnet-4",
    messages=[{"role": "user", "content": "Qué es Delta Lake?"}],
    max_tokens=256,
)
print(response.choices[0].message.content)
También soporta las APIs nativas de cada proveedor:
import anthropic

client = anthropic.Anthropic(
    api_key="unused",
    base_url="https://<workspace>.azuredatabricks.net/ai-gateway/anthropic",
    default_headers={
        "Authorization": f"Bearer {DATABRICKS_TOKEN}",
    },
)

message = client.messages.create(
    model="<ai-gateway-endpoint>",
    max_tokens=256,
    messages=[{"role": "user", "content": "Qué es Delta Lake?"}],
)
Proveedores soportados
| Proveedor | Modelos | Auth |
|---|---|---|
| OpenAI | GPT-4o, GPT-5, o-series | API key |
| Anthropic | Claude Opus, Sonnet, Haiku | API key |
| Gemini Pro, Flash | Service account | |
| Meta | Llama 4, Llama 3.x | Hosted por Databricks |
| Amazon Bedrock | Claude, Cohere, AI21 vía AWS | AWS access key |
| Azure OpenAI | GPT vía Azure | API key o Entra ID |
| Custom | Cualquier proxy OpenAI-compatible | Bearer token |
2. Rate Limiting
Rate limiting controla cuántos requests o tokens puede consumir cada usuario o grupo.
Tipos de límites
- QPM (Queries Per Minute): requests por minuto
- TPM (Tokens Per Minute): tokens consumidos por minuto
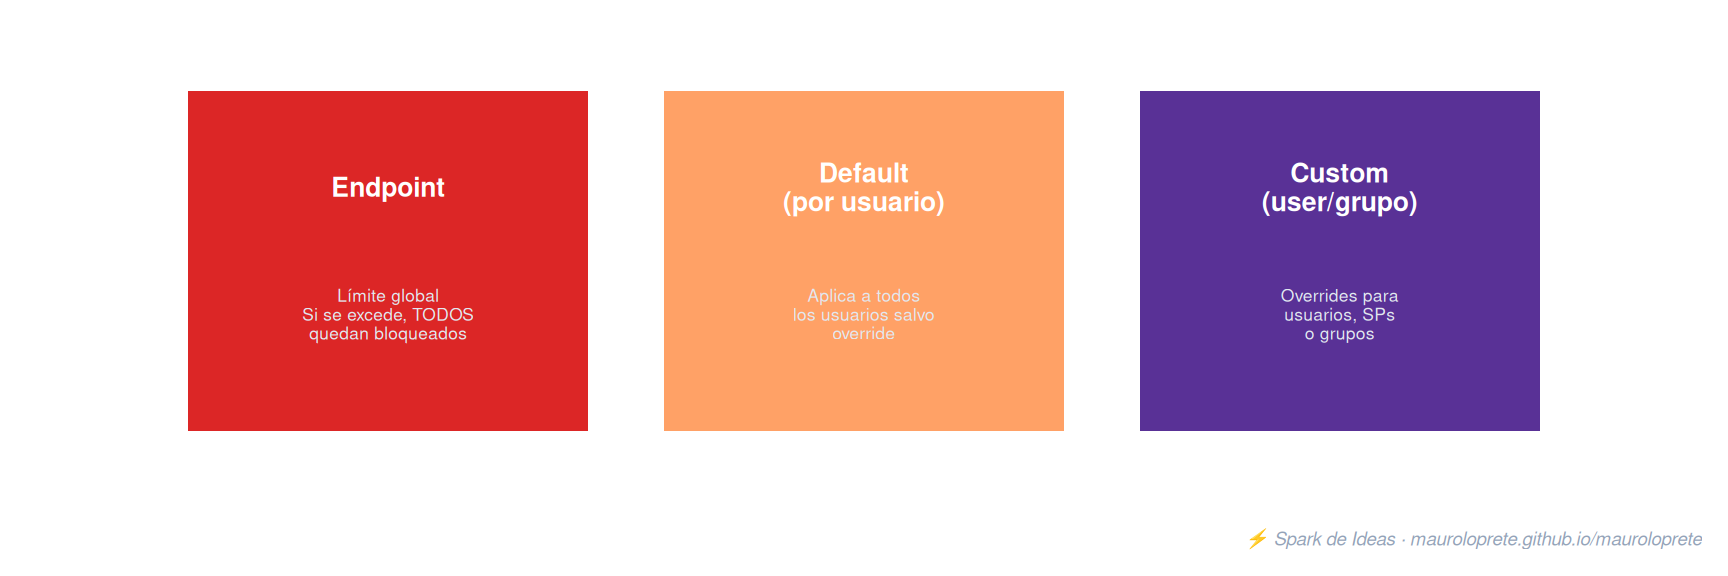
Niveles
| Nivel | Comportamiento |
|---|---|
| Endpoint | Límite global. Si se excede, todos los requests se bloquean |
| Default (user) | Aplica a todos los usuarios, salvo override |
| Custom | Override para usuarios individuales, service principals o grupos |
Reglas clave
- Si un usuario tiene QPM y TPM configurados, se aplica el más restrictivo
- Límites de usuario overridean límites de grupo
- Máximo 20 rate limits y 5 group-specific limits por endpoint
- Requests que exceden el límite reciben HTTP 429 (Too Many Requests)
- Rate limiting es gratis
TipTip: bursts cortos pueden pasar
La implementación puede permitir bursts cortos porque los requests concurrentes se procesan antes de que se actualice el contador de uso. No diseñes asumiendo enforcement exacto al milisegundo.
3. Guardrails: filtrado inteligente de contenido
Los guardrails usan un LLM como evaluador para filtrar contenido en input y/o output. Dos endpoints involucrados: el de inferencia (tu modelo) y el evaluador (el que aplica el guardrail).
Tipos disponibles
| Guardrail | Acción | Fase | Qué hace |
|---|---|---|---|
| PII redaction | Sanitize | Input/Output | Reemplaza PII con [NAME], [EMAIL], etc. |
| PII blocking | Block | Input/Output | Bloquea si detecta PII |
| Unsafe content | Block | Input/Output | Hate speech, violencia, self-harm, contenido sexual |
| Jailbreak | Block | Input | Detecta prompt injection, obfuscación Base64, role-playing |
| Hallucination | Block | Output | Hechos fabricados, estadísticas inventadas |
| Custom | Block/Sanitize | Input/Output | Tu propio prompt evaluador (hasta 5.000 chars) |
Ejemplo de guardrail custom
You are evaluating whether a user message is off-topic for a
customer support assistant for Databricks.

A message is on-topic if it is about:
- Databricks features, pricing, or documentation
- Account, billing, or support issues
- Data engineering or analytics questions

Flag off-topic messages.

Examples:
- "How do I configure Unity Catalog?" -> on-topic, do not flag
- "What's a good recipe for lasagna?" -> off-topic, flag
Comportamiento
- Fail-closed: si el evaluador falla, el request se bloquea (no se puede bypasear por fallas transitorias)
- Dry-run mode: evaluá sin bloquear — útil para testing
- Requests bloqueados retornan HTTP 400
- Máximo 3 blocking + 1 sanitizing guardrail por fase (input/output)
- Timeout: 30 segundos por guardrail
AdvertenciaLimitaciones de guardrails
- No ven el system prompt, turnos anteriores de conversación, tool-call payloads ni imágenes
- Evaluación de mensaje único — no detectan patrones multi-turno
- No soportados con custom model endpoints
- Cada llamada de guardrail se cobra como llamada normal al evaluator endpoint
4. Usage Tracking
Cada request que pasa por AI Gateway se loguea en la system table system.ai_gateway.usage.
Campos clave
| Campo | Tipo | Descripción |
|---|---|---|
endpoint_name |
STRING | Nombre del endpoint |
requester |
STRING | Usuario o service principal |
destination_model |
STRING | Modelo que procesó el request |
input_tokens |
LONG | Tokens de entrada |
output_tokens |
LONG | Tokens de salida |
total_tokens |
LONG | Total tokens |
latency_ms |
LONG | Latencia total |
status_code |
INT | HTTP status |
endpoint_tags |
MAP | Tags del endpoint (team, project) |
request_tags |
MAP | Tags del request individual |
routing_information |
STRUCT | Detalles de fallback attempts |
Queries de análisis
SELECT
  requester,
  destination_model,
  COUNT(*) AS requests,
  SUM(total_tokens) AS total_tokens
FROM system.ai_gateway.usage
WHERE event_time >= current_date() - INTERVAL 30 DAYS
GROUP BY requester, destination_model
ORDER BY total_tokens DESCSELECT
request_tags['project'] AS project,
COUNT(*) AS requests,
SUM(total_tokens) AS total_tokens
FROM system.ai_gateway.usage
WHERE request_tags['project'] IS NOT NULL
GROUP BY request_tags['project']
ORDER BY total_tokens DESC5. Cost Attribution
AI Gateway enriquece system.billing.usage con campos específicos para rastrear cuánto gasta cada equipo:
Queries de costo
SELECT
  usage_metadata.ai_gateway_endpoint_name AS endpoint,
  SUM(usage_quantity) AS dbus
FROM system.billing.usage
WHERE billing_origin_product = 'MODEL_SERVING'
  AND usage_metadata.ai_gateway_endpoint_name IS NOT NULL
  AND usage_unit = 'DBU'
  AND usage_date >= current_date() - INTERVAL 30 DAYS
GROUP BY endpoint
ORDER BY dbus DESCSELECT
usage_metadata.ai_gateway_destination_model AS model,
SUM(usage_quantity) AS dbus
FROM system.billing.usage
WHERE billing_origin_product = 'MODEL_SERVING'
AND usage_metadata.ai_gateway_endpoint_name IS NOT NULL
AND usage_unit = 'DBU'
AND usage_date >= current_date() - INTERVAL 30 DAYS
GROUP BY model
ORDER BY dbus DESCSELECT
custom_tags['team'] AS team,
SUM(usage_quantity) AS dbus
FROM system.billing.usage
WHERE billing_origin_product = 'MODEL_SERVING'
AND custom_tags['team'] IS NOT NULL
AND usage_unit = 'DBU'
AND usage_date >= current_date() - INTERVAL 30 DAYS
GROUP BY team
ORDER BY dbus DESC
ImportanteCostos de modelos externos
Los requests a modelos externos (OpenAI, Anthropic directos con tu API key) se cobran por el proveedor y no aparecen en system.billing.usage. Solo aparecen los costos de DBUs de Databricks. Para tracking completo de modelos externos, usá las inference tables.
6. Fallbacks y Traffic Splitting
Fallbacks
Si el modelo primario falla (429 o 5XX), AI Gateway rutea automáticamente al siguiente modelo en la cadena:
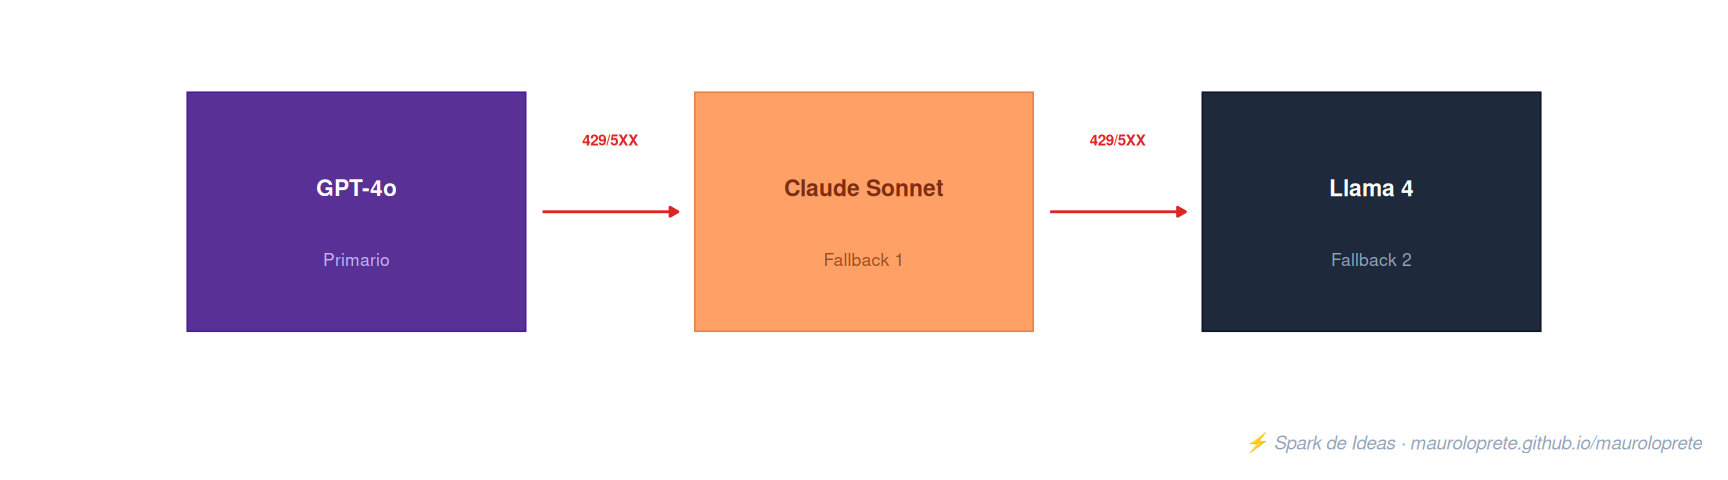
- Se activan ante errores 429 (rate limit) o 5XX (server error)
- Cada fallback se intenta una vez, en orden secuencial
- Si todos fallan, el request falla y se loguea el último error
- Los intentos se registran en
routing_informationde la tabla de usage
Traffic Splitting
Distribuye requests entre múltiples modelos por porcentaje:
| Modelo | Porcentaje | Uso |
|---|---|---|
| GPT-4o | 80% | Modelo principal |
| Claude Sonnet | 20% | A/B testing |
- Los porcentajes deben sumar 100
- Máximo 5 destinations por traffic split
- Casos de uso: A/B testing, gradual rollout, load balancing entre proveedores
Traffic splitting y fallbacks son independientes: el split determina el modelo primario, los fallbacks aplican si ese modelo falla.
7. Inference Tables (Payload Logging)
Las inference tables guardan el request y response completo de cada llamada. Útil para auditoría, debugging y fine-tuning.
Campos clave
| Campo | Tipo | Descripción |
|---|---|---|
request |
STRING | JSON raw del request |
response |
STRING | JSON raw de la respuesta |
latency_ms |
LONG | Latencia total |
status_code |
INT | HTTP status |
requester |
STRING | Quién hizo el request |
sampling_fraction |
DOUBLE | Fracción de sampling (1 = todo) |
Limitaciones
- Solo en external storage catalogs (no default storage)
- Payload máximo: 10 MiB
- Entrega best effort: los logs generalmente disponibles en minutos, no garantizado
- Puede no loguear requests con errores 401, 403, 429, 500
8. External Models: traé tu propia API key
Para usar modelos de proveedores externos con tu propia API key, creás un endpoint de “external model”:
import mlflow.deployments

client = mlflow.deployments.get_deploy_client("databricks")

client.create_endpoint(
    name="claude-via-gateway",
    config={
        "served_entities": [{
            "external_model": {
                "name": "claude-sonnet-4-20250514",
                "provider": "anthropic",
                "task": "llm/v1/chat",
                "anthropic_config": {
                    "anthropic_api_key": "{{secrets/ai/anthropic_key}}"
                },
            }
        }]
    },
)client.create_endpoint(
name="bedrock-claude",
config={
"served_entities": [{
"external_model": {
"name": "claude-v2",
"provider": "amazon-bedrock",
"task": "llm/v1/chat",
"amazon_bedrock_config": {
"aws_region": "us-east-1",
"aws_access_key_id": "{{secrets/aws/access_key}}",
"aws_secret_access_key": "{{secrets/aws/secret_key}}",
"bedrock_provider": "anthropic",
},
}
}]
},
)Las credenciales siempre van vía Databricks Secrets — nunca en plaintext.
9. AI Functions desde SQL
AI Gateway potencia las AI Functions que vimos en Tips #9. Desde SQL puro:
SELECT
  ticket_id,
  ai_classify(
    descripcion,
    ARRAY('bug', 'feature_request', 'billing', 'question')
  ) AS categoria
FROM soporte.tickets
WHERE fecha >= '2026-01-01'SELECT ai_extract(
comentario,
'producto STRING, sentimiento STRING, urgencia STRING'
) AS entidades
FROM feedback.comentariosSELECT
contrato_id,
ai_summarize(texto_contrato) AS resumen
FROM legal.contratos
TipBatching automático
Las AI Functions manejan paralelización, retries y scaling internamente. Enviá el dataset completo en una sola query — Databricks optimiza la ejecución.
10. Permisos y autenticación
Permisos sobre endpoints
| Permiso | Puede hacer |
|---|---|
CAN MANAGE |
Crear, modificar endpoint y configurar AI Gateway |
CAN QUERY |
Consultar el endpoint (esto es lo que necesitan los usuarios finales) |
Autenticación del cliente
- Personal Access Token (PAT) de Databricks como
api_key - El token se pasa como
Authorization: Bearer <token>
Credenciales de external models
- Almacenadas vía Databricks Secrets (referencia
{secrets/scope/key}) - Se borran automáticamente al eliminar el endpoint
11. Gotchas
1. Guardrails no ven el system prompt. Si configurás un guardrail de jailbreak, no puede evaluar el contexto completo de la conversación — solo ve el mensaje del usuario. Ataques que explotan el system prompt no se detectan.
2. Un request puede generar múltiples eventos de billing. Gateway routing + guardrail call + log ingestion = 3 DBU events por un solo request del usuario. Tené esto en cuenta al estimar costos.
3. Updates al config toman 20-40 segundos. Rate limit updates hasta 60 segundos. No esperes enforcement instantáneo después de un cambio.
4. External model costs no aparecen en system.billing.usage. Los costos de OpenAI/Anthropic directos se cobran por el proveedor. Solo los DBUs de Databricks aparecen en billing. Para tracking completo, usá inference tables + request tags.
5. ai_query con AI Gateway Beta tiene limitaciones. Solo captura usage tracking. No aplica rate limits, guardrails, inference tables ni fallbacks. Para governance completa, usá la API directa.
6. Máximo 3 blocking + 1 sanitizing guardrail por fase. Si necesitás más, combiná lógica en un guardrail custom con un prompt más complejo.
7. Guardrails son single-message. No detectan patrones a lo largo de una conversación multi-turno. Un atacante sofisticado puede distribuir un jailbreak en múltiples mensajes.
8. Si el evaluator endpoint pierde acceso al modelo, falla cerrado. El guardrail bloquea todo el tráfico. Elegí evaluadores confiables y monitoreá su disponibilidad.
9. Inference tables solo en external storage catalogs. No podés usar el storage default del workspace. Configurá un external location primero.
10. No disponible en AWS GovCloud ni Azure Government. La disponibilidad regional varía — no todos los modelos están en todas las regiones.
12. ucode: coding agents a través de AI Gateway
ucode es el CLI de Databricks que conecta coding agents con AI Gateway. En vez de configurar API keys por separado para cada herramienta, todos los agentes rutean a través de tu workspace — con las mismas reglas de governance, rate limits y tracking.
Agentes soportados
| Agente | Comando |
|---|---|
| Claude Code | ucode claude |
| Codex (OpenAI) | ucode codex |
| Gemini CLI | ucode gemini |
| GitHub Copilot CLI | ucode copilot |
| OpenCode | ucode opencode |
| Pi | ucode pi |
Instalación
uv tool install git+https://github.com/databricks/ucodeSetup
# Setup interactivo (pregunta workspace y autentica)
ucode configure

# Configurar agentes específicos
ucode configure --agents claude,codex

# Multi-workspace
ucode configure --workspaces https://first.databricks.com,https://second.databricks.com

# Agregar MCP servers de Databricks (SQL, Vector Search, UC Functions)
ucode configure mcp

# Preview sin aplicar cambios
ucode configure --dry-run
Uso
# Lanzar Claude Code
ucode claude

# Resumir sesión anterior
ucode claude -r

# Ver estado y modelos configurados
ucode status

# Ver estadísticas de uso
ucode usage

# Restaurar configs originales
ucode revert
Cómo funciona
ucode configurete pide la URL de tu workspace y autentica con tus credenciales de Databricks- Modifica los archivos de configuración de cada agente (
~/.claude/settings.json,~/.codex/config.toml, etc.) para rutear a través de AI Gateway - Hace backup de los configs existentes antes de modificar
- Todo el tráfico de los coding agents pasa por AI Gateway — con rate limits, usage tracking, cost attribution y guardrails
TipSin API keys separadas
Con ucode, no necesitás API keys de OpenAI, Anthropic ni Google para tus coding agents. Todo se autentica con tus credenciales de Databricks y se gobierna desde AI Gateway.
13. Cuándo NO usar AI Gateway
| Necesidad | Alternativa |
|---|---|
| Latencia ultra-baja (< 50ms overhead) | Llamada directa al proveedor |
| Modelos on-premise sin acceso a internet | Serving endpoint con modelo custom |
| Batch inference masivo sobre tablas | ai_query() desde SQL directamente |
| Fine-tuning / training | Foundation Model Training APIs |
| Workloads sin Unity Catalog | No se puede usar AI Gateway |
Qué es gratis y qué no
| Feature | Costo |
|---|---|
| Permisos + Rate limiting | Gratis |
| Fallbacks | Gratis |
| Traffic splitting | Gratis |
| Usage tracking | Incluido (habilitado por defecto) |
| Guardrails | Se cobra como llamada al evaluator endpoint |
| Inference tables | Se cobra por storage + ingestion |
| Modelos hosted (Foundation Model APIs) | DBUs por token |
| Modelos externos | Cobrados por el proveedor + DBUs de Databricks |
Referencias
Otros posts de la serie
Si te sirvió este post, mirá los anteriores de Databricks Tips:
- Tips #1: Databricks Asset Bundles — IaC para Databricks
- Tips #2: Delta Lake — las 7 cosas que te hubiera gustado saber
- Tips #3: Unity Catalog — gobernanza que nadie implementa bien
- Tips #4: Structured Streaming — watermarks, triggers y micro-batch
- Tips #5: MLflow + Unity Catalog — del experimento al modelo
- Tips #6: Feature Engineering — features que sobreviven a producción
- Tips #7: Docker en Databricks — contenedores custom
- Tips #8: Jobs & Workflows — streaming y triggers event-driven
- Tips #9: SQL Warehouses — el compute que se prende solo
- Tips #11: Lakeflow Declarative Pipelines — pipelines declarativos con calidad built-in
Próxima semana: Secrets & Security — manejo de credenciales, RBAC y buenas prácticas de seguridad.