Databricks Tips #15: Query Federation — consultar Postgres y MySQL sin mover datos
Databricks Tips
Data Architecture
Cómo consultar Postgres y MySQL desde Databricks sin mover datos: connection y foreign catalog en Unity Catalog, qué parte de la query se empuja a la base origen y cómo verificarlo con EXPLAIN FORMATTED, más el criterio para decidir entre federar, ingestar o materializar.
Te piden cruzar las ventas del lakehouse con la tabla de clientes que vive en un Postgres transaccional que nadie va a migrar jamás. Hoy eso se resuelve de dos maneras, las dos malas: un dump nocturno que siempre llega viejo, o un spark.read.jdbc con las credenciales pegadas en el notebook, invisible para la gobernanza y para el colega que hereda el pipeline.
Lakehouse Federation es la tercera opción: ese Postgres (o MySQL, Oracle, SQL Server, Redshift, Snowflake, BigQuery) aparece en Unity Catalog como un catálogo más. Lo consultás con SQL normal, le aplicás los mismos GRANT que a cualquier tabla, y no movés un byte. En este post vemos cómo montarlo en tres comandos, qué pasa por dentro cuando ejecutás una query, qué parte del trabajo se empuja a la base origen, y el criterio para decidir cuándo federar y cuándo no.
NotaTL;DR
- Lakehouse Federation espeja una base externa como foreign catalog en Unity Catalog: la consultás como cualquier tabla, con permisos finos por tabla, y siempre en solo lectura.
- El setup son tres comandos:
CREATE CONNECTION(credenciales consecret(), como recomienda la doc),CREATE FOREIGN CATALOGy losGRANTde siempre. - El motor empuja filtros, proyecciones y agregados a la base origen (pushdown) y procesa el resto de su lado.
EXPLAIN FORMATTEDmuestra hasta el SQL literal que viaja a la base (la líneaExternal engine query). - No hay caché: cada query pega en la base origen, y el resultado vuelve por un solo stream a un solo executor. Con result sets grandes eso significa riesgo de OOM (out of memory, quedarse sin memoria).
- Federar va bien para exploración y consultas ad hoc. Para volumen recurrente conviene ingestar con Lakeflow Connect, y el punto medio son las materialized views sobre tablas federadas.
1. El problema: los datos que te piden viven en otra base
En casi toda empresa hay un sistema operacional (el ERP, el core, el CRM casero) montado sobre un Postgres o un MySQL que funciona bien, tiene dueño, y no está en ningún roadmap de migración. Pero los análisis que te piden necesitan esos datos hoy.
Las soluciones clásicas envejecieron mal:
- El dump programado: un job copia las tablas cada noche a la zona bronze. Funciona, pero duplica almacenamiento, llega con horas de atraso, y cada tabla nueva es un cambio en el pipeline. Para datos que consultás dos veces al mes, es pagar peaje todos los días.
spark.read.jdbcdirecto: el clásico notebook conhost,userypasswordhardcodeados. Sin gobernanza, sin control de quién accede a qué, credenciales regadas por el workspace, y cada consumidor reinventa la conexión.
Lakehouse Federation cubre justo ese hueco: acceso en vivo, gobernado y declarativo a bases que no vas a mover.
2. Qué es Lakehouse Federation (y por qué son dos cosas distintas)
El nombre “Lakehouse Federation” agrupa dos mecanismos distintos, y conviene no mezclarlos:
- Query federation es la que aplica a Postgres y MySQL: tu query (o la parte empujable) viaja a la base origen por JDBC (Java Database Connectivity, el protocolo estándar con el que las aplicaciones hablan con bases de datos) y se ejecuta allá. El trabajo se reparte entre la base origen y tu warehouse.
- Catalog federation no manda queries a ningún motor externo: lee los archivos de la tabla directo del object storage con cómputo Databricks. Está pensada para migraciones incrementales desde un Hive Metastore legacy (HMS, el catálogo de la era pre Unity Catalog), AWS Glue o Snowflake.
Todo lo que sigue en este post es query federation. Los conectores disponibles: MySQL, PostgreSQL, Oracle, SQL Server, Teradata, Amazon Redshift, Azure Synapse, Snowflake, Google BigQuery, Salesforce Data 360, y hasta otro workspace Databricks.
TipLa otra cara de OpenSharing
Federation trae datos de afuera sin copiarlos; Delta Sharing y los formatos abiertos los comparten hacia afuera sin copiarlos. Es la misma idea en las dos direcciones: el dato se queda donde vive, y lo que viaja es la consulta, no el archivo.
3. Setup en tres comandos
El setup crea dos objetos asegurables de Unity Catalog: una connection (host, puerto y credenciales) y un foreign catalog que espeja la base externa. Después gobiernan los GRANT de siempre, los mismos que ya usás para el resto del catálogo.
-- 1. La connection: host + credenciales. Databricks recomienda
--    pasar las credenciales con secret(), no como texto plano.
CREATE CONNECTION pg_operacional TYPE postgresql
OPTIONS (
  host 'ep-cool-water-123456.us-east-2.aws.neon.tech',
  port '5432',
  user secret('lab-federation', 'pg-user'),
  password secret('lab-federation', 'pg-password')
);

-- 2. El foreign catalog: espeja UNA database del servidor.
CREATE FOREIGN CATALOG pg_ventas
USING CONNECTION pg_operacional
OPTIONS (database 'neondb');

-- 3. Permisos finos, como en cualquier catálogo de UC.
GRANT USE CATALOG, USE SCHEMA, SELECT
ON CATALOG pg_ventas TO `data-analysts`;
Listo: SELECT * FROM pg_ventas.public.orders LIMIT 10 y estás leyendo el Postgres en vivo.
ImportanteLa trampa Postgres vs MySQL
En Postgres, el foreign catalog espeja una database (la opción database del paso 2 es obligatoria); si necesitás otra database del mismo servidor, es otro catálogo sobre la misma connection. En MySQL esa opción no hace falta y la sintaxis documentada ni la incluye, porque MySQL usa un namespace de dos niveles: en la práctica, las databases del servidor quedan expuestas como schemas del catálogo. La única opción de catálogo documentada en MySQL es tinyInt1isBit (cómo interpretar columnas tinyint(1)), y además SSL es obligatorio (Secure Sockets Layer, la conexión cifrada) para crear la conexión.
AdvertenciaLos nombres se aplanan a minúsculas
Unity Catalog pasa los nombres de schemas y tablas a minúsculas al espejarlos. Dos consecuencias silenciosas: si tenés Orders y orders en la base origen, no hay garantía de cuál queda; y los nombres inválidos para UC directamente se ignoran sin avisar al crear el catálogo. Si una tabla “no aparece”, empezá por acá.
4. Cómo funciona por dentro
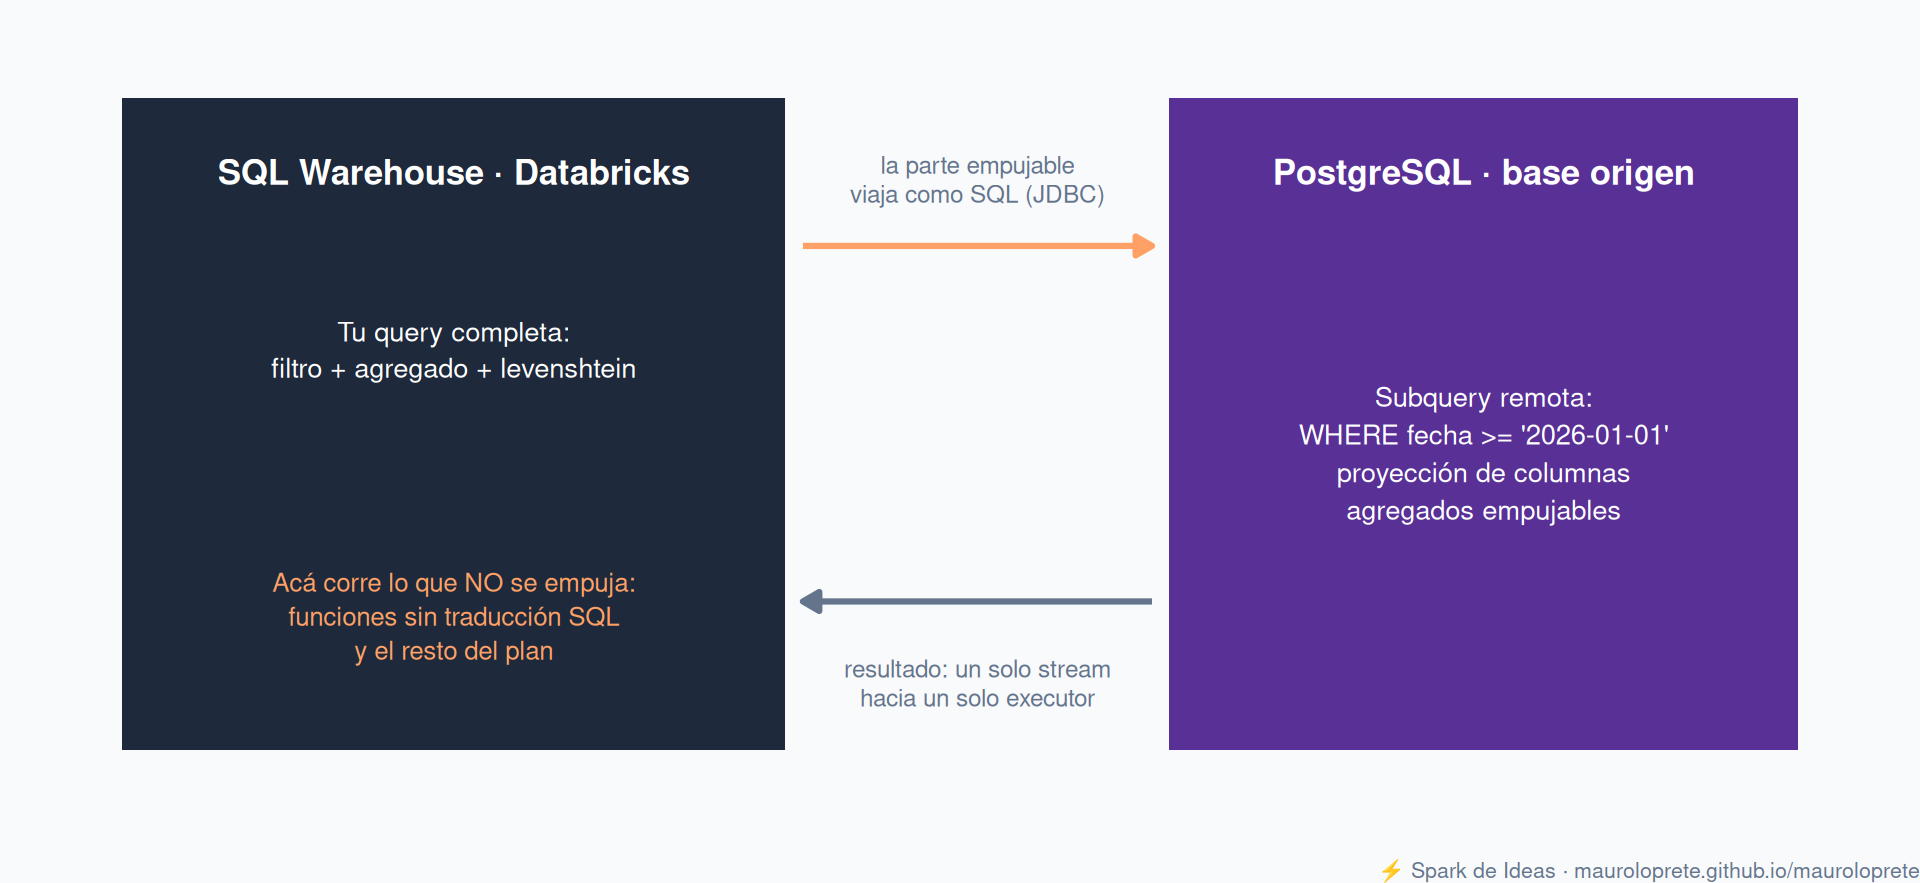
Cuando ejecutás una query que toca una tabla foránea, Databricks no “copia la tabla y filtra”: arma una subquery remota por cada tabla foránea del plan, la manda por JDBC, y la base origen la resuelve. Lo que la base responde vuelve al warehouse para el resto del plan.
Tres consecuencias prácticas de este diseño:
- El resultado vuelve por un único stream a un solo executor. Si la subquery remota devuelve millones de filas, ese executor se puede quedar sin memoria. Agrandar el cluster no ayuda: el cuello es el stream, no el cómputo.
- No hay caché. Ni el Result Cache ni el Disk Cache aplican a queries federadas: cada ejecución pega en la base origen. El dashboard que se refresca cada 5 minutos le pega a tu Postgres transaccional cada 5 minutos.
- La performance la pone la base origen, no el warehouse. Photon acelera lo que corre de tu lado del JDBC: en el lab de la sección 6, las etapas locales del plan aparecen como
PhotonFilteryPhotonProject. Pero lo que tarda la base en resolver la subquery remota no lo acelera ningún cluster.
5. Pushdown: qué viaja a la base y qué se queda
El pushdown es la clave de que esto sea usable: en vez de traer la tabla y filtrar acá, el motor traduce a SQL de la base origen todo lo que puede y lo empuja. Para Postgres y MySQL se empujan, en cualquier cómputo:
- Filtros (
WHERE) y proyecciones (leer solo las columnas que pedís) - Agregados (
GROUP BY,count,sum, …) LIMITyOFFSET, y el ordenamiento cuando acompaña a un limit- Operadores booleanos y aritméticos (los aritméticos piden el modo ANSI habilitado)
- Funciones de string, fecha y matemáticas, con soporte parcial y solo dentro de expresiones de filtro
¿Y qué no? Lo que el motor no sabe traducir al SQL de la base. Igual, ojo con tomar las listas de la doc al pie de la letra: el pushdown mejora con cada canal del warehouse, y la lista que cuenta es la que muestra el plan de tu query. En el lab de la sección 6 me pasó con un ejemplo sacado de la doc.
Un ejemplo que hoy sí se queda del lado Databricks: levenshtein(), la distancia de edición entre dos strings (cuántas letras hay que cambiar para convertir una en la otra). Spark la trae built-in, pero Postgres solo la tiene vía extensión, así que no hay traducción posible.
TipEl truco del AND
El pushdown no es todo o nada: en un filtro compuesto con AND, la parte empujable viaja aunque la otra no. En el lab, WHERE fecha >= '2026-01-01' AND levenshtein(cliente, 'cliente_42') <= 1 genera una subquery remota que lleva el filtro de fecha (la base devuelve solo esas filas) y un PhotonFilter local que se queda con el levenshtein. Ordenar tus filtros para que la parte selectiva sea empujable cambia el volumen que cruza el cable.
6. El lab: dos queries contra un Postgres
El experimento es simple: una tabla de 5 millones de filas en un Postgres, una query que se empuja entera, otra que no, y el plan de cada una para ver la diferencia. El Postgres lo pone Neon, que regala uno serverless con endpoint público y sin pedir tarjeta. En spark-de-ideas-labs/tips/query-federation está todo: el paso a paso para crear la base por UI o por CLI, los SQL y las salidas de referencia.
Paso 1: la base. Creá un proyecto en Neon y, en su editor SQL, generá una tabla de órdenes con datos sintéticos:
CREATE TABLE orders AS
SELECT
  g AS order_id,
  'cliente_' || (g % 1000) AS cliente,
  (ARRAY['web','app','tienda'])[1 + g % 3] AS canal,
  DATE '2025-01-01' + (g % 540) AS fecha,
  round((random() * 900 + 100)::numeric, 2) AS monto
FROM generate_series(1, 5000000) AS g;
Paso 2: secretos y connection. Guardá las credenciales de Neon en un secret scope y creá la connection y el catálogo con el DDL de la sección 3 (Neon exige SSL, igual que MySQL).
databricks secrets create-scope lab-federation
databricks secrets put-secret lab-federation pg-user
databricks secrets put-secret lab-federation pg-password
Paso 3: las dos queries. Una con filtro y agregado empujables, y otra con levenshtein, que no tiene traducción:
-- A: el filtro de fecha y el agregado se empujan
EXPLAIN FORMATTED
SELECT canal, count(*) AS ordenes
FROM pg_ventas.public.orders
WHERE fecha >= '2026-01-01'
GROUP BY canal;

-- B: levenshtein no se traduce; el filtro corre de este lado
EXPLAIN FORMATTED
SELECT *
FROM pg_ventas.public.orders
WHERE levenshtein(cliente, 'cliente_42') <= 1;
El plan de la query A, corrido contra el Neon del lab en un warehouse serverless, tal cual lo devuelve EXPLAIN FORMATTED:
== Physical Plan ==
PhotonResultStage (5)
+- PhotonColumnarToRow (4)
   +- PhotonProject (3)
      +- PhotonRowToColumnar (2)
         +- * Scan JDBC v1 Relation from v2 scan pg_ventas.public.orders (1)


(1) Scan JDBC v1 Relation from v2 scan pg_ventas.public.orders [codegen id : 1]
Output [2]: [canal#13500, count#13501L]
Arguments: [canal#13500, count#13501L], [StructField(canal,StringType,true), StructField(count,LongType,true)], PushedDownOperators(Some(org.apache.spark.sql.connector.expressions.aggregate.Aggregation@248ae007),None,None,None,List(),ArraySeq(fecha IS NOT NULL, fecha >= 20454),List(),Some(pg_ventas.public.orders)), JDBCRDD[706] at $anonfun$withExecutionPhase$1 at AttributionContext.scala:349, JDBC v1 Relation from v2 scan, `pg_ventas`.`public`.`orders`, Statistics(sizeInBytes=8.0 EiB, ColumnStat: N/A)
External engine query: SELECT "canal",COUNT(*) FROM "public"."orders"  WHERE ("fecha" IS NOT NULL) AND ("fecha" >= '2026-01-01') GROUP BY "canal"

(2) PhotonRowToColumnar
Input [2]: [canal#13500, count#13501L]

(3) PhotonProject
Input [2]: [canal#13500, count#13501L]
Arguments: [canal#13500, count#13501L AS ordenes#13477L]

(4) PhotonColumnarToRow
Input [2]: [canal#13500, ordenes#13477L]

(5) PhotonResultStage
Input [2]: [canal#13500, ordenes#13477L]


== Photon Explanation ==
The query is fully supported by Photon.
La línea que vale el post entero es External engine query: el SQL literal que viaja a Postgres. El nodo de scan cuenta lo mismo en PushedDownOperators: ahí van el agregado y los filtros empujados, con la fecha convertida a 20454 (días desde 1970-01-01). Filtro y agregado se fueron enteros al otro lado: Postgres agregó 1,6 millones de filas allá y por el cable cruzaron tres filas:
tienda | 546281
app    | 537022
web    | 537022
En la query B el plan cambia de forma: aparece un PhotonFilter local con el levenshtein, y la subquery remota viaja casi pelada, con el WHERE reducido a lo único traducible:
== Physical Plan ==
PhotonResultStage (5)
+- PhotonColumnarToRow (4)
   +- PhotonFilter (3)
      +- PhotonRowToColumnar (2)
         +- * Scan JDBC v1 Relation from v2 scan pg_ventas.public.orders (1)


(1) Scan JDBC v1 Relation from v2 scan pg_ventas.public.orders [codegen id : 1]
Output [5]: [order_id#13513, cliente#13514, canal#13515, fecha#13516, monto#13517]
Arguments: [order_id#13513, cliente#13514, canal#13515, fecha#13516, monto#13517], [StructField(order_id,IntegerType,true), StructField(cliente,StringType,true), StructField(canal,StringType,true), StructField(fecha,DateType,true), StructField(monto,DecimalType(38,18),true)], PushedDownOperators(None,None,None,None,List(),ArraySeq(cliente IS NOT NULL),List(),Some(pg_ventas.public.orders)), JDBCRDD[707] at $anonfun$withExecutionPhase$1 at AttributionContext.scala:349, JDBC v1 Relation from v2 scan, `pg_ventas`.`public`.`orders`, Statistics(sizeInBytes=8.0 EiB, ColumnStat: N/A)
External engine query: SELECT "order_id","cliente","canal","fecha","monto" FROM "public"."orders"  WHERE ("cliente" IS NOT NULL)

(2) PhotonRowToColumnar
Input [5]: [order_id#13513, cliente#13514, canal#13515, fecha#13516, monto#13517]

(3) PhotonFilter
Input [5]: [order_id#13513, cliente#13514, canal#13515, fecha#13516, monto#13517]
Arguments: (levenshtein(cliente#13514, cliente_42, None) <= 1)

(4) PhotonColumnarToRow
Input [5]: [order_id#13513, cliente#13514, canal#13515, fecha#13516, monto#13517]

(5) PhotonResultStage
Input [5]: [order_id#13513, cliente#13514, canal#13515, fecha#13516, monto#13517]


== Photon Explanation ==
The query is fully supported by Photon.
Acá Postgres devuelve la tabla entera (5 millones de filas por el single stream de la sección 4) y el warehouse filtra después. Misma tabla, mismo catálogo, y una query cuesta tres filas de tráfico mientras la otra cuesta cinco millones. La misma información está en el Query Profile de la UI, en el nodo de scan: por ahí conviene empezar cuando una query federada “anda lenta”.
NotaLa doc dice una cosa; el plan muestra otra
Este lab tenía preparada la query B con ILIKE (el LIKE que ignora mayúsculas y minúsculas), que es el ejemplo de filtro no empujable que da la propia doc. Al correrla, el motor lo reescribió como LOWER("cliente") LIKE '%tech%' y lo empujó igual. Verificá contra tu plan, no contra la doc.
7. Las perillas del tuning
Tres perillas, de la que más rinde a la que más pide:
fetchSize: cuántas filas trae cada round trip de JDBC. Por defecto, la mayoría de los conectores JDBC traen el resultado de una sola vez (fetch atómico), justo el escenario del OOM de la sección 4; fijar unfetchSizelo parte en tandas, y la doc recomienda uno grande (por ejemplo100000). Se ajusta por query:SELECT ... FROM pg_ventas.public.orders WITH ('fetchSize' 100000). Requiere DBR 16.1+ (Databricks Runtime, la versión del motor de los clusters) o warehouse con canal 2024.50+.- Lecturas paralelas: con
numPartitions,partitionColumn,lowerBoundyupperBoundel scan remoto se parte en varias subqueries concurrentes, cada una con su rango. Requiere DBR 17.1+ o canal 2025.25+, y ojo: no funciona a través de vistas que referencian tablas federadas. - Join pushdown: empujar el join entero para que lo resuelva la base origen. Para Postgres y MySQL está en Public Preview (para Redshift, Snowflake y BigQuery ya es GA, Generally Available, estable y soportado): requiere DBR 17.2+ o canal 2025.30+, activar el preview Join Pushdown for Federated Queries en el workspace, y solo cubre joins inner, left outer y right outer.
AdvertenciaNo mezclar requisitos
Federation en sí funciona desde DBR 13.3 LTS o warehouse 2023.40+. Los requisitos 17.x/2025.x de arriba son solo de cada perilla de tuning. Si leés “requiere 17.2” en la doc, es del join pushdown, no de federar.
8. Requisitos y permisos
Lo mínimo para que esto funcione:
- Workspace con Unity Catalog habilitado
- Cómputo: DBR 13.3 LTS+ (modo de acceso Standard o Dedicated) o un SQL warehouse Pro o Serverless con canal 2023.40+ (repaso de tipos de warehouse en el Tips #9)
- Conectividad de red del cómputo a la base origen (con serverless y bases privadas esto es un capítulo aparte: allowlists, IPs estables, Private Link)
- Permisos:
CREATE CONNECTIONen el metastore para la connection;CREATE CATALOGmás la propiedad de la connection (oCREATE FOREIGN CATALOGsobre ella) para el catálogo
9. Gotchas
- Para bases de datos es solo lectura, sin excepción. La única escritura en todo Lakehouse Federation existe en catalog federation sobre el Hive metastore interno del workspace. Si necesitás escribir en el Postgres remoto, esto no es la herramienta: la doc te manda al Spark Data Source API con JDBC clásico.
- Sin caché de ningún tipo. Cada query, incluida la que repite tu dashboard, ejecuta en la base origen. Cuidá a tu Postgres: apuntá a una read replica si existe.
- El single stream te puede tirar un executor por OOM.
SELECT *sobre una tabla federada grande es la receta exacta. Filtrá y proyectá siempre; el pushdown existe para eso. - Minúsculas y descartes silenciosos. Nombres a lowercase, colisiones sin garantía de ganador, nombres inválidos ignorados sin warning (sección 3).
- La concurrencia tiene el techo del warehouse, no de la connection. El throttling lo determina el límite de queries concurrentes de Databricks SQL: te encolás por saturar el warehouse, no por apuntar muchos al mismo foreign catalog. Entre warehouses distintos no hay límite por connection.
- El metadata se refresca solo en cada query, con una salvedad. Unity Catalog trae el metadata más reciente al momento de consultar: tablas nuevas y cambios de schema se detectan sin hacer nada.
REFRESH FOREIGN CATALOG pg_ventasqueda para motores externos que leen el catálogo sin pasar por Databricks Runtime (esos accesos no disparan el refresh) o para precalentar el metadata cacheado por performance. - MySQL tiene sus propias reglas. SSL obligatorio, la opción
databaseno aplica en el catálogo, ytinyint(1)interpretado como booleano salvo que configurestinyInt1isBit.
10. Cuándo federar y cuándo no
La pregunta de fondo no es “¿puedo federar?” sino “¿cuántas veces por día voy a pagar el peaje de leer en vivo?”. La tabla de decisión:
| Situación | Mejor opción |
|---|---|
| Exploración, PoC (prueba de concepto), consulta ad hoc | Federar: cero infraestructura, dato fresco |
| El mismo dato consultado muchas veces al día | Ingestar con Lakeflow Connect: pagás la copia una vez, no por query |
| Query pesada y recurrente sobre tablas federadas | Materialized view sobre la tabla federada: el punto medio, resultado precalculado con refresh programado |
| Necesitás escribir en la base origen | Spark Data Source API (JDBC): Federation es read-only |
| Vas a crear un Postgres nuevo dentro del ecosistema | Lakebase: el Postgres gestionado de Databricks, sin JDBC de por medio |
| Compartir datos hacia afuera de tu organización | Delta Sharing (Tips #13) |
TipPara decidir rápido
Federá lo que consultás poco y cambia mucho; ingestá lo que consultás mucho y cambia poco. Y cuando el “poco” se vuelva “mucho”, la materialized view te da aire antes de armar la ingesta.
Referencias
Otros posts de la serie
Si te sirvió este post, mirá los anteriores de Databricks Tips:
- Tips #1: Databricks Asset Bundles — IaC para Databricks
- Tips #2: Delta Lake — las 7 cosas que te hubiera gustado saber
- Tips #3: Unity Catalog — gobernanza que nadie implementa bien
- Tips #4: Structured Streaming — watermarks, triggers y micro-batch
- Tips #5: MLflow + Unity Catalog — del experimento al modelo
- Tips #6: Feature Engineering — features que sobreviven a producción
- Tips #7: Docker en Databricks — contenedores custom
- Tips #8: Jobs & Workflows — streaming y triggers event-driven
- Tips #9: SQL Warehouses — el compute que se prende solo
- Tips #10: AI Gateway — governance centralizada para LLMs
- Tips #11: Lakeflow Declarative Pipelines — pipelines declarativos con calidad built-in
- Tips #12: Photon — el motor C++ que acelera tus queries
- Tips #13: OpenSharing — compartir sin copiar
- Tips #14: Liquid Clustering — el reemplazo de particiones y Z-ORDER