Databricks Tips #14: Liquid Clustering — el reemplazo de particiones y Z-ORDER
Databricks Tips
Delta Lake
Qué es Liquid Clustering, por qué reemplaza al particionado y a Z-ORDER, la sintaxis de CLUSTER BY (incluido AUTO), cómo se dispara con OPTIMIZE, y un lab reproducible donde la misma query pasa de leer 30 archivos a 1.
Elegiste mal la columna de partición hace seis meses y hoy tenés diez mil archivos de 3 MB, una carpeta por cada valor y queries que igual escanean media tabla. Cambiarla implica reescribir todo. Corrés OPTIMIZE ZORDER cada noche para tapar el agujero, y aun así el data skipping, la capacidad del motor de saltarse los archivos que no le sirven, nunca termina de rendir.
Liquid Clustering es la respuesta de Delta Lake a ese dolor: una técnica de organización física de los datos que reemplaza tanto al particionado como a Z-ORDER, que podés redefinir sin reescribir la tabla, y que con CLUSTER BY AUTO hasta puede elegir las columnas por vos. En este post vemos qué hace, la sintaxis, cómo se ejecuta, los requisitos que importan y un laboratorio para medir cuántos archivos saltea de verdad.
NotaTL;DR
- Liquid Clustering reorganiza los archivos de una tabla Delta según unas clustering keys para que el motor descarte archivos irrelevantes al filtrar (data skipping). Reemplaza al particionado Hive-style y a Z-ORDER, y no se combinan.
- El comportamiento base son keys manuales (
CLUSTER BY (col), hasta 4 columnas). Podés redefinirlas sin reescribir los datos existentes, algo imposible con el particionado. - Es incremental: habilitarlo no reordena el histórico. Corrés
OPTIMIZE(solo toca lo necesario) y, la primera vez o al cambiar keys,OPTIMIZE FULL. CLUSTER BY AUTO(Databricks elige las columnas por vos) pide Unity Catalog y Predictive Optimization, y no existe en Delta open-source. Liquid en sí es GA (Generally Available, o sea estable y soportado) desde DBR 15.4 LTS, y está en open-source desde Delta 3.1.0.- En el lab (200 millones de filas): la misma query lee 30 archivos en la tabla particionada y 1 con Z-ORDER o Liquid Clustering. Experimento reproducible incluido.
- Ojo con el mito: en tablas chicas (<10 TB) meter más keys puede empeorar el filtrado por una sola columna.
1. El problema: por qué duelen las particiones y Z-ORDER
Delta Lake, el formato de tablas transaccional por defecto en Databricks, guarda los datos en archivos Parquet más un log de transacciones. Para que una query lea poco, el motor usa data skipping: mira las estadísticas (mínimo/máximo por columna) de cada archivo y se saltea los que no pueden contener lo que buscás. Cuanto mejor agrupados estén los valores en los archivos, más archivos puede descartar.
Históricamente había dos formas de mejorar ese agrupamiento, y las dos tienen su peaje:
- Particionado Hive-style: una carpeta por cada valor de la columna de partición (
país=UY/,país=AR/, …). Funciona con columnas de baja cardinalidad (pocos valores distintos). Sus dos males clásicos: el small files problem (particiones con muchos archivos chicos, caros de listar y leer) y la alta cardinalidad (particionar poruser_idte da millones de carpetas). Y hay algo peor: elegiste mal la columna → reescribir toda la tabla para cambiarla. - Z-ORDER: un reordenamiento que agrupa en los mismos archivos los valores cercanos de varias columnas a la vez (usa una curva de orden Z, una forma de recorrer el espacio multidimensional preservando cercanía). Mejora el skipping, pero hay que correr
OPTIMIZE tabla ZORDER BY (cols)a mano y reescribe de más cada vez, porque no es incremental: recalcula sobre todo el rango tocado.
En los dos casos terminás administrando el layout de tus datos como una tarea de mantenimiento manual. Liquid Clustering existe para sacarte eso de encima.
2. Qué es Liquid Clustering
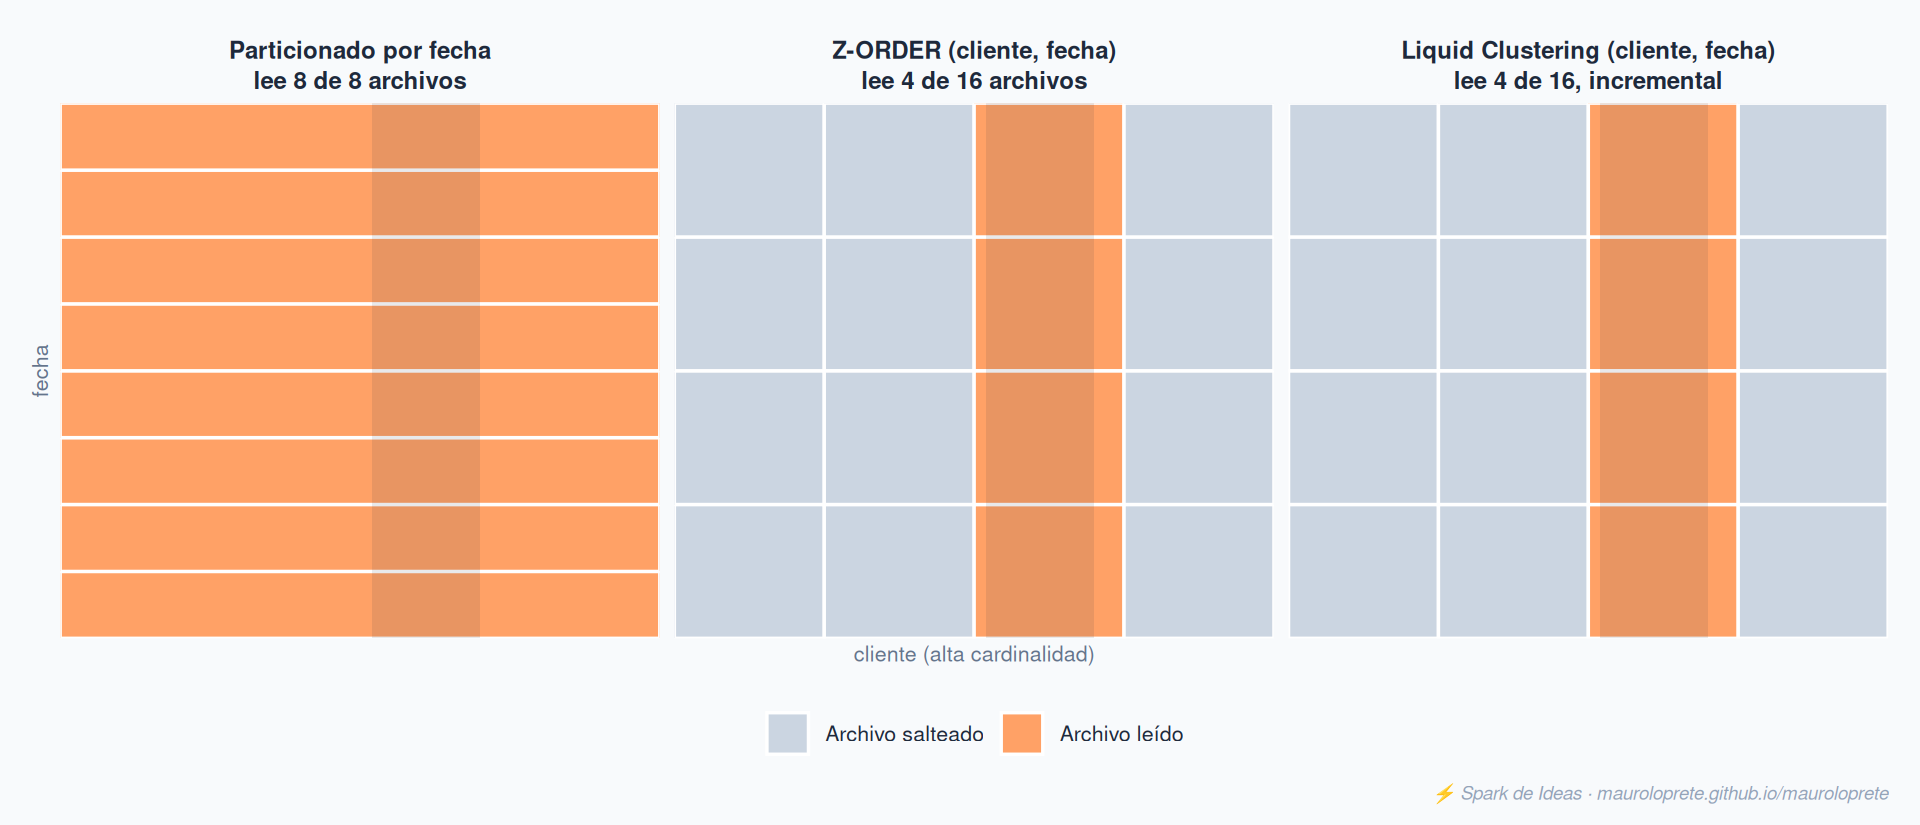
Liquid Clustering es una técnica de optimización de layout de datos de Delta Lake: definís unas clustering keys (hasta 4 columnas) y Delta organiza los archivos según esas keys para maximizar el data skipping. La diferencia de fondo con el particionado:
Ese ejemplo filtra por una sola columna. La ventaja de fondo se ve al filtrar por dos: ordenar los archivos por una columna te obliga a leer la franja entera, mientras que clusterizar en dos dimensiones deja leer solo el archivo del cruce.
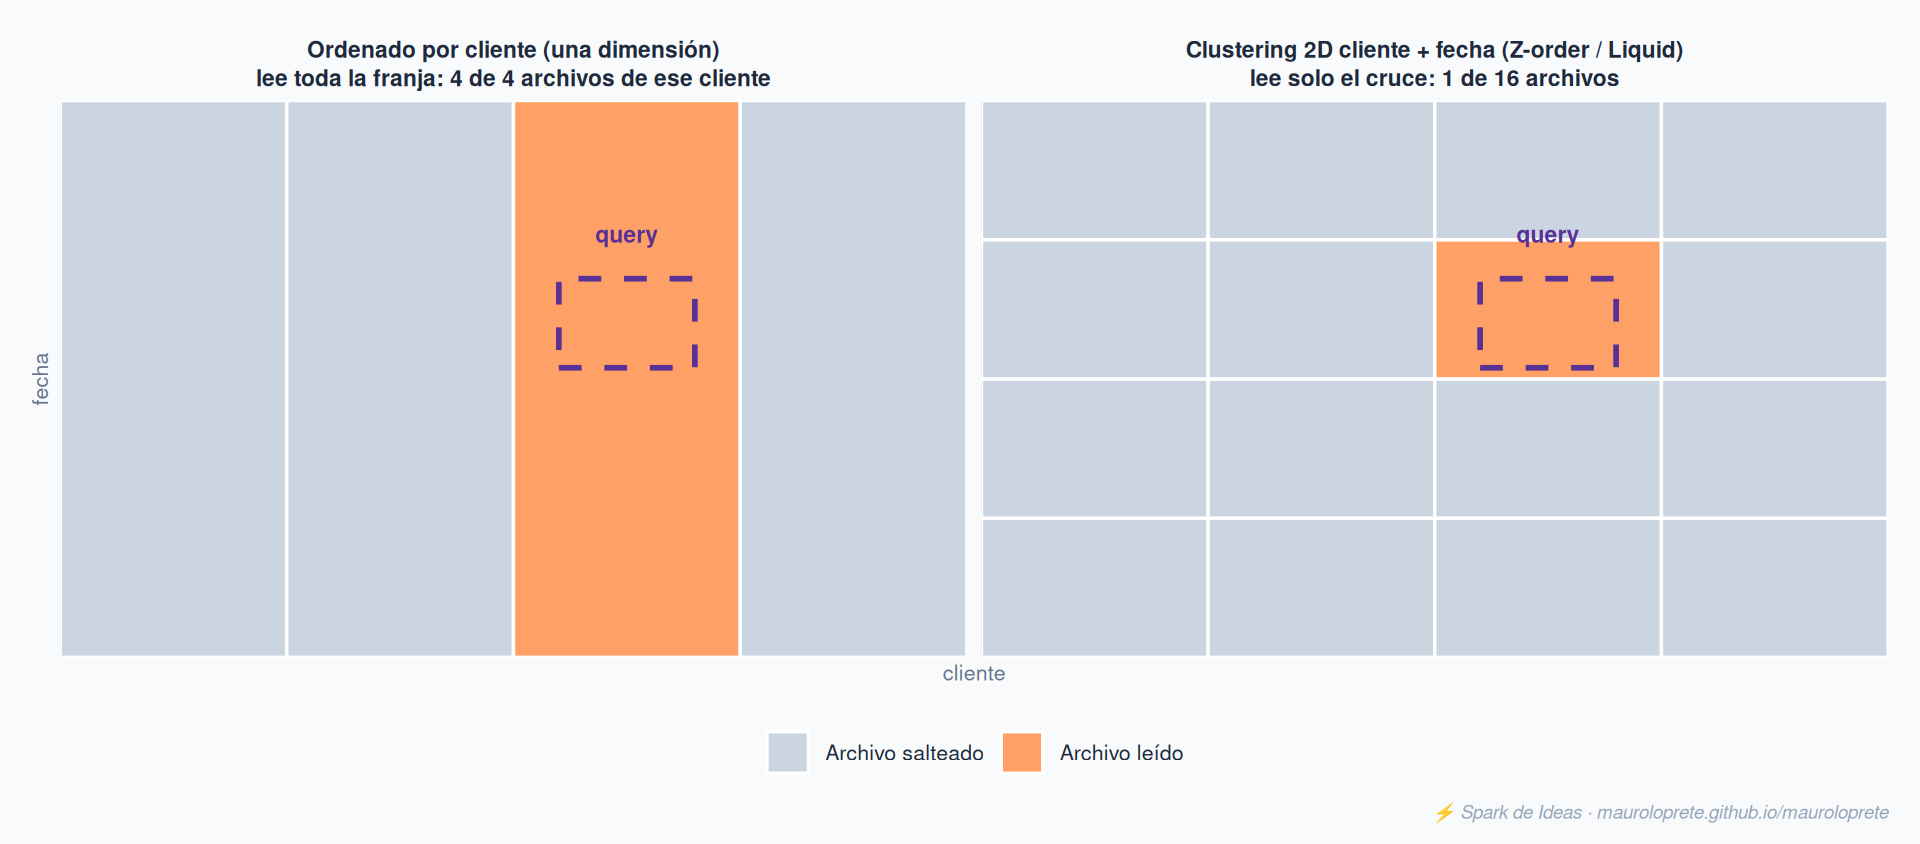
Lo que lo hace distinto: podés cambiar las clustering keys sin reescribir los datos existentes. ¿Elegiste fecha y resulta que casi siempre filtrás por cliente? Redefinís las keys y, a partir del próximo OPTIMIZE, el clustering se acomoda a las nuevas. Con particiones eso es un CREATE TABLE ... AS SELECT de toda la tabla.
ImportanteEl mito del clustering automático
Un malentendido común (que hasta yo arrastré en mi blog): el comportamiento base de Liquid Clustering no “aprende los patrones de consulta y se ajusta solo”. Eso es exclusivo de CLUSTER BY AUTO (sección 5). En el modo base, vos elegís las keys; lo que Delta hace es mantener el agrupamiento según esas keys de forma incremental.
3. Sintaxis: los tres caminos de CLUSTER BY
La cláusula CLUSTER BY tiene tres formas. Aplica a Databricks SQL y a Databricks Runtime (DBR, la imagen de Spark + librerías del cluster) 13.3 LTS y superior, solo sobre Delta Lake:
-- Tabla nueva
CREATE TABLE ventas (id INT, cliente STRING, fecha DATE)
CLUSTER BY (cliente, fecha);

-- Tabla existente NO particionada
ALTER TABLE ventas CLUSTER BY (cliente, fecha);

-- Desactivar clustering (no reescribe lo ya clusterizado)
ALTER TABLE ventas CLUSTER BY NONE;
Reglas que conviene tener claras:
- Hasta 4 clustering keys por tabla.
- Las keys tienen que ser columnas con estadísticas recolectadas. Por defecto Delta junta estadísticas de las primeras 32 columnas de la tabla. Una columna más allá de la 32 no sirve como key sin ajustar esa configuración.
- No podés clusterizar por tipos complejos (
StructType,MapType,ArrayType) ni por sus elementos. Sí por un campo de struct con notación de punto:CLUSTER BY (datos.pais).
AdvertenciaTabla particionada: otro comando
ALTER TABLE ... CLUSTER BY funciona sobre tablas no particionadas. Si tu tabla ya está particionada, esto no la convierte: desde DBR 18.1 la conversión directa existe, pero es otro comando (REPLACE PARTITIONED BY WITH CLUSTER BY). Mirá la sección 7 (migración).
4. Cómo se dispara: el clustering es incremental
Acá está la parte que más confunde: habilitar el clustering no reordena el histórico. Le decís a Delta cuáles son las keys, pero los datos que ya estaban siguen donde estaban hasta que corras un OPTIMIZE:
-- Clusteriza de forma incremental: solo reescribe lo necesario,
-- no toca archivos cuyas keys ya coinciden
OPTIMIZE ventas;

-- Fuerza el recluster de TODOS los registros (DBR 16.4 LTS+)
OPTIMIZE ventas FULL;OPTIMIZEes incremental: no toca los archivos que ya están bien agrupados. Barato de correr seguido.OPTIMIZE FULLfuerza el recluster completo. Databricks lo recomienda la primera vez que habilitás el clustering (para acomodar el histórico) o cuando cambiás las keys.
Si tenés Predictive Optimization activo (el servicio gestionado que corre OPTIMIZE y VACUUM solo según el uso de la tabla), Databricks dispara el clustering por vos. En ese caso, apagá los jobs de OPTIMIZE que tengas agendados para no duplicar trabajo.
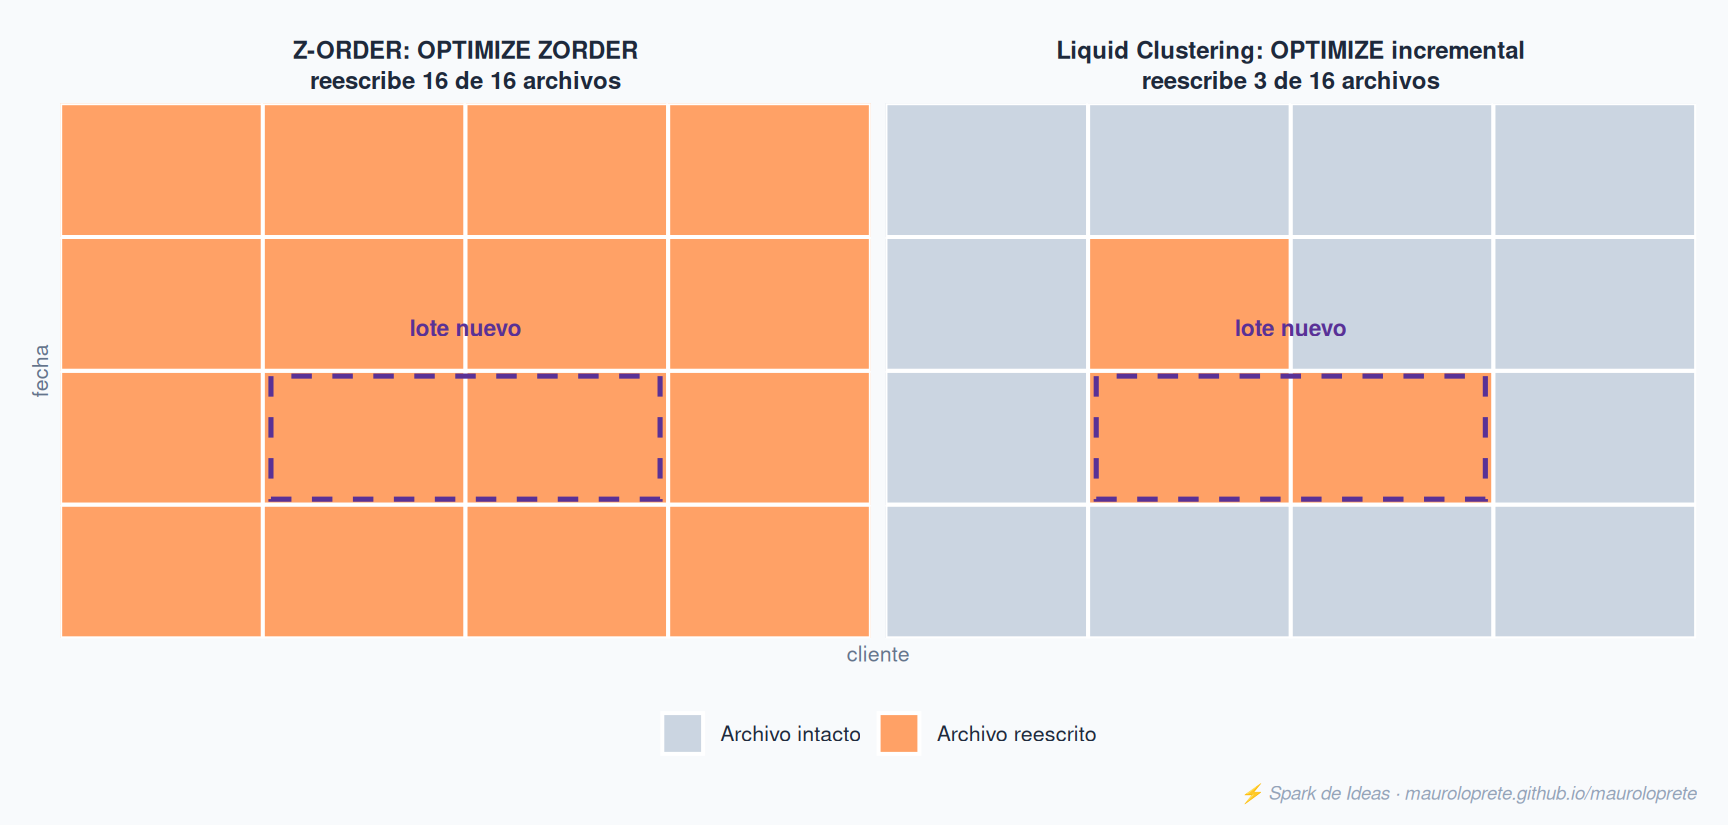
Acá está la diferencia real con Z-ORDER, que en el data skipping rendía parecido. Cuando llega un lote nuevo, OPTIMIZE ZORDER reordena todo el conjunto para no romper el orden; el OPTIMIZE de Liquid Clustering toca solo los archivos afectados:
NotaPor dentro: curva de Hilbert y ZCubes
Dos piezas explican por qué Liquid Clustering saltea más archivos que Z-ORDER y a la vez reescribe poco. La primera es la curva de Hilbert, una curva de relleno de espacio (una forma de recorrer una grilla de varias dimensiones manteniendo cerca a los puntos vecinos) que Delta usa en lugar de la curva Z de Z-ORDER, y que mejora el data skipping. La segunda son los ZCubes: cada OPTIMIZE produce un grupo de archivos ya clusterizados y los marca en el log de Delta con un id de ZCube; el siguiente OPTIMIZE solo reescribe los archivos que todavía no están clusterizados. Por eso el clustering es incremental y no dispara la reescritura completa (write amplification).
5. CLUSTER BY AUTO: que Databricks elija las columnas
El modo automático. En vez de vos elegir las keys, Databricks las elige según los patrones de consulta reales sobre la tabla:
CREATE TABLE ventas (id INT, cliente STRING, fecha DATE)
CLUSTER BY AUTO;
Los requisitos son la letra chica que importa:
- DBR 15.4 LTS+.
- Tablas Delta gestionadas por Unity Catalog (UC, el catálogo de gobernanza de Databricks; ver Tips #3).
- Predictive Optimization habilitado.
- Corre asíncrono: el ajuste de keys no es instantáneo, se acomoda con el tiempo.
AdvertenciaAUTO es Databricks-only
CLUSTER BY AUTO no existe en Delta Lake open-source. Fuera de Databricks siempre especificás las columnas a mano.
6. Predictive Optimization: el mantenimiento que se corre solo
Correr OPTIMIZE, VACUUM y ANALYZE a mano es la parte aburrida de tener tablas Delta. Predictive Optimization (PO) lo hace por vos sobre las tablas gestionadas de Unity Catalog: Databricks identifica las tablas que se beneficiarían de mantenimiento y las encola, en vez de correr todo a ciclo fijo.
Qué corre. OPTIMIZE (incluido el clustering incremental de las tablas con Liquid), VACUUM (borra archivos que ya no referencia la tabla, según su retención) y ANALYZE (recolecta estadísticas para el planner). Un detalle que juega a favor de Liquid: cuando PO corre OPTIMIZE, no ejecuta ZORDER. En una tabla con Z-order, PO ignora los archivos ya ordenados; el resto del mantenimiento (VACUUM, ANALYZE, compactación) sigue corriendo, pero el orden Z no se mantiene solo.
Cómo se activa. Es una propiedad que se hereda en cascada: cuenta → catálogo → esquema → tabla. Cada tabla gestionada toma el valor de la cuenta salvo que lo pises más abajo.
ALTER CATALOG mi_catalogo ENABLE PREDICTIVE OPTIMIZATION;
ALTER SCHEMA mi_catalogo.ventas DISABLE PREDICTIVE OPTIMIZATION;
ALTER TABLE mi_catalogo.ventas.hechos INHERIT PREDICTIVE OPTIMIZATION;
INHERIT vuelve al valor del objeto padre. Para ver si está activo en una tabla usás DESCRIBE TABLE EXTENDED mi_tabla, donde el campo Predictive Optimization te dice si está en ENABLE y si lo heredó. A nivel cuenta se prende en la consola de cuenta, en Settings → Feature enablement. Viene habilitado por defecto en las cuentas creadas desde el 11 de noviembre de 2024; para las cuentas más viejas el despliegue es gradual.
Restricciones y requisitos. Solo aplica a tablas gestionadas de Unity Catalog. Quedan afuera las external tables y las tablas cargadas como recipient de OpenSharing. El trabajo corre en serverless jobs compute, necesitás un workspace en plan Premium en una región soportada, y se factura como un SKU de serverless jobs.
TipPO + Liquid: no pagues el trabajo dos veces
Si tenés Liquid Clustering y Predictive Optimization activos, PO corre el OPTIMIZE de tus tablas clusterizadas por vos. Apagá los jobs de OPTIMIZE que tengas agendados para no pagar el trabajo dos veces. Y acordate de que CLUSTER BY AUTO depende de PO: sin PO no puede elegir keys ni reclusterizar. Además PO cambia las keys solo cuando el ahorro previsto por mejor data skipping supera el costo de reclusterizar.
7. Migrar desde Z-ORDER y desde particionado
- Desde Z-ORDER: usá directamente las columnas de tu
ZORDER BYcomo clustering keys. Es prácticamente un reemplazo uno a uno. - Desde particionado: las columnas de partición pasan a ser las clustering keys. Acá el cómo depende del runtime:
- DBR 18.1+: conversión in-place con
ALTER TABLE ventas REPLACE PARTITIONED BY WITH CLUSTER BY (cliente, fecha)(o... WITH CLUSTER BY AUTO). - Runtimes anteriores: hay que recrear la tabla con un
CREATE TABLE ... AS SELECT(CTAS, o sea “crear tabla a partir de un SELECT”) que incluya elCLUSTER BY.
- DBR 18.1+: conversión in-place con
ImportanteSin mezclas: particiones o clustering
Liquid Clustering no se combina con particionado ni con Z-ORDER. Es uno o el otro: al migrar, dejás de particionar y de correr ZORDER.
8. Lab: CLUSTER BY vs Z-ORDER vs particionado, midiendo file pruning
El objetivo es medir cuántos archivos se saltea el motor en cada estrategia sobre la misma query filtrada. Reutilizamos el patrón de dataset sintético del lab de Photon (#12):
# 1. Dataset sintético con skew realista (misma base, tres tablas)
from pyspark.sql import functions as F

base = (spark.range(0, 200_000_000)
        .withColumn("cliente", (F.rand() * 50_000).cast("int"))
        .withColumn("fecha", F.expr("date_add('2024-01-01', cast(rand()*600 as int))"))
        .withColumn("monto", (F.rand() * 1000)))

base.write.mode("overwrite").saveAsTable("lab.ventas_base")
-- 2. Tres versiones de la tabla
-- (a) Particionada por fecha
CREATE TABLE lab.ventas_part
PARTITIONED BY (fecha) AS SELECT * FROM lab.ventas_base;
-- (b) Z-ORDER por cliente, fecha
CREATE TABLE lab.ventas_zorder AS SELECT * FROM lab.ventas_base;
OPTIMIZE lab.ventas_zorder ZORDER BY (cliente, fecha);
-- (c) Liquid Clustering por cliente, fecha
CREATE TABLE lab.ventas_liquid
CLUSTER BY (cliente, fecha) AS SELECT * FROM lab.ventas_base;
OPTIMIZE lab.ventas_liquid FULL;-- 3. La misma query filtrada sobre las tres, midiendo archivos leídos
SELECT count(*) FROM lab.ventas_liquid
WHERE cliente = 4242 AND fecha BETWEEN '2024-06-01' AND '2024-06-30';Para leer cuántos archivos salteó cada una, mirá el query profile (métrica files pruned / files read) o DESCRIBE DETAIL tabla para el conteo de archivos.
9. Resultados: lectura
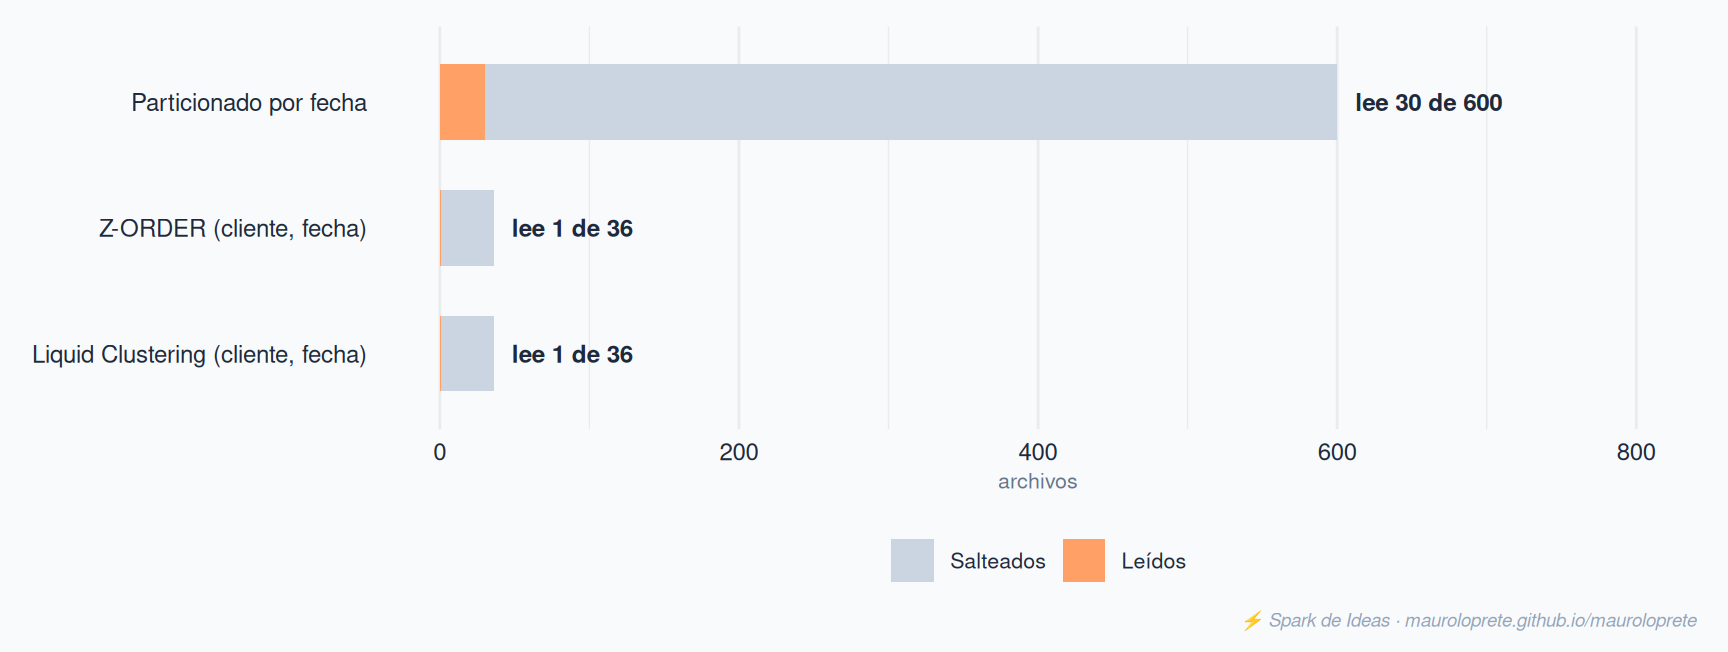
Medido sobre 200 millones de filas en serverless con Photon, con la misma query filtrando por cliente y fecha. Los archivos leídos y salteados salen del query history (read_files_count / pruned_files_count); el total de archivos, de DESCRIBE DETAIL. Salteados: los archivos que el data skipping evitó leer (la métrica del query profile los llama Files pruned).
| Estrategia | Archivos totales | Archivos leídos | Archivos salteados | Bytes leídos | Tiempo del scan |
|---|---|---|---|---|---|
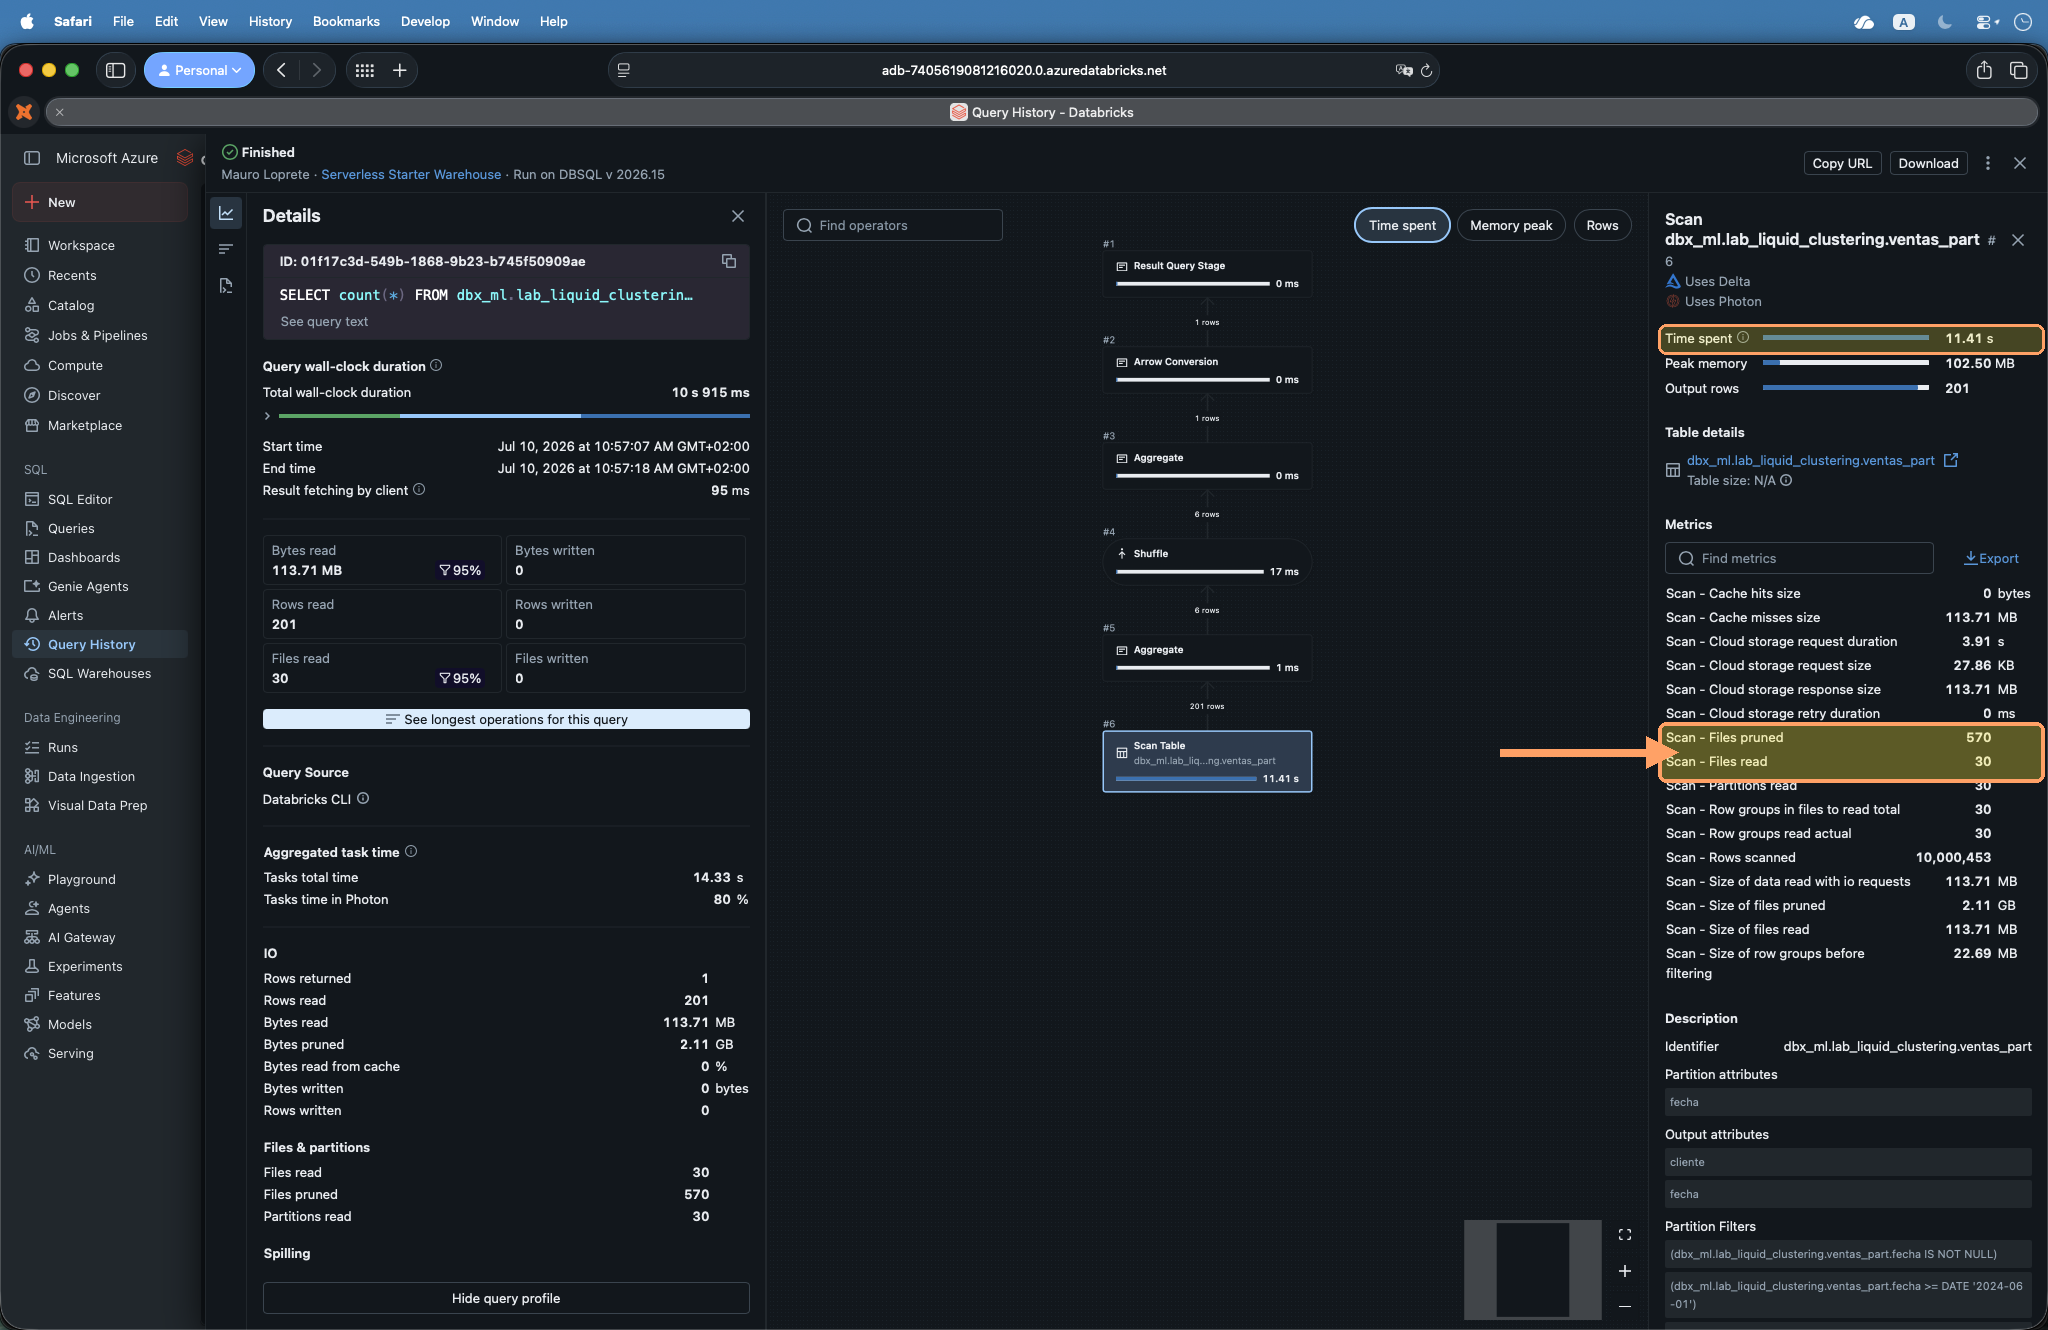
| Particionado por fecha | 600 | 30 | 570 | 119 MB | 11.41 s |
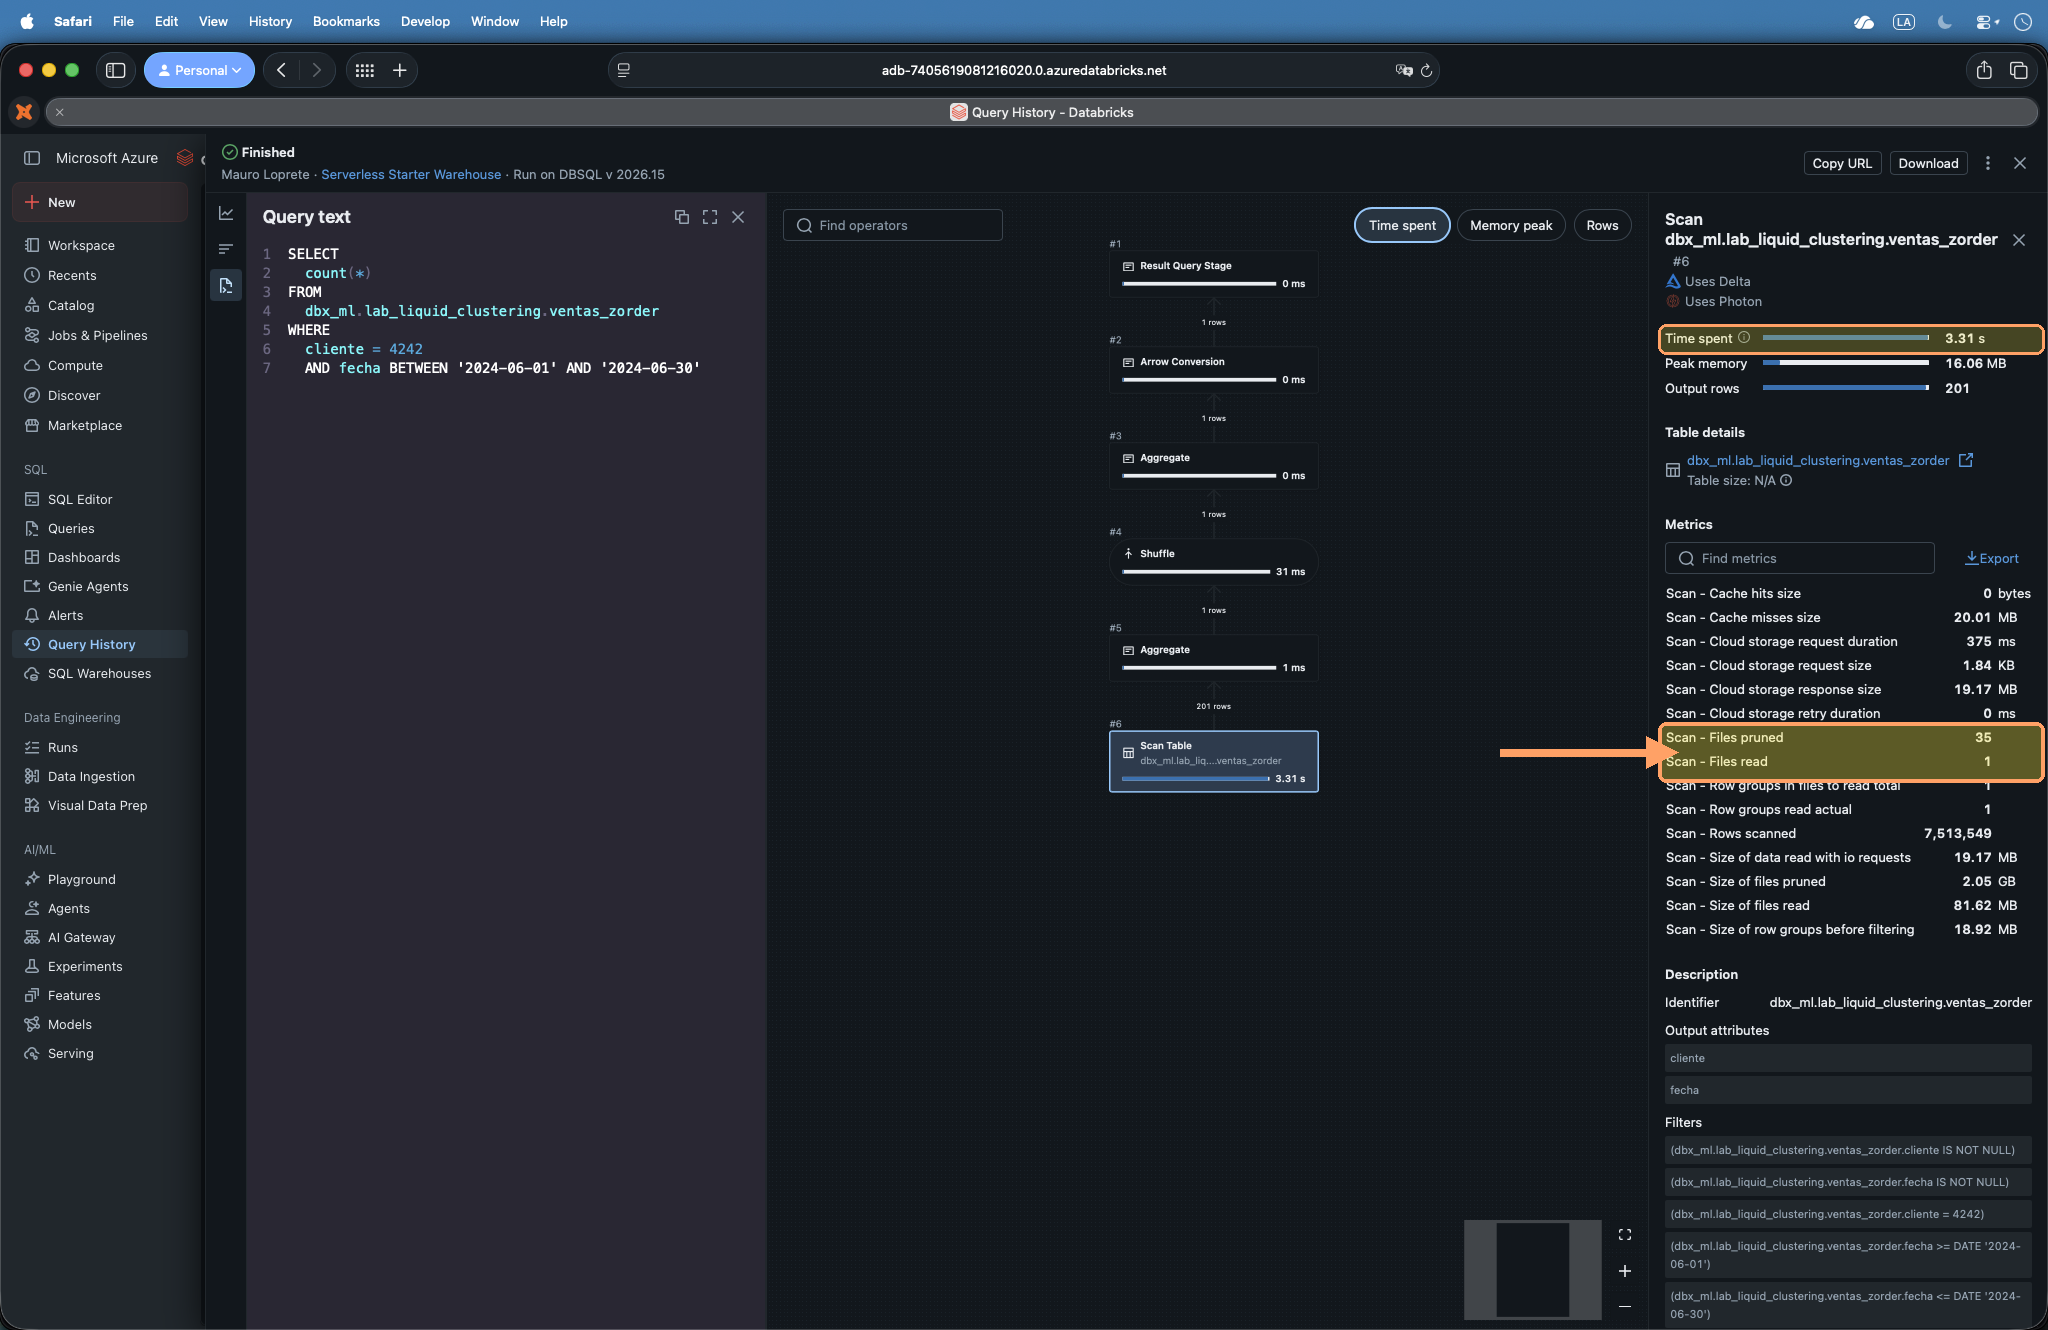
| Z-ORDER (cliente, fecha) | 36 | 1 | 35 | 20 MB | 3.31 s (3.4x más rápido) |
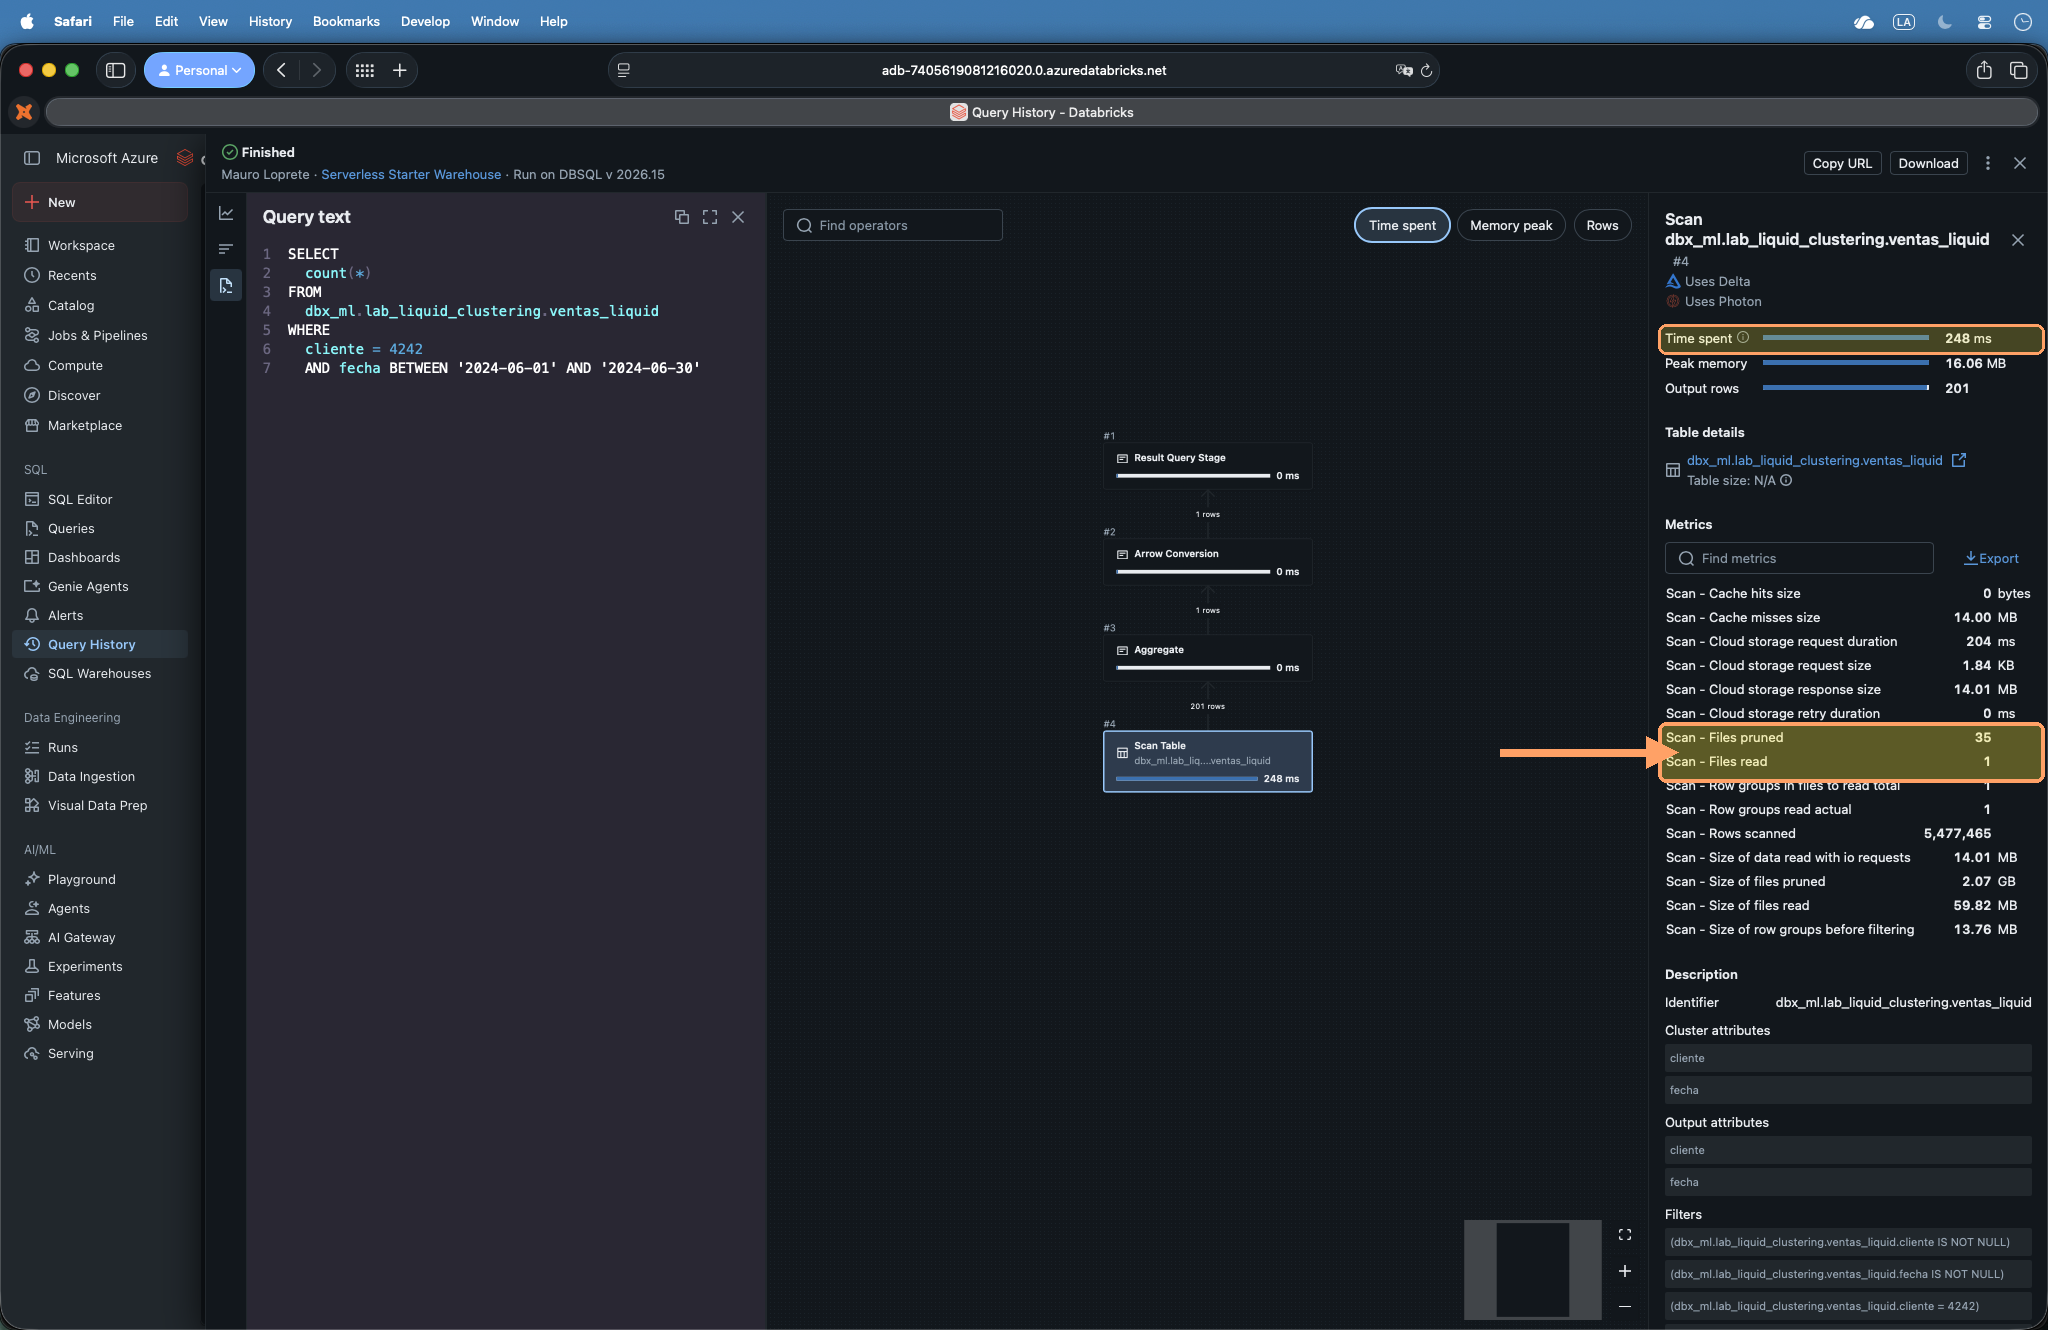
| Liquid Clustering (cliente, fecha) | 36 | 1 | 35 | 15 MB | 248 ms (46x más rápido) |
Dos lecturas. Primero, particionar por fecha explotó el layout en 600 archivos (uno por día), el clásico small-files; clusterizar dejó 36. Segundo, la query saltea archivos por fecha en el particionado (de 600 baja a 30, los días de junio), pero como no puede saltear por cliente los lee enteros: 30 archivos y 119 MB. Z-ORDER y Liquid saltean por las dos columnas y bajan a 1 archivo; Liquid encima lee menos bytes (15 contra 20 MB) porque empaqueta mejor con la curva de Hilbert.
NotaEl estadístico no se queda con una corrida
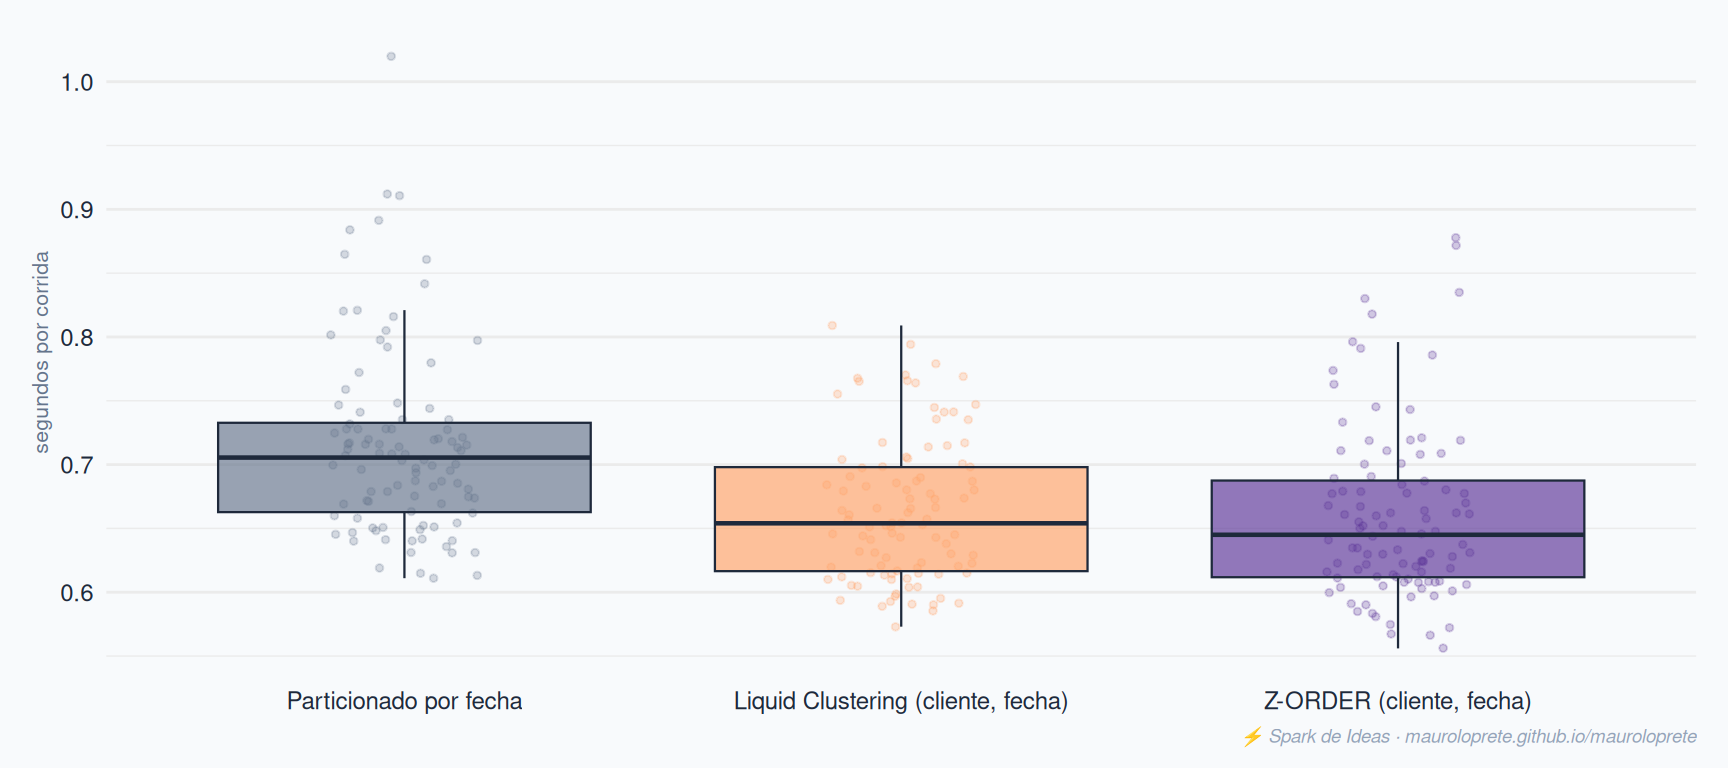
Confesión: soy estadístico, y una sola corrida no me deja dormir. Una medición sin distribución es una anécdota. Así que corrí la misma query 100 veces por estrategia, intercaladas (particionado, Z-ORDER, Liquid, y de vuelta) para que el caché y el estado del cluster afecten a las tres por igual:
| Estrategia | Mediana | p25–p75 | Mín | Máx |
|---|---|---|---|---|
| Particionado por fecha | 0.705 s | 0.662–0.734 s | 0.611 s | 1.02 s |
| Z-ORDER (cliente, fecha) | 0.645 s | 0.611–0.688 s | 0.556 s | 0.878 s |
| Liquid Clustering (cliente, fecha) | 0.654 s | 0.615–0.698 s | 0.573 s | 0.809 s |
La lectura honesta: con el caché caliente las tres convergen. Z-ORDER y Liquid empatan (9 ms de mediana, adentro del ruido) y el particionado queda ~8% más lento, consistente con leer 30 archivos en vez de 1. El layout no acelera lo que ya está en memoria: paga en la primera lectura (el scan frío de la tabla de arriba), en los bytes movidos y en el mantenimiento. Moraleja doble: medí con distribución, y sabé qué parte del tiempo estás midiendo.
10. Resultados: escritura
Hasta acá, todo lectura. El otro lado importa igual: llega un lote nuevo (10 millones de filas, el 5% de la tabla) y hay que escribirlo y después mantener el orden de cada estrategia:
# El lote nuevo: 10M filas con la misma distribución.
# Se genera UNA sola vez y se inserta el mismo lote en las tres tablas,
# para que la comparación sea justa.
lote = (spark.range(0, 10_000_000)
        .withColumn("cliente", (F.rand() * 50_000).cast("int"))
        .withColumn("fecha", F.expr("date_add('2024-01-01', cast(rand()*600 as int))"))
        .withColumn("monto", (F.rand() * 1000)))

lote.write.saveAsTable("lab.ventas_lote")
-- El mismo append en las tres tablas
INSERT INTO lab.ventas_part SELECT * FROM lab.ventas_lote;
INSERT INTO lab.ventas_zorder SELECT * FROM lab.ventas_lote;
INSERT INTO lab.ventas_liquid SELECT * FROM lab.ventas_lote;
-- El mantenimiento que le sigue a cada estrategia
OPTIMIZE lab.ventas_part; -- compacta las particiones
OPTIMIZE lab.ventas_zorder ZORDER BY (cliente, fecha); -- re-ordena (no es incremental)
OPTIMIZE lab.ventas_liquid; -- incrementalCada operación deja sus métricas en el historial de la tabla: archivos creados en el append, archivos y MB reescritos en el mantenimiento.
-- numFiles y numOutputBytes del INSERT; numRemovedFiles,
-- numAddedFiles y numRemovedBytes del OPTIMIZE
DESCRIBE HISTORY lab.ventas_liquid LIMIT 2;
Así quedó:
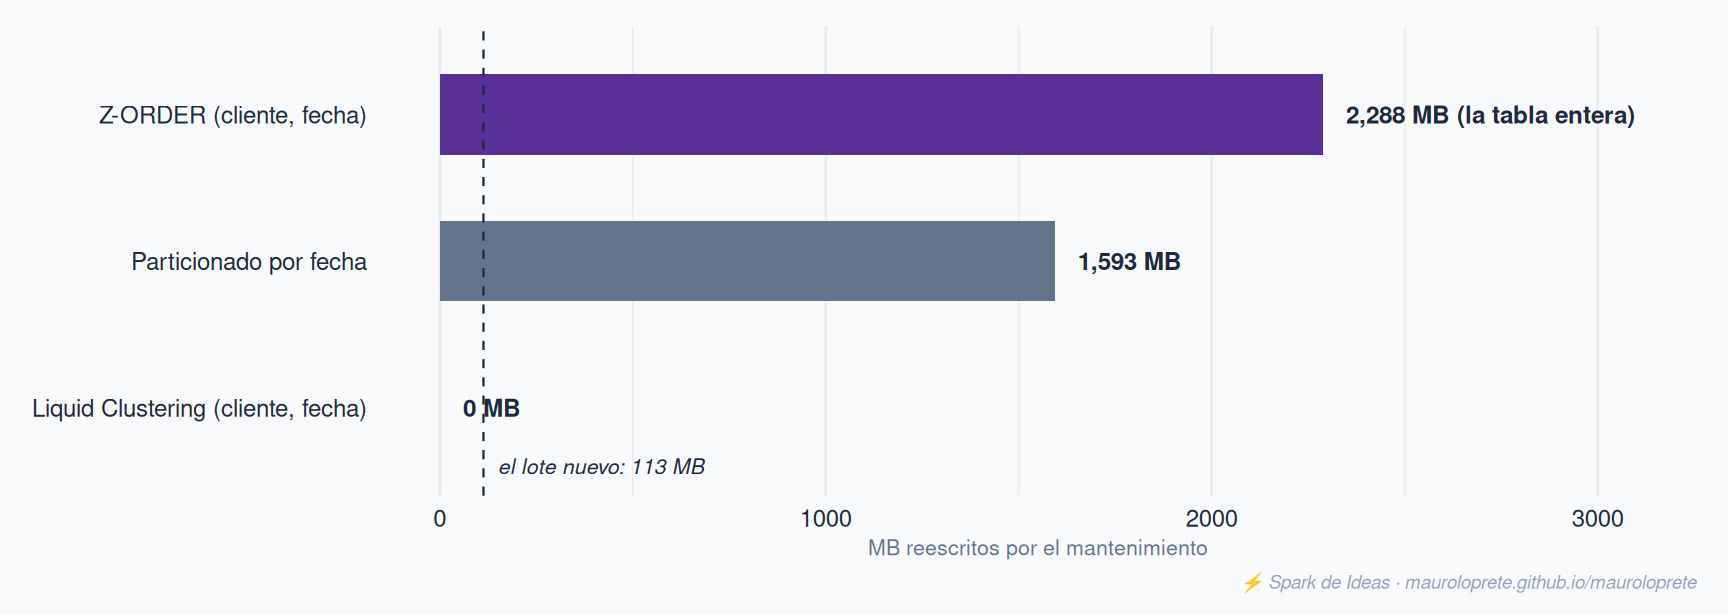
| Estrategia | Append del lote | Archivos creados | Mantenimiento | MB reescritos |
|---|---|---|---|---|
| Particionado por fecha | 18.5 s | 600 | OPTIMIZE · 40.8 s |
1,593 MB |
| Z-ORDER (cliente, fecha) | 2.5 s | 2 | OPTIMIZE ZORDER · 29.3 s |
2,288 MB (la tabla entera) |
| Liquid Clustering (cliente, fecha) | 1.9 s | 2 | OPTIMIZE · 4.8 s |
0 MB |
Tres historias en una tabla:
- El particionado fragmenta el append: el mismo lote se parte en 600 archivos chicos (una carpeta por fecha), tarda casi 10 veces más en escribirse, y la compactación posterior reescribe 1.6 GB.
- Z-ORDER escribe rápido, pero mantener el orden cuesta la tabla entera: para incorporar 113 MB nuevos,
OPTIMIZE ZORDERreescribió 2.3 GB. Esa es la write amplification del diagrama de la sección 4, ahora medida. - Liquid escribe rápido y mantener el orden no costó nada: el
OPTIMIZEincremental terminó en 4.8 segundos sin reescribir un solo archivo (0 archivos, 0 MB).
TipLa analogía del índice
Si venís de bases de datos relacionales, esto te va a sonar. Liquid Clustering se comporta como un buen índice: acelera la lectura sin castigar la escritura. Z-ORDER también es un “índice” para leer, pero con el problema clásico del índice caro: cada escritura te obliga a pagar su mantenimiento, que acá es reescribir la tabla completa. Y el particionado es un índice que encima te hace elegir la columna una sola vez y para siempre.
TipReproducilo vos
El experimento completo está como Databricks Asset Bundle en spark-de-ideas-labs/tips/liquid-clustering, y corre en Free Edition:
databricks bundle deploy
databricks bundle run liquid_clustering_benchmark
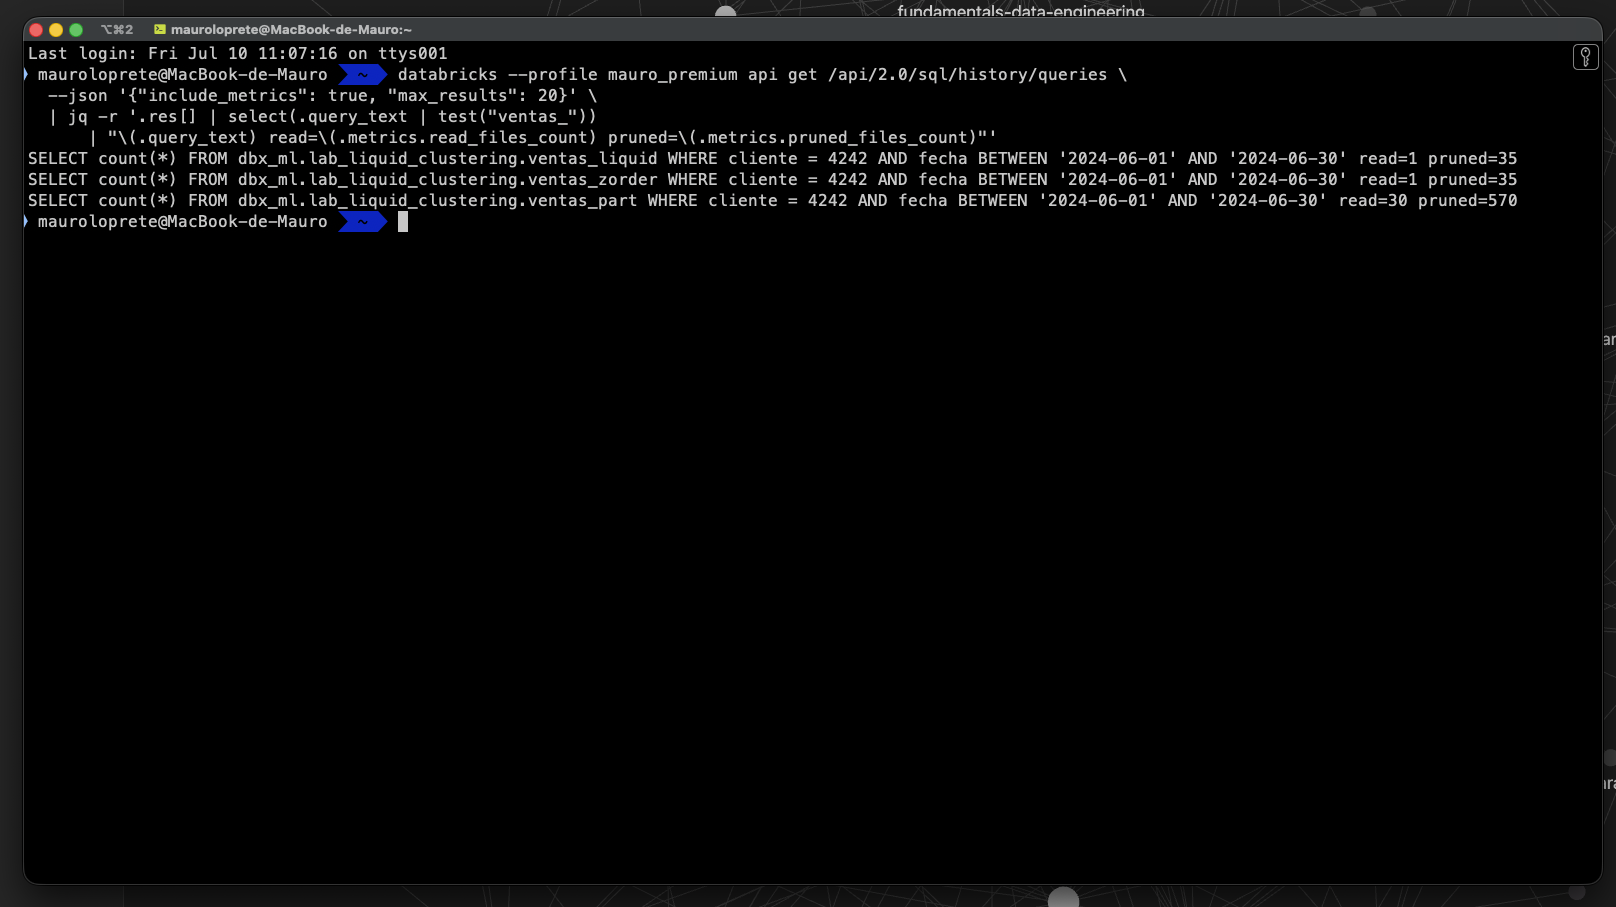
El notebook reporta el total de archivos (DESCRIBE DETAIL), el wall-clock, las corridas repetidas (timings_raw, ajustables con --var bench_runs=N) y las métricas de escritura (append + mantenimiento). Los archivos leídos y salteados no se pueden leer del plan de forma programática en serverless (Spark Connect). En la UI sí están: incluso en un notebook serverless podés abrir el query profile desde el link See performance. Para sacarlos de forma programática, los medí corriendo las queries en un SQL Warehouse y leyendo el query history:
databricks api get /api/2.0/sql/history/queries \
  --json '{"include_metrics": true, "max_results": 20}' \
  | jq -r '.res[] | select(.query_text | test("ventas_"))
      | "\(.query_text) read=\(.metrics.read_files_count) pruned=\(.metrics.pruned_files_count)"'
Así se ve la salida real del comando, con los tres layouts medidos:
El mismo par de números está en el query profile de cada query. Para verlo: abrí la query en Query History, entrá al query profile y seleccioná el nodo Scan. En el panel de métricas de la derecha están las filas Files pruned y Files read (resaltadas en amarillo en las capturas), y arriba el Time spent del scan, que muestra el efecto directo del layout:
11. Requisitos, compatibilidad y protocolo
- Disponibilidad: GA para Delta con DBR 15.4 LTS+; Public Preview para Apache Iceberg con DBR 16.4 LTS+; en Delta open-source desde la 3.1.0.
- Protocolo de tabla: usa writer version 7 / reader version 3, y no se puede degradar. Traducción práctica: clientes Delta viejos que no soporten esos protocolos no van a poder leer la tabla.
- Incompatibilidades: no se combina con particionado ni con Z-ORDER.
- DataFrame API (Python/Scala): las keys solo se fijan al crear la tabla o en modo
overwrite(CREATE OR REPLACE), nunca enappend. Para cambiarlas mientras hacés append, usáALTER TABLEpor SQL. - Materialized views y streaming tables: no se les cambian las keys con
ALTER TABLE; se ajusta la definición del pipeline/vista.
12. Gotchas
- Habilitar ≠ reclusterizar. Poner
CLUSTER BYno reordena el histórico. La primera vez corréOPTIMIZE FULLo vas a ver poca mejora y creer que “no sirve”. AUTOes Databricks-only. Requiere Unity Catalog + predictive optimization. En Delta open-source no existe: especificás columnas siempre.- Más keys no es mejor. En tablas <10 TB, usar 4 keys puede rendir peor que 2 cuando filtrás por una sola columna. Empezá con las columnas que realmente filtrás.
- La columna 33 no clusteriza. Solo las columnas con estadísticas (primeras 32 por defecto) sirven como key. Si tu columna cae más allá, ajustá la config de estadísticas primero.
- Con particiones no es que convenga evitarlo: no se puede. Es incompatibilidad dura: una tabla es particionada o clusterizada, nunca las dos cosas, y
ALTER TABLE ... CLUSTER BYfalla sobre una tabla particionada. Si venís de una, migrá de verdad (sección 7). - El protocolo no se baja. Writer v7 / reader v3 es de ida: verificá que todos tus lectores (conectores, herramientas externas) lo soporten antes de migrar tablas compartidas.
13. Cuándo usar Liquid Clustering (y cuándo no)
Databricks recomienda Liquid Clustering para todas las tablas nuevas. Los casos que más se benefician: filtros sobre columnas de alta cardinalidad, tablas con skew fuerte (valores muy desbalanceados), crecimiento rápido, escrituras concurrentes y patrones de acceso que cambian con el tiempo.
| Situación | ¿Liquid Clustering? | Por qué |
|---|---|---|
| Tabla nueva, cualquier tamaño | Sí | Es la recomendación por defecto de Databricks |
| Filtrás por columna de alta cardinalidad | Sí | Donde el particionado sufría, esto brilla |
| Ya usás Z-ORDER | Sí, migrá | Reemplazo casi uno a uno, y encima incremental |
| Lectores con clientes Delta viejos | Cuidado | Protocolo v7/v3 no degradable: pueden no leerla |
Necesitás AUTO pero estás en Delta open-source |
No (AUTO) | AUTO es Databricks-only; usá keys manuales |
| Tabla chica y filtrás siempre por una sola columna | Con 1-2 keys | Meter 4 keys puede empeorar el data skipping |
Referencias
- Use liquid clustering for tables — Azure Databricks
- Use liquid clustering for tables — Databricks on AWS
- CLUSTER BY clause (TABLE) — SQL reference
- Use liquid clustering for Delta tables — Delta Lake open-source
- Delta Lake 3.1.0 release: Liquid Clustering con curva de Hilbert y ZCubes
- Predictive optimization for Unity Catalog managed tables
Otros posts de la serie
Si te sirvió este post, mirá los anteriores de Databricks Tips:
- Tips #1: Databricks Asset Bundles — IaC para Databricks
- Tips #2: Delta Lake — las 7 cosas que te hubiera gustado saber
- Tips #3: Unity Catalog — gobernanza que nadie implementa bien
- Tips #4: Structured Streaming — watermarks, triggers y micro-batch
- Tips #5: MLflow + Unity Catalog — del experimento al modelo
- Tips #6: Feature Engineering — features que sobreviven a producción
- Tips #7: Docker en Databricks — contenedores custom
- Tips #8: Jobs & Workflows — streaming y triggers event-driven
- Tips #9: SQL Warehouses — el compute que se prende solo
- Tips #10: AI Gateway — governance centralizada para LLMs
- Tips #11: Lakeflow Declarative Pipelines — pipelines declarativos con calidad built-in
- Tips #12: Photon — el motor C++ que acelera tus queries
- Tips #13: OpenSharing — compartir sin copiar
Siguiente post de la serie: Query Federation, o cómo consultar ese Postgres que nadie quiere migrar sin mover un byte.