Databricks Tips #12: Photon — el motor C++ que acelera tus queries sin cambiar código
Databricks Tips
Data Engineering
Qué es el motor vectorizado de Databricks, dónde corre, qué acelera y qué no, cómo medir cuánto Photon usa tu query, un benchmark con/sin Photon y la cuenta de cuándo el DBU extra se paga solo.
Tu pipeline tarda 40 minutos. Ya optimizaste las particiones, ya cacheaste lo que había que cachear, ya revisaste el shuffle. Y un día alguien tilda un checkbox en la configuración del cluster y el mismo job baja a 15 minutos. Sin tocar una línea de código.
Ese checkbox es Photon: el motor de ejecución vectorizado de Databricks, escrito en C++, que reemplaza la ejecución JVM de Spark en las operaciones que soporta. En este post vemos qué hace por abajo, dónde conviene, dónde no hace nada, y cómo medir si te está sirviendo.
NotaTL;DR
- Photon reemplaza el motor de ejecución JVM de Spark por un runtime nativo en C++ que procesa datos en batches columnares con instrucciones SIMD.
- No cambiás código: Catalyst sigue planificando la query; Photon toma la capa de ejecución y hace fallback transparente a Spark cuando encuentra algo que no soporta.
- Viene activo en SQL Warehouses, serverless y pipelines declarativos serverless; en jobs y all-purpose classic es un checkbox (o
runtime_engine: PHOTONpor API). - Acelera scans, hash joins, aggregations, window functions y escrituras (MERGE, UPDATE, DELETE, CTAS) sobre Delta, Iceberg y Parquet.
- No acelera: UDFs, RDD API, Dataset API, streaming stateful, ni queries que ya corren en menos de 2 segundos.
- Las instancias Photon consumen DBUs a una tasa mayor: la cuenta cierra cuando el speedup supera el sobreprecio — y en workloads CPU-bound suele cerrar cómodo.
1. Qué es Photon y por qué existe
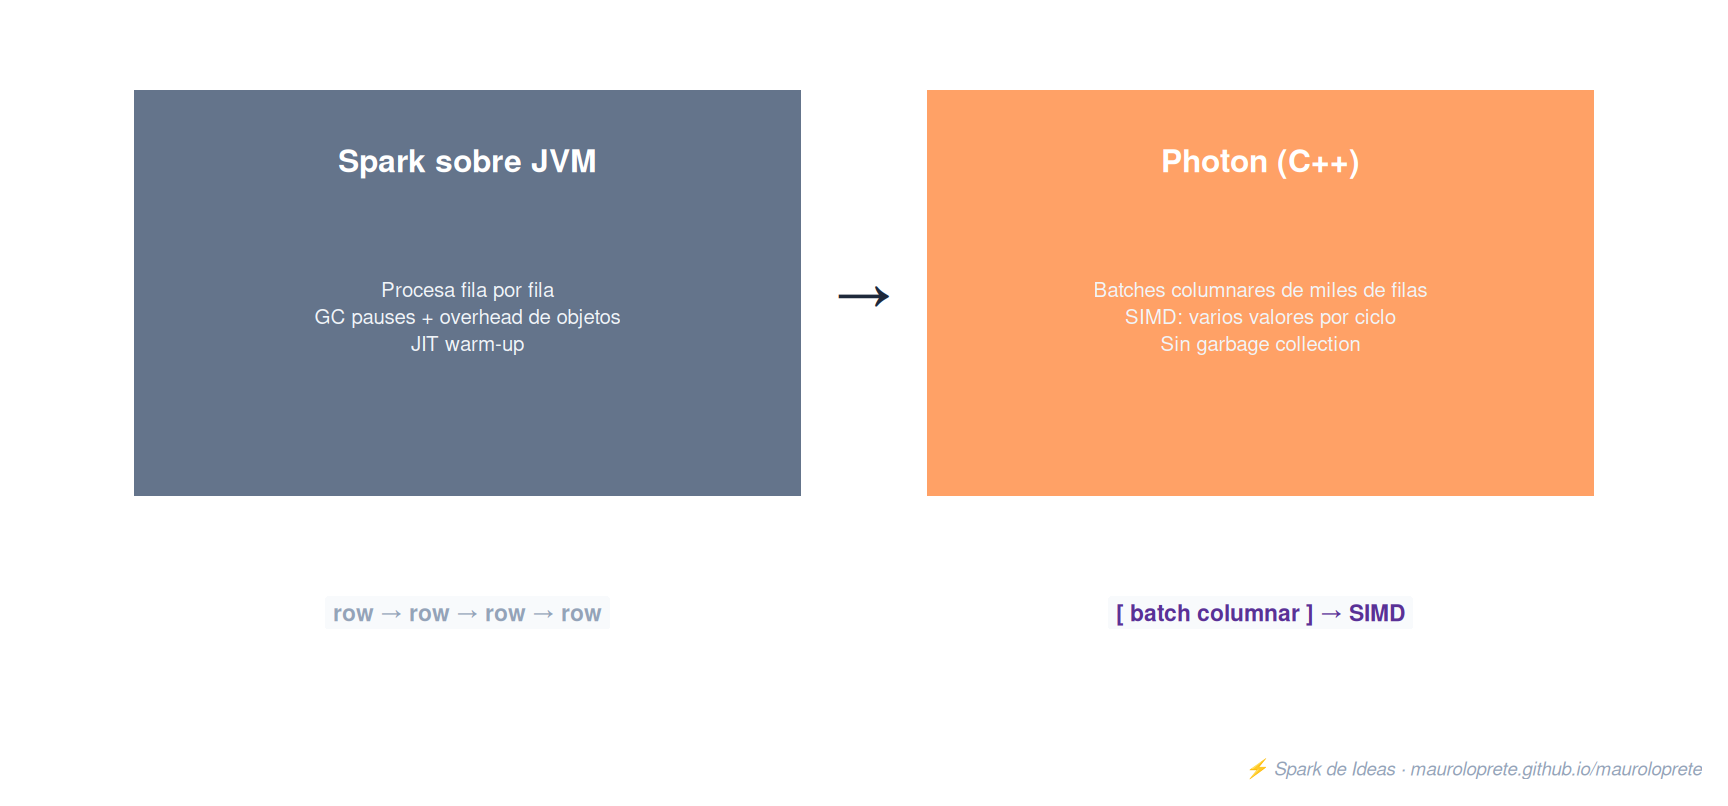
Spark ejecuta queries sobre la JVM — la máquina virtual de Java, el entorno donde corre casi todo el ecosistema big data. Eso funcionó durante una década, pero tiene tres costos estructurales:
- Las pausas de garbage collection (GC): la JVM frena todo periódicamente para limpiar la memoria que ya no se usa.
- El warm-up del JIT (just-in-time compiler): la JVM traduce el código a instrucciones de máquina mientras el programa corre, así que los primeros minutos siempre son más lentos.
- El overhead de memoria por objeto: cada fila arrastra bytes extra de estructura interna propios de Java.
Nada de esto era grave cuando el cuello de botella era el disco. Pero con SSDs y formatos columnares, el cuello de botella pasó a ser la CPU — y estos tres costos se volvieron el problema principal.
Photon ataca exactamente eso: reemplaza la ejecución JVM por un runtime nativo en C++ que procesa datos en batches columnares de miles de filas, habilitando instrucciones SIMD (Single Instruction, Multiple Data: el procesador aplica la misma operación a varios valores a la vez, en un solo ciclo). El acceso secuencial a memoria (columna por columna, no fila por fila) maximiza el ancho de banda de memoria y la eficiencia del pipeline del procesador.
El punto clave de diseño: Catalyst sigue siendo el optimizador. Photon no reemplaza el planner de Spark, reemplaza la capa de ejecución. Por eso es compatible con las APIs de Spark — SQL y DataFrames en Python, R, Scala y Java — sin cambios de código.
Nota
Según los benchmarks TPC-DS (el estándar de la industria para comparar motores analíticos: un set de queries de retail sobre datos sintéticos) que publica Databricks, Photon entrega hasta 5x mejor precio/performance que otros data warehouses cloud. Como todo benchmark de vendor, tomalo como cota superior — más abajo armamos uno propio.
2. Dónde corre (y dónde ya lo estás usando sin saberlo)
Photon no es un producto que contratás aparte: está integrado en el compute de Databricks. La diferencia es dónde viene activo por defecto y dónde es opt-in:
| Compute | Photon |
|---|---|
| SQL Warehouses (serverless, pro, classic) | Siempre activo — es el motor default |
| Serverless compute (notebooks, jobs) | Siempre activo |
| Lakeflow Declarative Pipelines serverless | Siempre activo |
| All-purpose y jobs compute classic | Activo por defecto en la UI — checkbox Use Photon Acceleration |
| Pipelines declarativos classic | Configurable por pipeline |
Si usás SQL Warehouses (los vimos en Tips #9), ya venís corriendo Photon en cada dashboard y query ad hoc.
Importante
Si creás clusters por API (Clusters API, Jobs API) o por DABs, Photon NO se activa solo: tenés que setear runtime_engine: PHOTON explícitamente. Es un clásico: el cluster de desarrollo creado por UI vuela, el job productivo deployado por CI/CD va lento, y nadie entiende por qué.
En un Databricks Asset Bundle, el job cluster queda así:
resources:
  jobs:
    etl_ventas:
      name: etl-ventas
      job_clusters:
        - job_cluster_key: main
          new_cluster:
            spark_version: "17.3.x-scala2.13"
            node_type_id: Standard_E8ds_v5
            num_workers: 4
            runtime_engine: PHOTON   # <- sin esto, corre JVM clásico
Y en la Pipelines API, el flag es photon: true.
3. Qué acelera: operadores y expresiones cubiertas
Photon no cubre el 100% de Spark. Cubre los operadores que dominan el tiempo de ejecución de un workload analítico típico:
| Categoría | Cobertura |
|---|---|
| Scan | Parquet, Delta, CSV, JSON — con filter pushdown, dictionary pruning y row-group skipping |
| Joins | Hash join (reemplaza sort-merge), nested-loop, null-aware anti join, spatial joins |
| Aggregations | Hash aggregate, incluyendo Min/Max/MinBy/MaxBy sobre tipos anidados |
| Shuffle | Shuffle columnar rediseñado para joins a gran escala |
| Sort / Window | Sort, TopK, Limit, window functions |
| Writes | Delta, Iceberg y Parquet: INSERT, UPDATE, DELETE, MERGE INTO, CTAS (CREATE TABLE AS SELECT) |
| Expresiones | Comparación, aritmética, condicionales (IF/CASE), strings, casts, fechas/timestamps |
| Tipos | Numéricos, string/binary, decimal, date/timestamp, struct, array, map, variant, geometry/geography |
Dos detalles que valen la pena subrayar:
Los joins cambian de estrategia. Photon reemplaza sort-merge joins por hash joins de alta performance. Si venís de pelear con sort-merge joins gigantes, esto solo puede justificar el cambio.
El shuffle también es columnar. No es solo ejecución de operadores: el shuffle fue rediseñado para mover batches columnares, lo que aumenta el throughput en joins grandes.
Tip
La lista de expresiones es representativa, no exhaustiva, y crece con cada runtime. Si una función puntual te importa, verificala con EXPLAIN (sección 5) en tu versión de DBR en lugar de confiar en listas de blogs — incluido este.
4. El fallback transparente: tu query nunca falla por Photon
¿Qué pasa cuando la query usa algo que Photon no soporta? Nada dramático: Photon hace fallback al runtime de Spark para esa porción de la ejecución y la query produce el resultado correcto igual.
Esto tiene una consecuencia práctica importante: una misma query puede correr parte en Photon y parte en JVM. El plan de ejecución se vuelve mixto, y cada transición Photon → JVM implica convertir datos columnares a filas (y viceversa), lo que tiene su propio costo.
Advertencia
El fallback es silencioso. No hay error, no hay warning en el notebook — solo una query más lenta de lo que esperabas. Por eso la sección 5 (monitoreo) no es opcional: si no medís cuánto de tu query corre en Photon, no sabés si lo estás aprovechando o pagando de más.
Los sospechosos habituales que fuerzan fallback:
- UDFs (User Defined Functions: funciones que escribís vos en Python o Scala para usar dentro de una query) en el medio del plan
- RDD API o Dataset API (los lambdas tipados de Scala)
- Operadores de streaming stateful
- Expresiones puntuales aún no cubiertas
5. Cómo medir cuánto Photon usa tu query
No adivines: Databricks te muestra exactamente qué parte del plan corrió en Photon.
En SQL Warehouses y serverless — Query Profile. La vista Execution Details muestra el porcentaje del task time que corrió en Photon. En el plan, los operadores Photon aparecen en violeta y los estándar en gris. Un número: si tu query pasa menos del 80% del tiempo en Photon, hay algo (casi siempre una UDF o un formato) forzando fallback.
En clusters classic — Spark UI. En la pestaña SQL/DataFrame, el DAG (el diagrama de flujo del plan, paso por paso) pinta los operadores Photon en naranja y los de Spark en azul. Visual e inmediato.
En código — EXPLAIN. Los nodos Photon aparecen con prefijo en el plan físico:
spark.sql("""
    SELECT categoria, SUM(monto) AS total
    FROM ventas
    WHERE fecha >= '2026-01-01'
    GROUP BY categoria
""").explain()

# == Physical Plan ==
# AdaptiveSparkPlan isFinalPlan=false
# +- PhotonResultStage
#    +- PhotonGroupingAgg(keys=[categoria], functions=[finalmerge_sum(...)])
#       +- PhotonShuffleExchangeSource
#          +- PhotonShuffleMapStage
#             +- PhotonGroupingAgg(keys=[categoria], functions=[partial_sum(...)])
#                +- PhotonScan parquet ventas (filters: fecha >= 2026-01-01)
Si en lugar de PhotonScan ves FileScan, o aparece un ColumnarToRow en el medio del plan, ahí tenés la transición a JVM.
6. Cómo leer un query plan de Spark (sin llorar)
El EXPLAIN de la sección anterior no sirve de nada si el plan te parece jeroglífico. La buena noticia: el 90% de la interpretación se reduce a tres reglas y a conocer media docena de nodos.
Regla 1 — se lee de abajo hacia arriba. El nodo más indentado (la hoja) es el primer paso: casi siempre un scan. El nodo de arriba de todo es el resultado. El plan es un árbol donde los datos fluyen de las hojas a la raíz.
Regla 2 — Exchange = shuffle = el nodo caro. Cada Exchange (o PhotonShuffleExchange) significa mover datos entre workers por la red. Contá cuántos hay: es el mejor predictor del costo de la query. Un GROUP BY mete uno; un join entre tablas grandes mete dos.
Regla 3 — el plan que ves puede no ser el que corre. La primera línea suele decir AdaptiveSparkPlan isFinalPlan=false: con AQE (Adaptive Query Execution), Spark re-optimiza en runtime usando estadísticas reales de cada stage. El plan final lo ves en el Spark UI después de ejecutar, no en el EXPLAIN de antes.
Veamos un join típico con su plan anotado:
spark.sql("""
    SELECT s.region, SUM(v.monto) AS total
    FROM ventas v
    JOIN sucursales s ON v.store_id = s.store_id
    GROUP BY s.region
""").explain()

# == Physical Plan ==                          (leer de abajo hacia arriba)
# AdaptiveSparkPlan isFinalPlan=false           <- 6. AQE puede re-optimizar
# +- PhotonGroupingAgg(keys=[region],
#       functions=[finalmerge_sum(...)])        <- 5. agg final post-shuffle
#    +- PhotonShuffleExchangeSource             <- 4. shuffle por region (caro)
#       +- PhotonGroupingAgg(keys=[region],
#             functions=[partial_sum(...)])     <- 3. pre-agrega en cada worker
#          +- PhotonBroadcastHashJoin           <- 2. sucursales viaja entera
#             :- PhotonScan parquet ventas
#             :     (filters: store_id IS NOT NULL,
#             :      requiredSchema: store_id, monto)   <- 1. lee solo 2 columnas
#             +- PhotonShuffleExchangeSource [broadcast]
#                +- PhotonScan parquet sucursales
Lo que este plan te está contando:
| Qué mirás | Qué te dice |
|---|---|
PhotonScan + requiredSchema |
Column pruning: solo lee las columnas que la query necesita. Si ves 40 columnas para un SUM de una, algo anda mal (típico SELECT * intermedio). |
filters: / PushedFilters: en el scan |
Los filtros bajaron al scan: se descartan row groups enteros sin leerlos. Si tu WHERE no aparece acá, lo estás filtrando después de leer todo. |
BroadcastHashJoin |
La tabla chica viaja entera a cada worker — no hay shuffle de la grande. Es el join barato; Spark lo elige si la chica está bajo el umbral de broadcast. |
SortMergeJoin |
El join “pesado” clásico: shuffle + sort de ambos lados. Con Photon vas a ver PhotonShuffledHashJoin en su lugar — hash join sin el sort. |
partial_sum → finalmerge_sum |
Aggregation en dos fases: cada worker pre-agrega antes del shuffle, así por la red viaja lo mínimo. Esto es lo normal y está bien. |
ColumnarToRow / RowToColumnar |
El peaje Photon ↔︎ JVM del que hablamos en la sección 4. Uno al final del plan es normal; varios en el medio son un fallback comiéndote el speedup. |
Tip
En runtimes con Photon, el EXPLAIN incluye al final una sección Photon Explanation que lista explícitamente qué operadores no corren en Photon y por qué (una UDF, una expresión no soportada). Es la forma más rápida de diagnosticar un fallback sin abrir el Spark UI.
Nota
Para planes largos, df.explain("formatted") es mucho más legible que el default: numera los operadores, muestra el árbol compacto arriba y el detalle de cada nodo abajo. Y para ver el plan final post-AQE con métricas reales (filas por stage, spill, tiempos), el lugar es la pestaña SQL/DataFrame del Spark UI — donde además los nodos Photon aparecen en naranja.
7. Lab: benchmark con/sin Photon
Basta de teoría. El experimento es simple: mismo cluster, mismo código, con y sin el checkbox. Armamos una tabla estilo TPC-DS (ventas con dimensiones) lo suficientemente grande para que la CPU sea el cuello de botella, y le tiramos una query con join + aggregation + window.
Paso 1 — generar datos (~200M de filas, unos 6 GB en Delta):
from pyspark.sql import functions as F

(
    spark.range(200_000_000)
    .withColumn("store_id", (F.col("id") % 500).cast("int"))
    .withColumn("item_id", (F.col("id") % 100_000).cast("int"))
    .withColumn("fecha", F.date_add(F.lit("2025-01-01"), (F.col("id") % 540).cast("int")))
    .withColumn("cantidad", (F.col("id") % 10 + 1).cast("int"))
    .withColumn("precio", F.round(F.rand(seed=42) * 500, 2))
    .write.mode("overwrite")
    .saveAsTable("lab.photon_bench.store_sales")
)
Paso 2 — la query (scan + filtro + join implícito por agregación + window, todo territorio Photon):
import time

query = """
    WITH ventas_diarias AS (
        SELECT store_id, fecha,
               SUM(cantidad * precio) AS revenue,
               COUNT(DISTINCT item_id)  AS items_distintos
        FROM lab.photon_bench.store_sales
        WHERE fecha >= '2025-06-01'
        GROUP BY store_id, fecha
    )
    SELECT store_id, fecha, revenue,
           AVG(revenue) OVER (
               PARTITION BY store_id ORDER BY fecha
               ROWS BETWEEN 6 PRECEDING AND CURRENT ROW
           ) AS revenue_7d
    FROM ventas_diarias
    ORDER BY store_id, fecha
"""

runs = []
for i in range(5):
    spark.sql("CLEAR CACHE")
    t0 = time.perf_counter()
    spark.sql(query).write.mode("overwrite").format("noop").save()
    runs.append(time.perf_counter() - t0)

print(f"wall-clock: mediana {sorted(runs)[2]:.1f}s | runs: {[f'{r:.1f}' for r in runs]}")
Paso 3 — correrlo dos veces: una en un cluster con runtime_engine: PHOTON y otra en un cluster idéntico con STANDARD. El lab completo (bundle con los dos jobs, listo para databricks bundle run) está en spark-de-ideas-labs.
Tip
El sink noop es el truco del benchmark honesto: ejecuta todo el plan (scan, shuffle, aggregation, window) sin escribir a ningún lado, así medís compute puro sin ruido de I/O de salida. Y CLEAR CACHE entre corridas evita que el disk cache te infle los resultados de las repeticiones.
Los resultados reales
Lo corrí en Azure Databricks: dos job clusters idénticos (driver + 1 worker Standard_D4s_v3, DBR 17.3 LTS), la única diferencia el runtime_engine. Cinco corridas por motor:
| Motor | Corridas (s) | Mediana |
|---|---|---|
| STANDARD (JVM) | 26.3 · 11.0 · 11.4 · 10.4 · 10.9 | 11.0s |
| PHOTON | 15.5 · 6.8 · 6.7 · 6.5 · 6.2 | 6.7s |
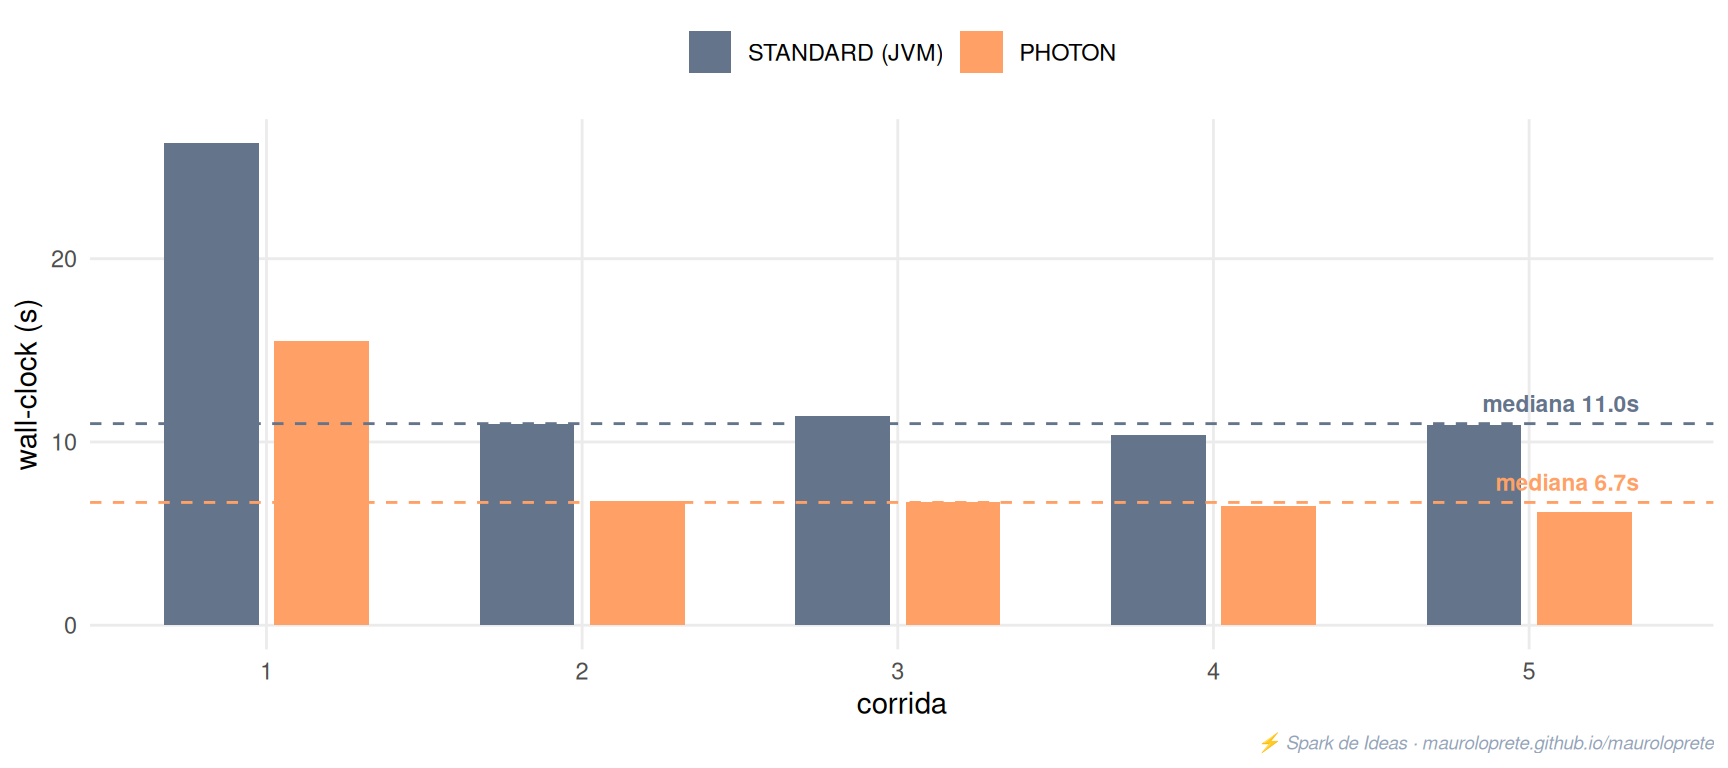
Speedup: 1.64x para esta query, en este hardware. Tres cosas para leer de ahí:
- La primera corrida miente en los dos motores (26.3s y 15.5s): paga el warm-up del JIT, las conexiones al storage y la inicialización del shuffle. Por eso la mediana y no el promedio.
- 1.64x es menos que los 2x-4x de los benchmarks de marketing — y está bien que así sea: es un cluster chico, una query de ~10 segundos y un dataset de 6 GB. El speedup de Photon crece con el tamaño del scan y la complejidad de las aggregations. Este número es tu piso, no tu techo.
- Ojo con la cuenta del DBU (sección 11): con un multiplicador de ~2x, un speedup de 1.64x en este workload no se paga solo en plata — aunque sí en tiempo. Exactamente el tipo de decisión por-job de la que hablamos.
Y los planes de ejecución que devolvieron los dos runs — la misma query, dos mundos:
Sort [store_id ASC, fecha ASC]
+- Exchange rangepartitioning(store_id, fecha, 200)
   +- Window [avg(revenue) windowspecdefinition(...) AS revenue_7d]
      +- Sort [store_id ASC, fecha ASC]
         +- Exchange hashpartitioning(store_id, 200)
            +- HashAggregate(keys=[store_id, fecha], functions=[finalmerge_sum(...)])
               +- Exchange hashpartitioning(store_id, fecha, 200)
                  +- HashAggregate(keys=[store_id, fecha], functions=[partial_sum(...)])
                     +- Project [store_id, fecha, cantidad, precio]
+- Filter (fecha >= 2025-06-01)PhotonResultStage
+- PhotonColumnarToRow
+- PhotonSort [store_id ASC, fecha ASC]
+- PhotonShuffleExchangeSource
+- PhotonShuffleMapStage
+- PhotonShuffleExchangeSink rangepartitioning(store_id, fecha, 200)
+- PhotonWindow [avg(revenue) ... AS revenue_7d]
+- PhotonSort [store_id ASC, fecha ASC]
+- PhotonShuffleExchangeSource
+- PhotonShuffleMapStage
+- PhotonShuffleExchangeSink hashpartitioning(store_id, 200)
+- PhotonGroupingAgg(keys=[store_id, fecha], ...)Mismo árbol, mismos pasos — pero en el segundo hasta el shuffle es Photon (PhotonShuffleExchangeSink/Source), y el único ColumnarToRow está al final del plan, donde corresponde: una sola conversión, justo antes de devolver el resultado.
La evidencia visual: el Spark UI de cada run
Si nunca entraste: el Spark UI es la consola web que trae todo cluster de Spark, con el detalle de lo que pasó adentro del motor. En Databricks la encontrás en la página del cluster (o del job run), pestaña Spark UI. Adentro tiene tabs de Jobs, Stages, Executors… y la que nos importa acá: SQL/DataFrame, que lista cada query ejecutada con su duración, y al hacerle click te muestra el DAG del plan con métricas reales por operador — cuántas filas procesó cada nodo, cuánto tardó cada stage. Y en Databricks los nodos vienen pintados: azul = JVM, naranja = Photon. Es literalmente ver el fallback (o su ausencia) con los ojos.
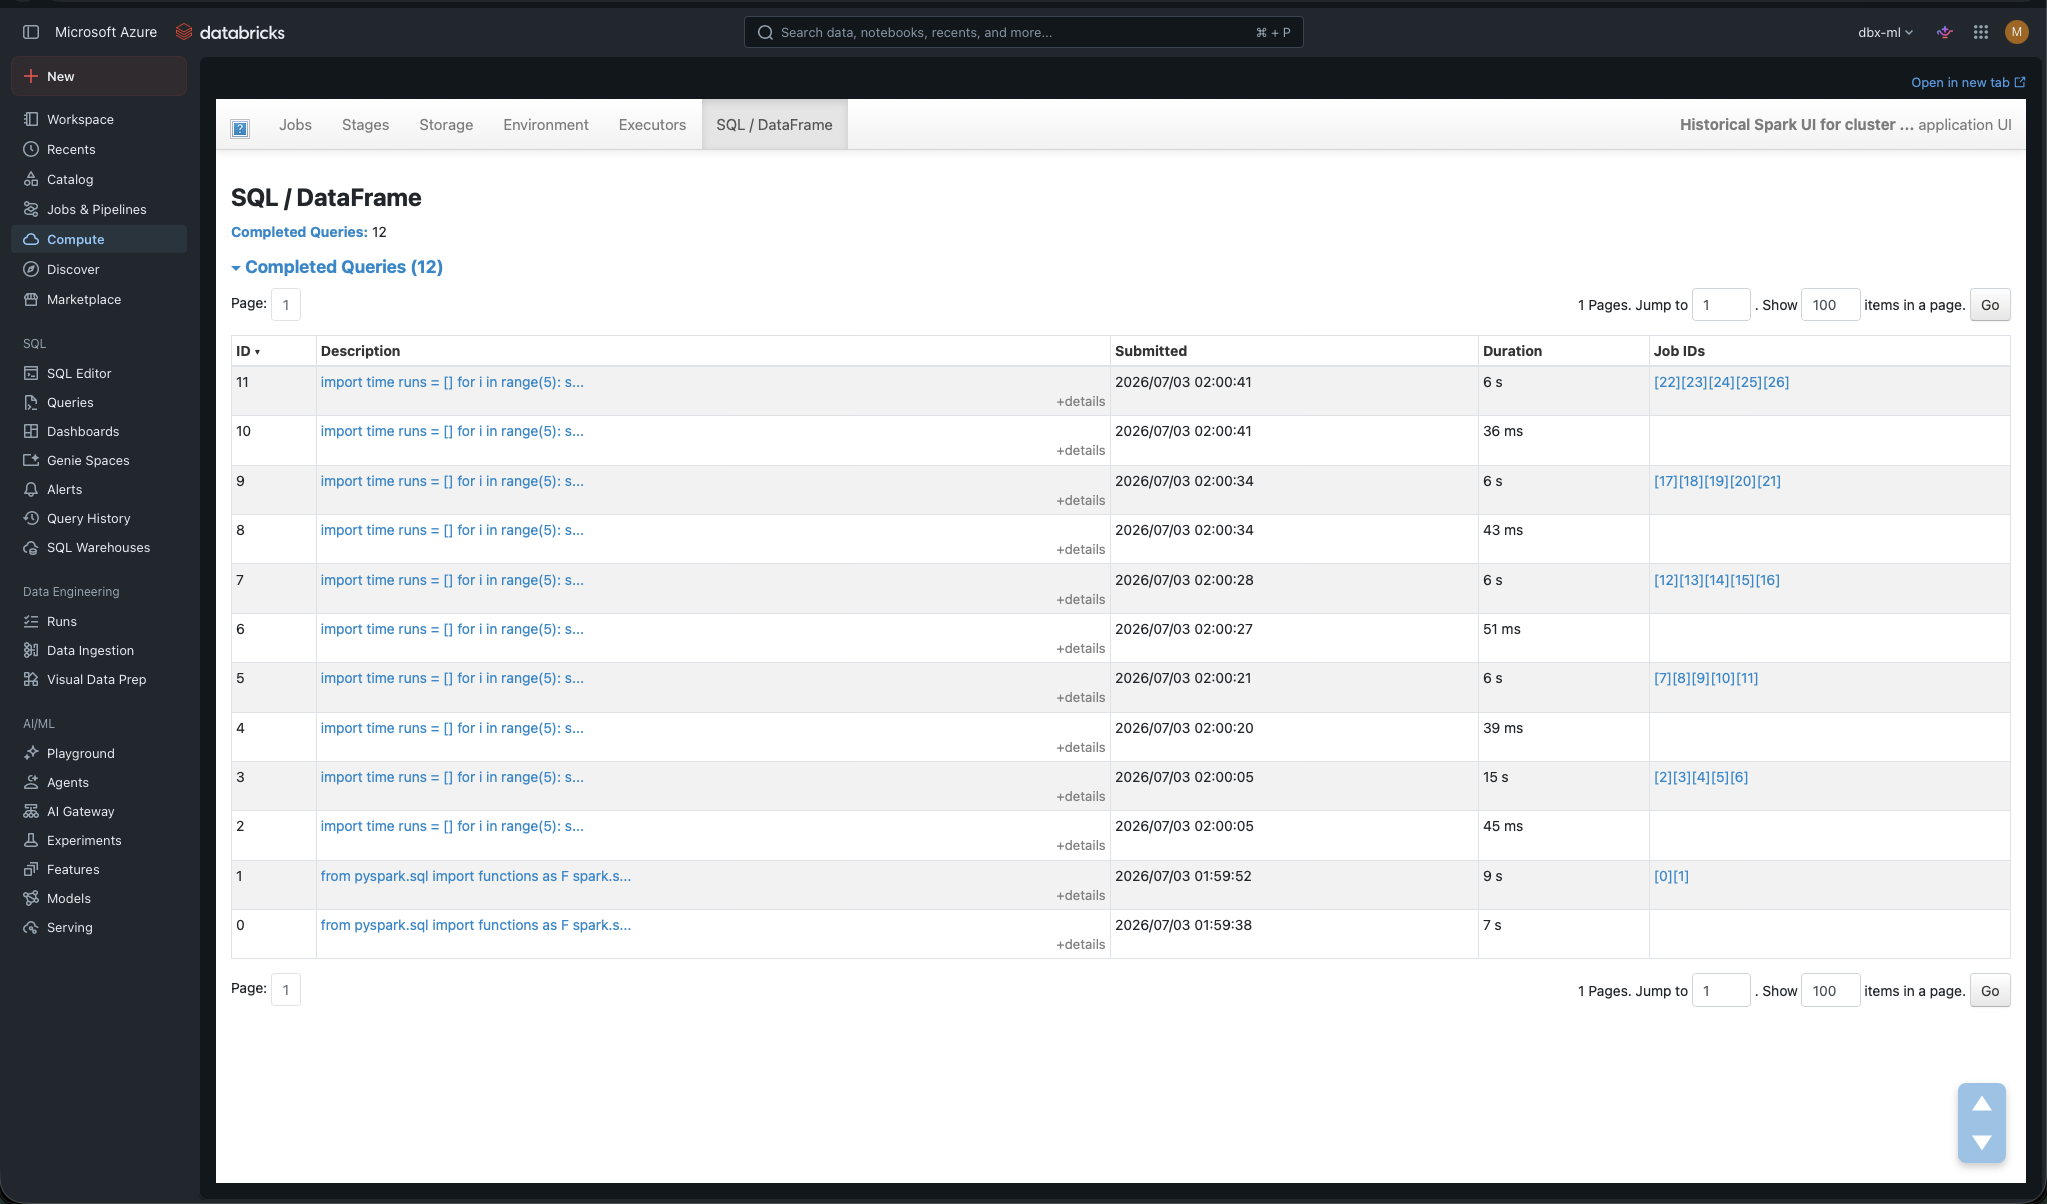
CLEAR CACHE, el count). Clic en cualquiera y se abre el DAG con sus métricas.Esto es lo que devolvieron los dos runs del benchmark:
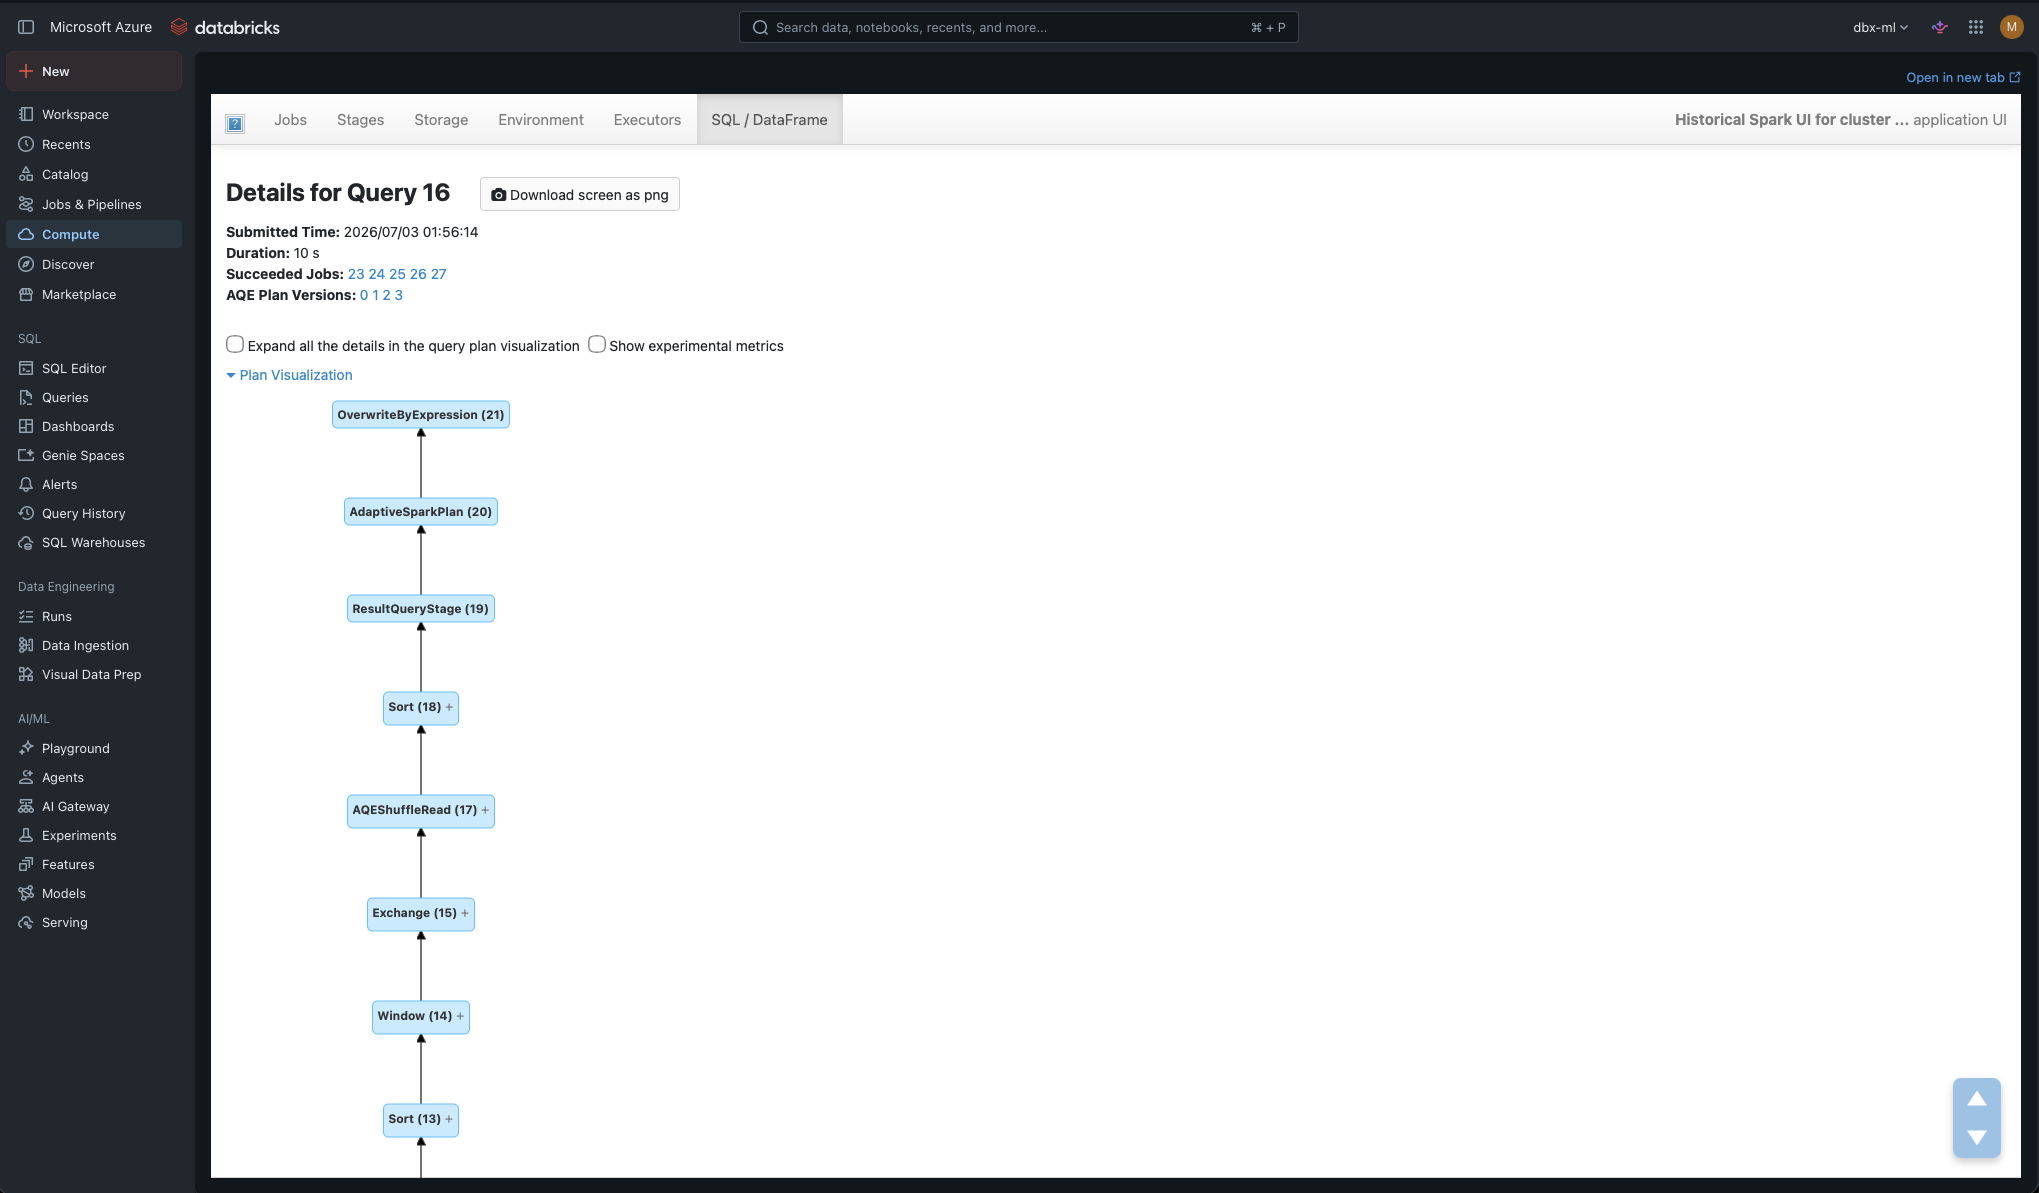
Exchange, y el Window arriba.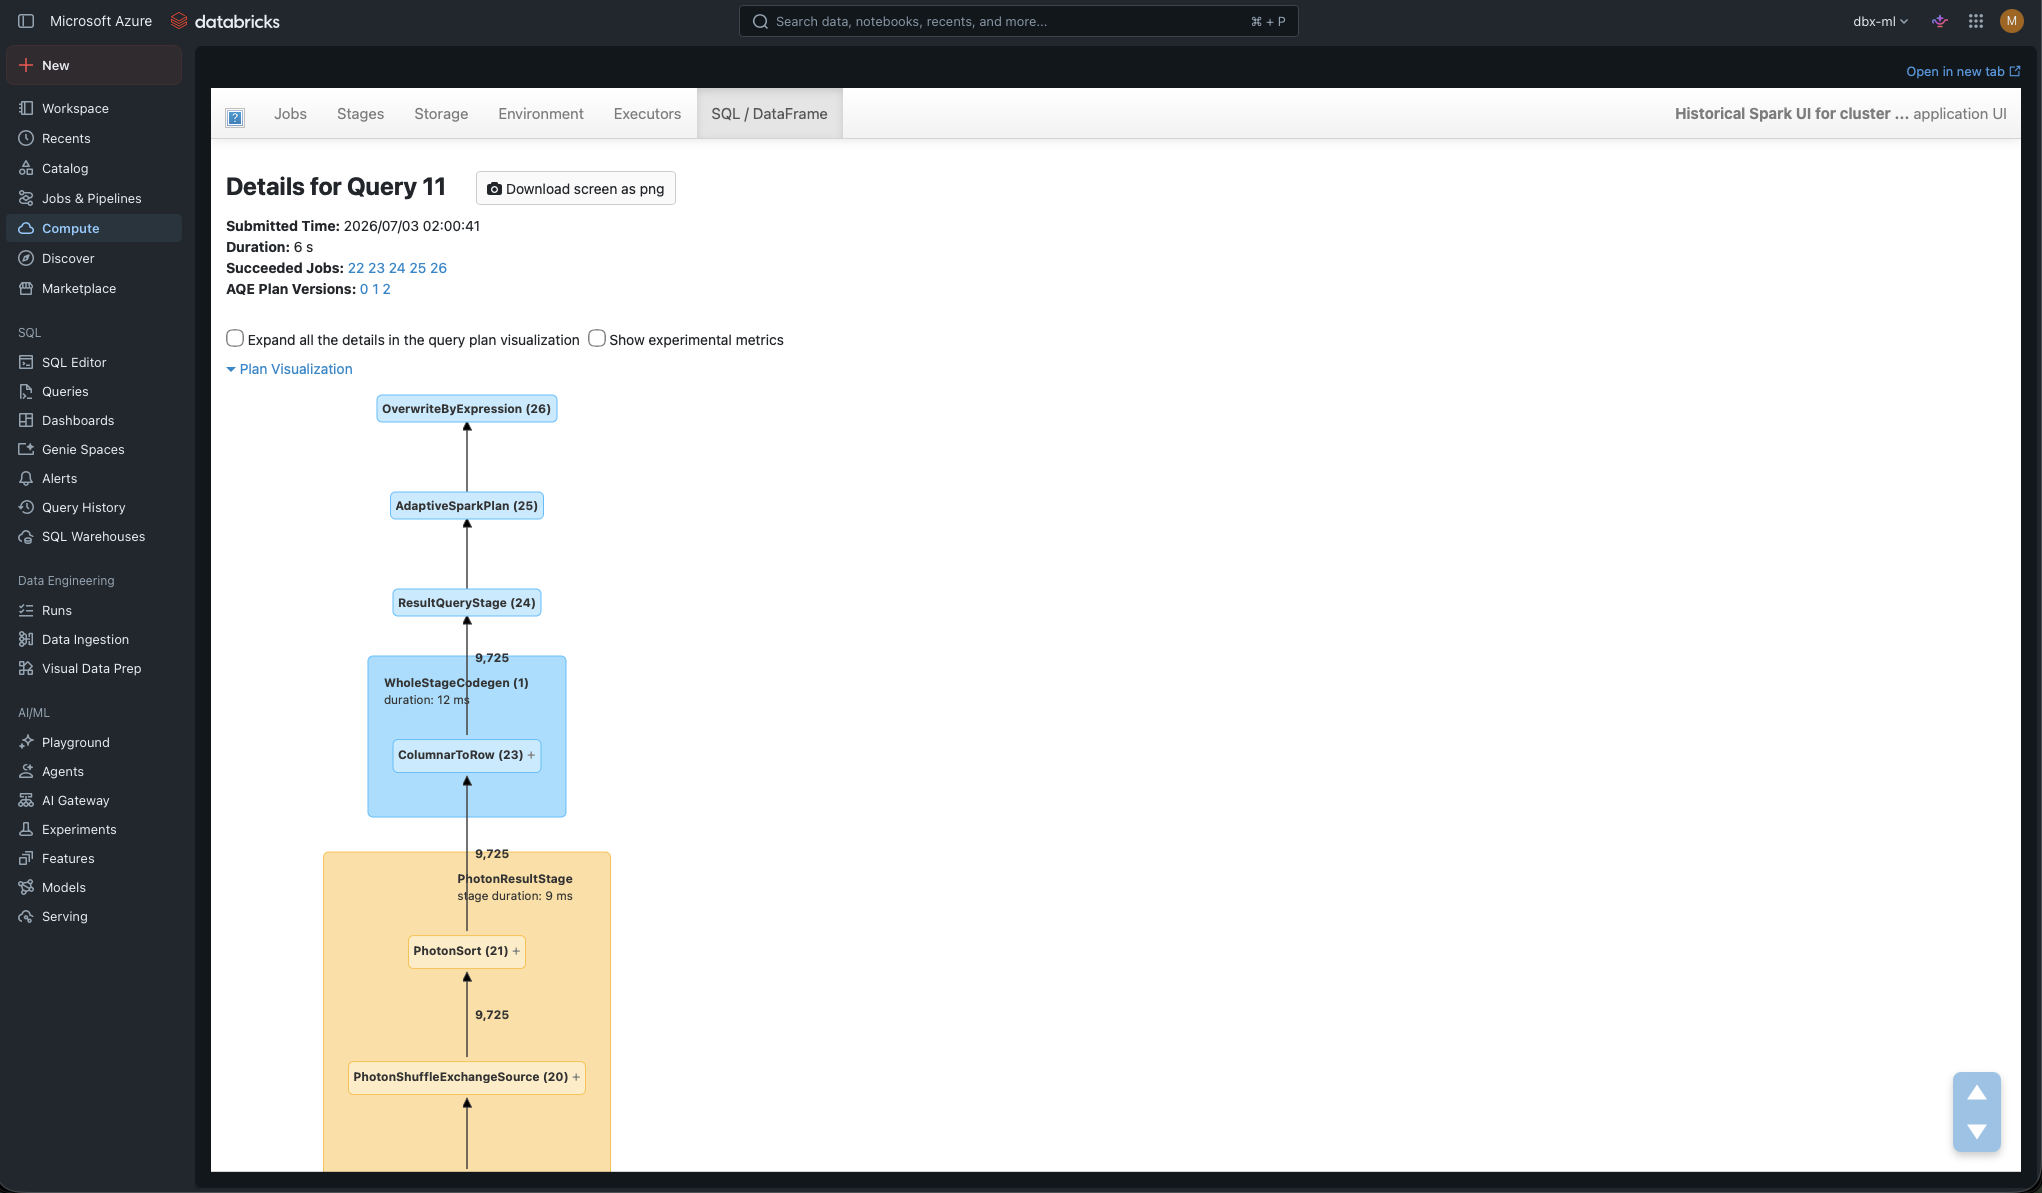
PhotonResultStage, PhotonSort, PhotonShuffleExchangeSource. El único bloque azul es el ColumnarToRow del final — la única conversión a filas, donde corresponde.Y acercándose al detalle de cada plan, los números por operador cuentan la historia completa:
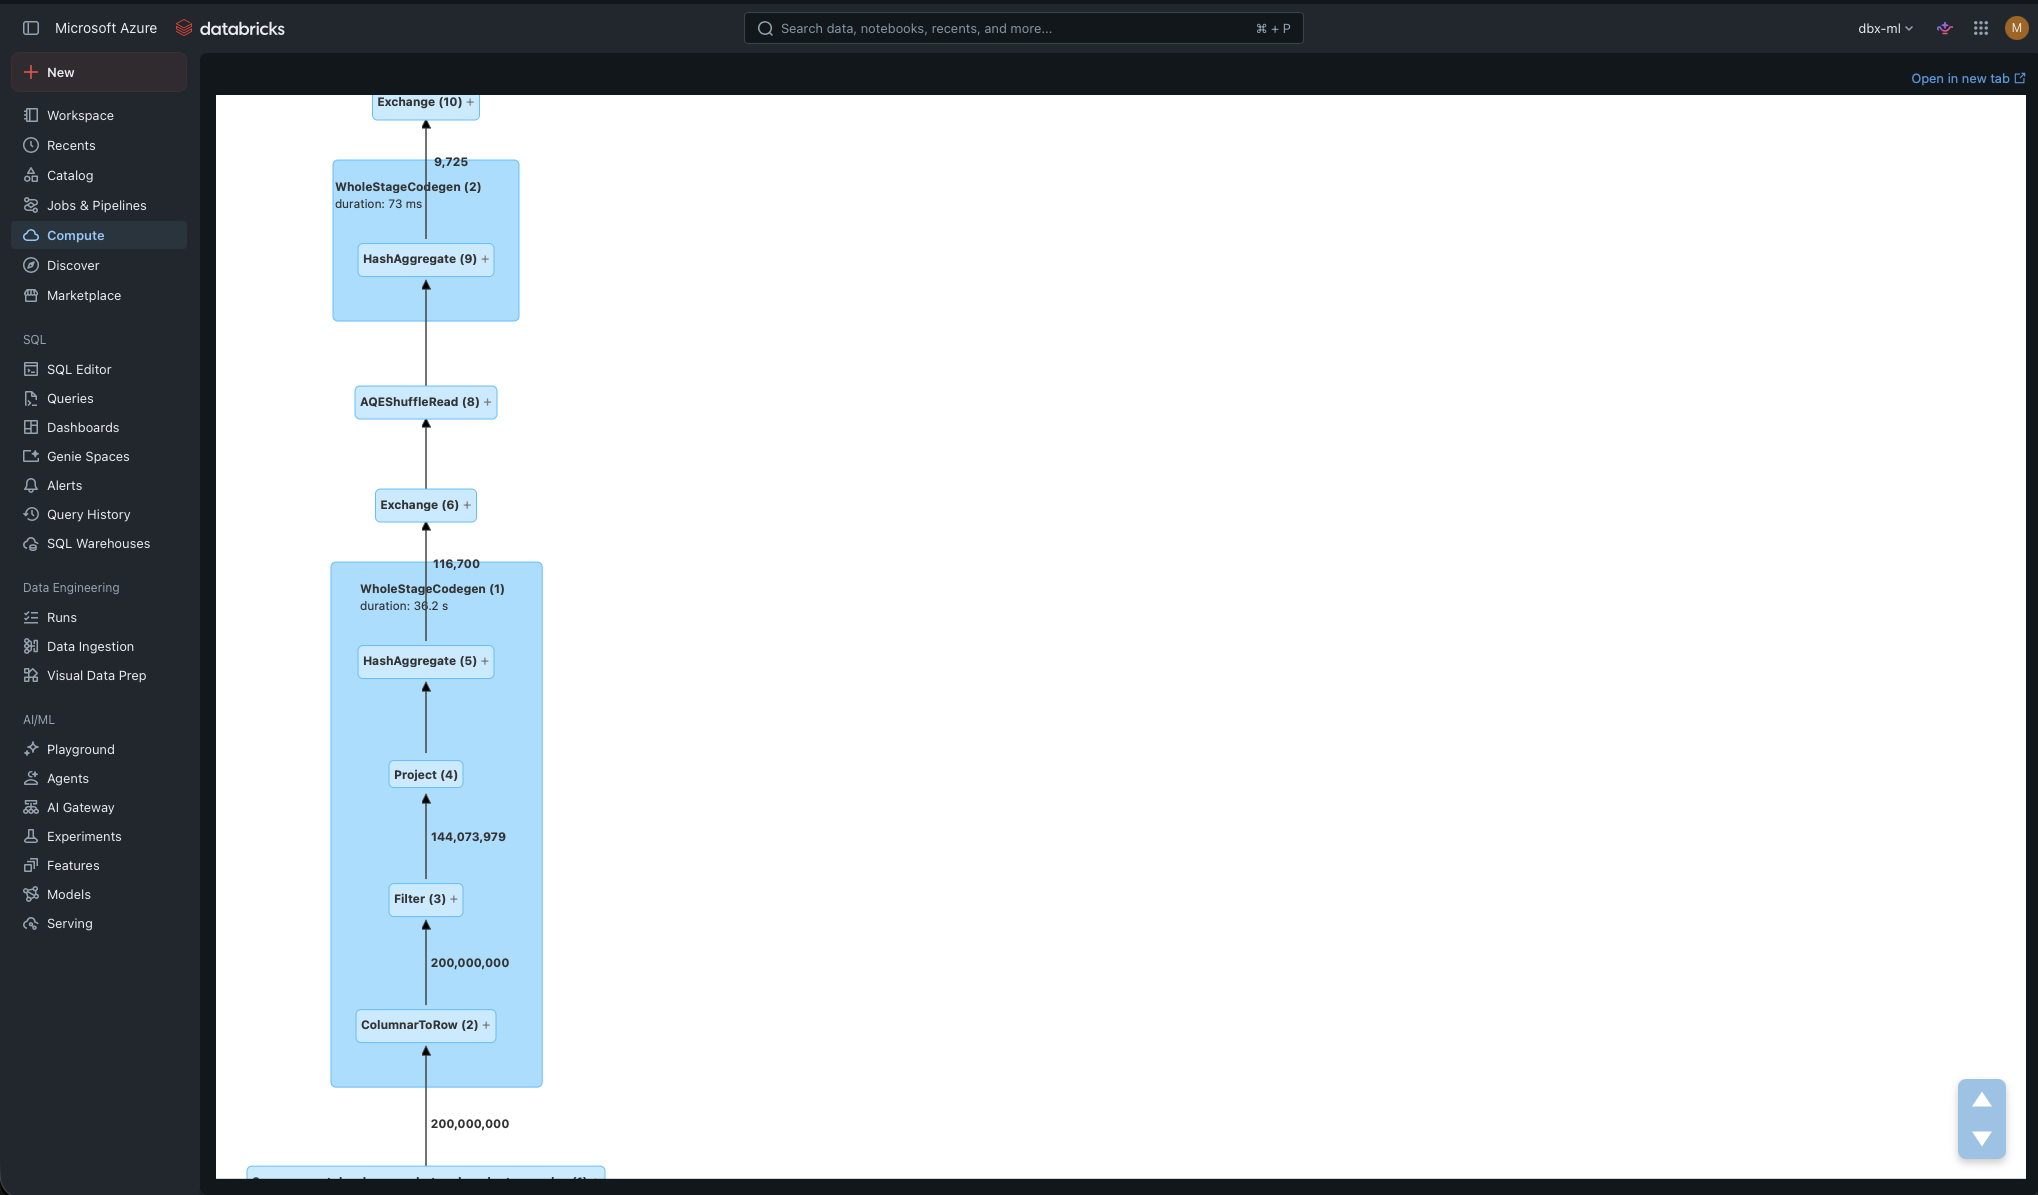
Filter recibe 200,000,000 filas del scan y deja pasar 144,073,979: primero lee todo, después filtra. El WholeStageCodegen que envuelve al HashAggregate acumula 36.2 s de task time — eso es la JVM generando código para procesar fila por fila.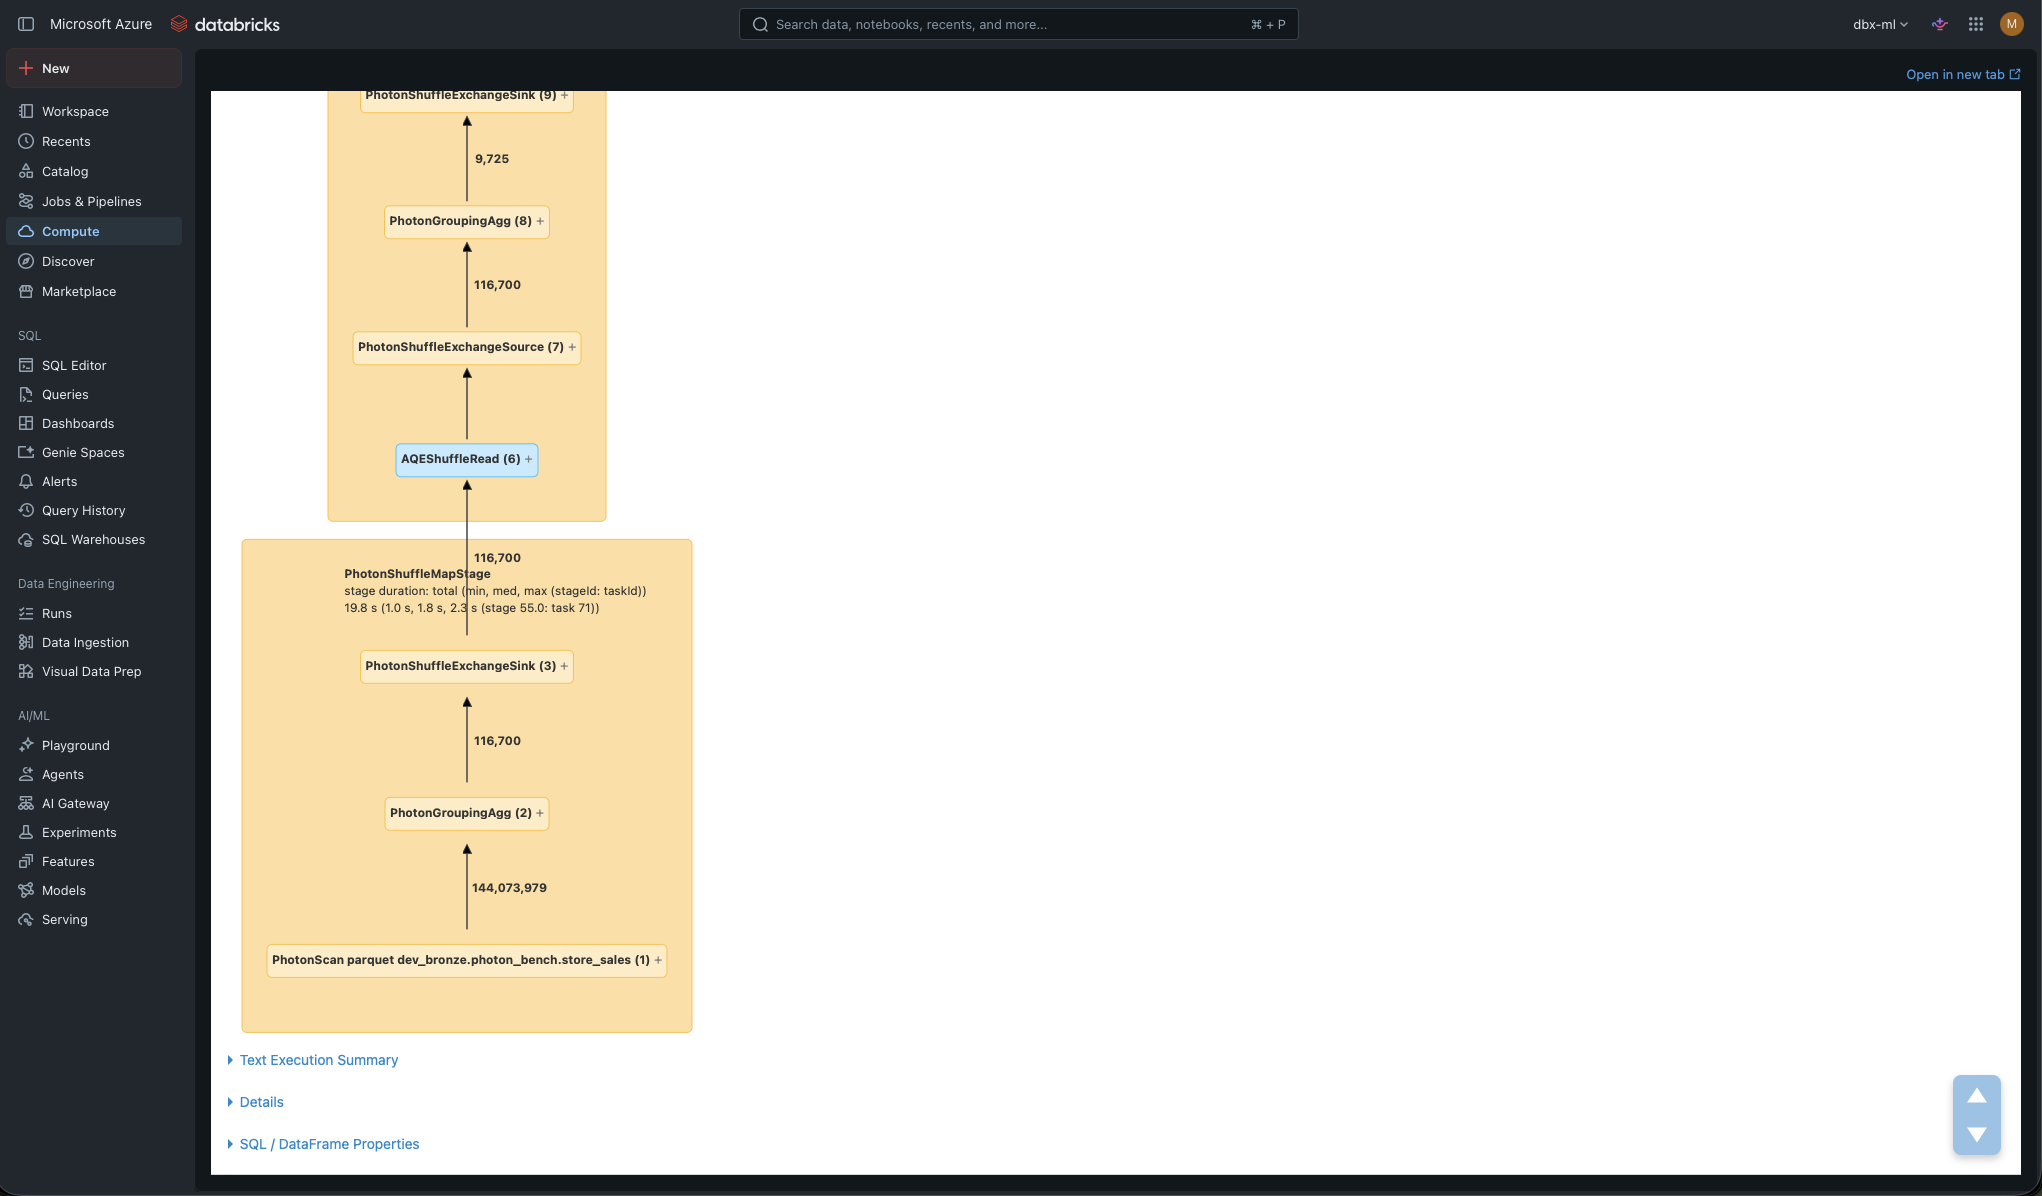
Filter: el filtro va embebido en el PhotonScan, que ya entrega las 144,073,979 filas filtradas. El PhotonGroupingAgg las reduce a 116,700 grupos (500 stores × ~233 días) antes del shuffle — por la red viaja lo mínimo.Dos datos escondidos en esas capturas que valen el zoom:
- El task time del
WholeStageCodegen(36.2 s) del lado JVM es exactamente el mecanismo que Photon reemplaza: Spark genera código Java en runtime para cada query; Photon ya es código nativo. - La reducción 144M → 116,700 antes del shuffle es el
partial_sumde la sección 6 en acción: se pre-agrega en cada worker y por la red viajan grupos, no filas.
Nota
Bonus del lab: en una corrida anterior, por un tema de cuota de Azure, el cluster de Photon quedó con 1 worker contra 2 del STANDARD — y aun así ganó: 7.0s contra 11.5s. Photon con la mitad del hardware le ganó al JVM. No es la comparación que publicaría como benchmark, pero como anécdota dice bastante.
Mientras corre, abrí el Spark UI y mirá el DAG: en el cluster con Photon todo el plan debería estar en naranja. Si algo aparece en azul, encontraste un fallback — y una oportunidad de entender por qué.
8. Escrituras: donde Photon sorprende
El reflejo es asociar Photon con queries de lectura, pero el native Parquet writer acelera también las escrituras a Delta, Iceberg y Parquet: INSERT, UPDATE, DELETE, MERGE INTO y CREATE TABLE AS SELECT.
Dos casos donde esto se nota fuerte:
- Tablas anchas: con cientos o miles de columnas, la mejora de escritura es especialmente significativa. Si laburás con feature tables desnormalizadas o extractos de sistemas legacy con 800 columnas, esto es para vos.
- MERGE pesados: el MERGE de tu pipeline de CDC (Change Data Capture: replicar los cambios — inserts, updates, deletes — de un sistema fuente; lo vimos con AUTO CDC en Tips #11) combina scan + join + write — las tres cosas que Photon acelera a la vez.
9. Las features que directamente NO existen sin Photon
Photon no es solo “lo mismo pero más rápido”: hay optimizaciones del platform que requieren Photon habilitado:
- Predictive I/O para lecturas y escrituras — el heurístico que decide qué archivos leer y cómo, clave para deletion vectors y para acelerar point-lookups.
- Dynamic file pruning en MERGE, UPDATE y DELETE — sin Photon, esas operaciones DML no podan archivos dinámicamente y terminan escaneando mucho más de lo necesario.
Importante
Este es el argumento que suele faltar en la discusión de costos: apagar Photon en un job con MERGEs grandes no solo te saca el speedup de ejecución — te apaga dynamic file pruning en el MERGE. El job no vuelve a “la velocidad normal de Spark”: vuelve a algo peor que lo que mediste antes de optimizar.
10. Lo que Photon no hace (y no va a hacer por ahora)
La lista corta pero importante:
- UDFs: ni Python ni Scala. Una UDF en el medio del plan corta la ejecución Photon y fuerza el paso a JVM (con la conversión columnar → filas incluida). Antes de escribir una UDF, agotá las funciones built-in — la sección de expresiones de Photon cubre muchísimo más de lo que la gente cree.
- RDD API y Dataset API: si tenés código Scala con lambdas tipados (
ds.map(x => ...)), Photon no participa. El costo de la “type safety” del Dataset API ahora también se mide en DBUs. - Streaming stateful: aggregations con estado,
mapGroupsWithState, joins stream-stream — no soportados. Photon solo acelera streaming stateless (transformaciones + write a Delta/Parquet, con sources Delta, Parquet, CSV, JSON, Kafka y Kinesis). - Queries de menos de 2 segundos: el tiempo se va en planning y scheduling, no en ejecución. Photon no puede acelerar lo que no domina el runtime.
11. La cuenta: cuándo el DBU extra se paga solo
Primero la sigla: el DBU (Databricks Unit) es la unidad con la que Databricks factura el compute — cada tipo de instancia consume una cantidad de DBUs por hora, y vos pagás DBUs además del costo de la VM de Azure. El detalle que importa acá: las instancias Photon consumen DBUs a una tasa mayor que las mismas instancias sin Photon (el multiplicador exacto depende del tipo de compute — chequealo en la página de pricing de Azure Databricks).
La cuenta es directa. Si el job corre en tiempo \(t\) con costo por hora \(c\), y con Photon corre en \(t/s\) (speedup \(s\)) con costo por hora \(c \cdot m\) (multiplicador \(m\)):
\[\text{Photon conviene si } s > m\]
Con un multiplicador típico cercano a 2x en jobs compute, necesitás un speedup mayor a 2x para ahorrar plata — y además terminás antes, que también vale. Los workloads CPU-bound (donde el cuello de botella es el procesador: aggregations anchas, joins grandes, MERGEs, escrituras masivas) suelen superarlo con margen; los I/O-bound (dominados por leer o escribir contra disco y red, donde la CPU está de vacaciones) o los llenos de UDFs, no.
Nuestro lab de la sección 7 es el ejemplo perfecto de la zona gris: speedup de 1.64x — el job termina un 40% antes, pero con multiplicador 2x la corrida sale un poco más cara. En un dataset 10x más grande, esa misma query probablemente cruce el umbral. Por eso la cuenta se hace por job y con datos propios, no con el benchmark de nadie más.
Tip
No decidas Photon “a nivel empresa”: decidilo por job. El benchmark de la sección 7 tarda 20 minutos en armarse y te da la respuesta real para tu workload. Jobs cortos, livianos o llenos de UDFs → sin Photon. Jobs pesados de SQL/DataFrame → con Photon, casi siempre.
12. Gotchas
- Clusters por API/DABs no activan Photon solos. La UI lo tilda por defecto, la API no:
runtime_engine: PHOTONo corrés en JVM sin enterarte. Auditá tus bundles hoy. - El fallback es silencioso. Una UDF nueva en un pipeline que venía volando puede duplicar el runtime sin que nada falle. Metric a vigilar: % de task time en Photon en el query profile.
ColumnarToRowen el plan = peaje. Cada transición Photon ↔︎ JVM convierte formatos. Muchas transiciones pequeñas pueden comerse el speedup completo.- Photon no arregla el small files problem. El scan es más eficiente incluso con archivos chicos, pero seguís pagando listing y overhead por archivo.
OPTIMIZEsigue siendo tu amigo. - No esperes nada en queries sub-2-segundos. Si tu dashboard hace 40 queries de 300ms, Photon no es tu palanca — mirá el disk cache y el diseño de las queries.
- El disk cache te miente en los benchmarks. La segunda corrida siempre da mejor.
CLEAR CACHEo cluster fresco entre mediciones. - Spot the engine: el plan te lo dice.
PhotonScanvsFileScanen elEXPLAINes el smoke test más rápido para saber si estás corriendo donde creés que estás corriendo. - Streaming: revisá si tu pipeline es stateful antes de asumir speedup. Un
dropDuplicateso una window aggregation en el stream lo vuelven stateful — y ahí Photon no juega.
13. Cuándo NO usar Photon
| Situación | Por qué | Alternativa |
|---|---|---|
| Jobs dominados por UDFs | Fallback constante, pagás el multiplicador sin speedup | Refactor a built-ins primero, Photon después |
| Queries cortas (<2s) | Planning domina el tiempo, no la ejecución | Disk cache, SQL warehouse serverless |
| Streaming stateful | No soportado — corre todo en JVM | Structured Streaming clásico (Tips #4) |
| Código RDD / Dataset API | Photon no participa | Migrar a DataFrame API (y después Photon) |
| Jobs I/O-bound (mover archivos, ingesta simple) | El cuello es la red/storage, no la CPU | Compute barato sin Photon |
| Presupuesto de migración cero y jobs ya rápidos | Sin dolor no hay ROI que justifique re-testing | Dejalo para el próximo ciclo |
Referencias
Otros posts de la serie
Si te sirvió este post, mirá los anteriores de Databricks Tips:
- Tips #1: Databricks Asset Bundles — IaC para Databricks
- Tips #2: Delta Lake — las 7 cosas que te hubiera gustado saber
- Tips #3: Unity Catalog — gobernanza que nadie implementa bien
- Tips #4: Structured Streaming — watermarks, triggers y micro-batch
- Tips #5: MLflow + Unity Catalog — del experimento al modelo
- Tips #6: Feature Engineering — features que sobreviven a producción
- Tips #7: Docker en Databricks — contenedores custom
- Tips #8: Jobs & Workflows — streaming y triggers event-driven
- Tips #9: SQL Warehouses — el compute que se prende solo
- Tips #10: AI Gateway — governance centralizada para LLMs
- Tips #11: Lakeflow Declarative Pipelines — pipelines declarativos con calidad built-in
Siguiente post de la serie: OpenSharing — compartir sin copiar. Y después: Liquid Clustering, el reemplazo de particiones y Z-ORDER.