Si empezara de cero… qué priorizaría aprender en Data Engineering
Podcast
Data Engineering
Carrera
Python, SQL, Spark, dbt, Databricks — el orden importa. Lo que aprendí después de años laburando con datos y lo que haría distinto si volviera a empezar.
TipMaterial del episodio
Soy Mauro Loprete, Data Engineer en F1RST (Grupo Santander). Tengo las dos certificaciones de Databricks — Data Engineer Professional y Associate — y estoy yendo por el MVP. Doy clases de Ciencia de Datos y Machine Learning en la UdelaR, y este podcast es mi forma de compartir lo que fui aprendiendo en el camino.
En este post cuento qué priorizaría hoy si tuviera que volver a empezar en Data Engineering. El orden importa, y mucho.
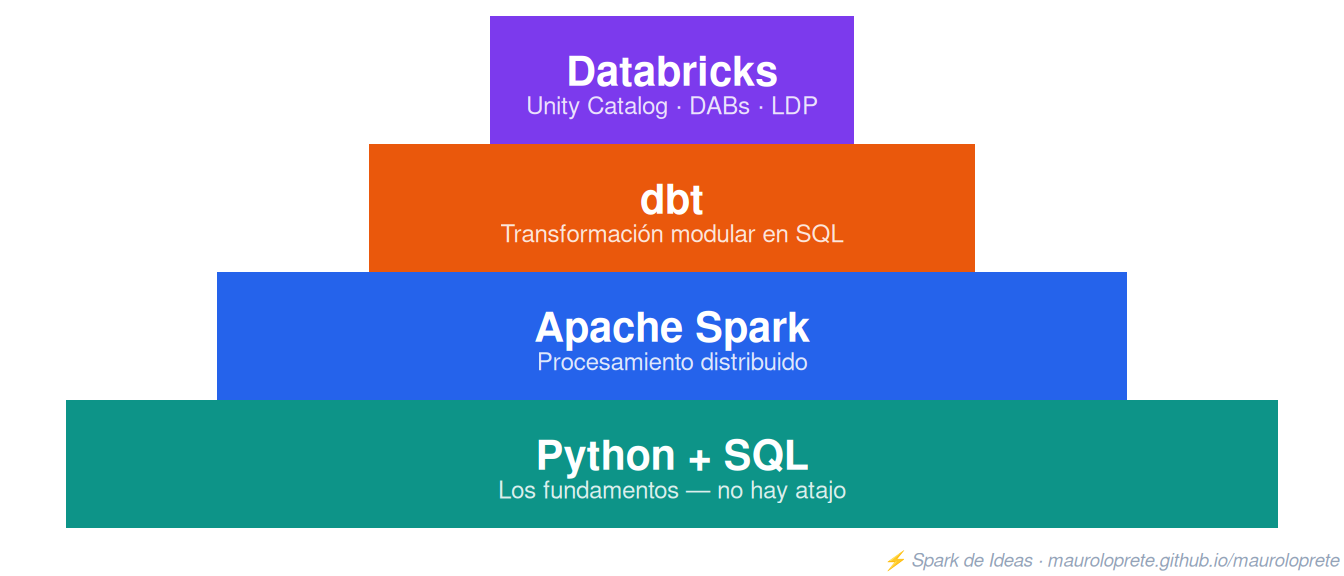
La pirámide: de abajo hacia arriba
No podés aprender Spark sin saber Python. No podés entender dbt sin dominar SQL. Y Databricks sin Spark es como manejar un auto de carrera sin saber frenar.
1. Python: la base de todo
No estoy hablando de hacer un print("Hola mundo"). Estoy hablando de:
- Estructuras de datos: listas, diccionarios, sets, tuplas. El 80% de lo que hacés en data es manipular estructuras.
- Funciones y decoradores: cuando labures con Spark o dbt, vas a necesitar entender cómo se componen las funciones.
- Manejo de archivos: JSON, CSV, YAML, Parquet. En data engineering vivís leyendo y escribiendo archivos.
- Entornos virtuales y dependencias:
venv,pip,pyproject.toml. Si no sabés manejar dependencias, tu primer proyecto en producción va a ser un desastre. - Testing básico:
pytest. No necesitás ser un experto en TDD, pero sí saber testear una función.
# Lo mínimo que tenés que dominar de Python
from dataclasses import dataclass
from typing import List, Optional
import json

@dataclass
class DataProduct:
    name: str
    owner: str
    tables: List[str]
    sla_hours: Optional[int] = None

    def is_critical(self) -> bool:
        return self.sla_hours is not None and self.sla_hours <= 4

# Leer config, parsear, validar — esto es el 60% del laburo real
with open("products.json") as f:
    products = [DataProduct(**p) for p in json.load(f)]

critical = [p for p in products if p.is_critical()]
Error que cometí: arranqué con pandas sin dominar Python puro. Después me costó el doble entender por qué las cosas no funcionaban. Primero Python, después las librerías.
Clases: por qué importan y cuándo usar cada tipo
En data engineering terminás modelando cosas todo el tiempo: configuraciones de pipelines, conexiones, resultados de validaciones, contratos de datos. Si todo lo hacés con diccionarios, te la pasás haciendo config["database"]["host"] y rezando que la key exista.
Las clases resuelven eso: te dan estructura, autocompletado en el IDE, y errores claros cuando algo falta.
El tema es que Python tiene varias formas de definir clases, y cada una tiene su lugar:
Clase tradicional — control total, pero mucho boilerplate:
class Pipeline:
    def __init__(self, name: str, source: str, target: str, schedule: str = "daily"):
        self.name = name
        self.source = source
        self.target = target
        self.schedule = schedule

    def __repr__(self):
        return f"Pipeline(name={self.name!r}, source={self.source!r})"

    def __eq__(self, other):
        return (self.name == other.name and self.source == other.source
                and self.target == other.target and self.schedule == other.schedule)

p = Pipeline("ingest_sales", "raw.sales", "silver.sales")
Son 12 líneas para algo que debería ser simple. Y si te olvidás del __eq__, dos pipelines con los mismos datos no van a ser iguales. Y si te olvidás del __repr__, debuggear es un dolor.
@dataclass — la opción correcta en el 90% de los casos:
from dataclasses import dataclass, field
from typing import Optional

@dataclass
class Pipeline:
    name: str
    source: str
    target: str
    schedule: str = "daily"
    tags: list[str] = field(default_factory=list)

    def full_target(self) -> str:
        return f"catalog.{self.target}"

p = Pipeline("ingest_sales", "raw.sales", "silver.sales")
print(p)  # Pipeline(name='ingest_sales', source='raw.sales', ...)
p == Pipeline("ingest_sales", "raw.sales", "silver.sales")  # True
5 líneas y te da __init__, __repr__, __eq__ gratis. Podés agregar métodos propios. Usá field(default_factory=list) para valores mutables por defecto (nunca pongas tags: list = [], es un bug clásico de Python).
@dataclass(frozen=True) — cuando el objeto no debería cambiar:
@dataclass(frozen=True)
class ConnectionConfig:
    host: str
    port: int
    database: str
    ssl: bool = True

# Esto funciona:
config = ConnectionConfig("db.prod.internal", 5432, "analytics")

# Esto falla (y es lo que querés):
config.host = "otro"  # FrozenInstanceError
Configuraciones, credenciales, resultados de validación — todo lo que no debería mutar después de crearse. Además las frozen dataclasses son hashables, así que las podés usar en sets y como keys de diccionarios.
¿Qué es inmutabilidad y por qué te importa?
Un objeto inmutable es uno que no se puede modificar después de crearlo. Y la pregunta obvia es: ¿para qué querría eso?
El problema de los objetos mutables es que cualquiera los puede cambiar en cualquier momento, y en un pipeline con muchas funciones eso se convierte en un desastre:
# Objeto MUTABLE — el problema
@dataclass
class Config:
    host: str
    port: int
    timeout: int = 30

config = Config("db.prod.internal", 5432)

# Función A lee la config
def connect(config):
    return f"Connecting to {config.host}:{config.port}"

# Función B la modifica sin que te des cuenta
def add_debug_settings(config):
    config.host = "localhost"  # ← cambió la config de producción
    config.timeout = 999

# En tu pipeline:
connect(config)           # → "Connecting to db.prod.internal:5432" ✓
add_debug_settings(config)
connect(config)           # → "Connecting to localhost:5432" ← BUG
La misma variable config ahora apunta a localhost en vez de producción. Este tipo de bugs son difíciles de encontrar porque no tiran error — simplemente el dato está mal.
Con inmutabilidad esto no pasa:
@dataclass(frozen=True)
class Config:
    host: str
    port: int
    timeout: int = 30

config = Config("db.prod.internal", 5432)

# Esto tira FrozenInstanceError inmediatamente:
config.host = "localhost"  # ← ERROR, no te deja

# Si necesitás una versión modificada, creás una nueva:
from dataclasses import replace

debug_config = replace(config, host="localhost", timeout=999)

# config sigue intacta:
print(config.host)        # → "db.prod.internal"
print(debug_config.host)  # → "localhost"
Cada versión es un objeto separado. La original nunca se toca. Esto se llama crear en vez de mutar, y es la forma más segura de trabajar con datos que pasan por varias funciones.
En data engineering esto aparece todo el tiempo:
# Configuración del pipeline — no debería cambiar durante la ejecución
@dataclass(frozen=True)
class PipelineConfig:
    source_table: str
    target_table: str
    batch_size: int = 10000
    mode: str = "append"

# Resultado de una validación — es un hecho, no cambia
@dataclass(frozen=True)
class QualityCheck:
    rule_name: str
    passed: bool
    value: float
    threshold: float

# Credenciales — NUNCA deberían mutarse en memoria
@dataclass(frozen=True)
class Credentials:
    host: str
    token: str
    workspace_id: str
¿Cuándo mutar y cuándo no?
- Inmutable (
frozen=True): configuraciones, credenciales, resultados, metadatos, cualquier cosa que viaje entre funciones y no deba cambiar - Mutable (dataclass normal): objetos que acumulan estado durante un proceso, como un logger o un builder que vas armando paso a paso
La regla: si dudás, hacelo inmutable. Es más fácil relajar la restricción después que encontrar un bug por mutación inesperada a las 3 AM.
NamedTuple — cuando querés inmutabilidad + desempaquetado:
from typing import NamedTuple

class ValidationResult(NamedTuple):
    passed: bool
    errors: list[str]
    row_count: int

result = ValidationResult(False, ["nulls in amount"], 1500)

# Se desempaqueta como tupla:
passed, errors, count = result

# Pero accedés por nombre:
if not result.passed:
    print(result.errors)
La diferencia clave con frozen dataclass: las NamedTuples son tuplas de verdad. Las podés desempaquetar, iterar, y ocupan menos memoria. Pero no podés agregarles métodos complejos.
Pydantic BaseModel — cuando necesitás validación:
from pydantic import BaseModel, field_validator

class DataContract(BaseModel):
    name: str
    owner: str
    sla_hours: int
    columns: list[str]

    @field_validator("sla_hours")
    @classmethod
    def sla_must_be_positive(cls, v):
        if v <= 0:
            raise ValueError("SLA debe ser mayor a 0")
        return v

# Valida automáticamente al crear:
contract = DataContract(
    name="transactions",
    owner="backend-team",
    sla_hours=4,
    columns=["id", "amount", "date"]
)

# Esto falla con un error claro:
bad = DataContract(name="x", owner="y", sla_hours=-1, columns=[])
# ValidationError: SLA debe ser mayor a 0

# Parsea desde JSON/dict:
contract = DataContract.model_validate_json('{"name": "tx", ...}')
Pydantic es pesado (es una dependencia externa), pero cuando estás parseando configuraciones YAML, respuestas de APIs o contratos de datos, la validación automática te ahorra horas de debugging.
¿Cuándo usar cada una?
| Situación | Tipo de clase |
|---|---|
| Modelo de datos simple (la mayoría) | @dataclass |
| Configuración que no debe cambiar | @dataclass(frozen=True) |
| Resultado liviano, desempaquetable | NamedTuple |
| Parsing de JSON/YAML con validación | Pydantic BaseModel |
| Lógica de negocio compleja, herencia | Clase tradicional |
| Solo agrupás datos, nada más | dict (en serio, a veces alcanza) |
La regla general: arrancá con @dataclass. Si necesitás inmutabilidad, ponele frozen=True. Si necesitás validación de entrada, usá Pydantic. Si necesitás herencia compleja o control total del ciclo de vida, clase tradicional. Y si es un dato descartable que usás una vez, un dict está bien.
Recursos que recomiendo
- Python for Data Engineers — Real Python es excelente para ir más allá de lo básico
- Automate the Boring Stuff — para perder el miedo a los scripts
- La documentación oficial de Python es sorprendentemente buena. Leela.
2. SQL: el lenguaje que nunca muere
SQL tiene más de 50 años y sigue siendo el lenguaje más usado en datos. No importa si usás Spark, dbt, Databricks o BigQuery — todo termina en SQL.
Lo que tenés que dominar de verdad:
- Window functions:
ROW_NUMBER(),LAG(),LEAD(),RANK(),SUM() OVER(). Esto es lo que separa un analista junior de uno senior. - CTEs: Common Table Expressions. Escribí SQL legible, no queries anidados de 200 líneas.
- JOINs: no solo
INNERyLEFT. EntendéCROSS,ANTI,SEMI. Sabé cuándo un JOIN te multiplica filas. - Aggregations con HAVING y GROUPING SETS: para reportería real.
- Subqueries correlacionadas: para entender por qué son lentas y cuándo evitarlas.
from pyspark.sql import functions as F
from datetime import date, timedelta
import random

random.seed(42)

# Generar datos de ventas
rows = []
customers = list(range(1, 10))
for day_offset in range(30):
    d = date(2026, 1, 1) + timedelta(days=day_offset)
    for cust in random.sample(customers, k=random.randint(2, 5)):
        rows.append((
            cust,
            float(random.randint(10, 500)),
            d,
            random.choice(["COMPLETED", "COMPLETED", "COMPLETED", "PENDING", "FAILED"])
        ))

sales_df = spark.createDataFrame(rows, ["customer_id", "amount", "sale_date", "status"])
sales_df.createOrReplaceTempView("sales")

print(f"Filas generadas: {sales_df.count()}")
sales_df.show(5)%sql
-- Ventas diarias por cliente con ranking y cambio vs día anterior
WITH daily_sales AS (
SELECT
customer_id,
sale_date AS sale_day,
SUM(amount) AS daily_total,
COUNT(*) AS txn_count
FROM sales
WHERE status = 'COMPLETED'
GROUP BY 1, 2
),
ranked AS (
SELECT
*,
ROW_NUMBER() OVER (
PARTITION BY customer_id
ORDER BY daily_total DESC
) AS rn,
LAG(daily_total) OVER (
PARTITION BY customer_id
ORDER BY sale_day
) AS prev_day_total
FROM daily_sales
)
SELECT
customer_id,
sale_day,
daily_total,
prev_day_total,
ROUND(
(daily_total - prev_day_total) / prev_day_total * 100, 2
) AS pct_change
FROM ranked
WHERE rn <= 5
ORDER BY customer_id, rnError que cometí: subestimé las window functions. Cuando las dominás, resolvés en una query lo que antes te llevaba 3 scripts de Python.
3. Spark: pensar en distribuido
Acá es donde la cosa se pone interesante. Spark no es “pandas grande” — es un paradigma distinto. Si no entendés cómo funciona por debajo, vas a escribir código que tarda 10x más de lo que debería.
Lo esencial
- Lazy evaluation: Spark no ejecuta nada hasta que hacés una acción (
collect(),count(),write()). Las transformaciones se acumulan en un plan. - Particiones: tus datos están distribuidos en particiones. Si no entendés esto, vas a hacer
coalesce(1)en un dataset de 500GB y matar el cluster. - Shuffle: la operación más cara. Cada
JOIN,GROUP BY,DISTINCTpuede generar un shuffle. Minimizalos. - Broadcast joins: si una tabla es chica (< 10MB), broadcasteala. La diferencia puede ser de minutos a segundos.
- Catalyst optimizer: Spark optimiza tu query plan. Pero si escribís UDFs en Python, el optimizer no puede ayudarte.
from pyspark.sql import functions as F
from pyspark.sql.window import Window

# Bien: usar funciones nativas de Spark
df = (
    spark.read.table("sales.transactions")
    .filter(F.col("status") == "completed")
    .withColumn(
        "running_total",
        F.sum("amount").over(
            Window.partitionBy("customer_id")
            .orderBy("transaction_date")
            .rowsBetween(Window.unboundedPreceding, Window.currentRow)
        )
    )
)

# Mal: UDF en Python (rompe la optimización, serializa fila por fila)
# @udf(returnType=DoubleType())
# def calc_running_total(amounts):
#     return sum(amounts)
El concepto clave que nadie te explica bien
Spark tiene dos APIs: DataFrame y Spark SQL. Internamente son lo mismo — ambos generan el mismo plan de ejecución. Usá la que te resulte más cómoda, pero entendé que:
# Esto:
df.filter(F.col("amount") > 100).groupBy("customer_id").agg(F.sum("amount"))

# Y esto:
spark.sql("""
    SELECT customer_id, SUM(amount)
    FROM transactions
    WHERE amount > 100
    GROUP BY customer_id
""")

# Generan EXACTAMENTE el mismo plan de ejecución.
Error que cometí: escribí UDFs en Python para todo al principio. Cuando entendí el Catalyst optimizer y cambié a funciones nativas, los jobs pasaron de 45 minutos a 3 minutos. Sin cambiar el cluster.
Funciones wrapper vs UDFs — la confusión más común
Esto genera mucha confusión. Si tenés una función Python que recibe un DataFrame y adentro hace .withColumn(), ¿eso es un UDF?
No. Son cosas completamente distintas.
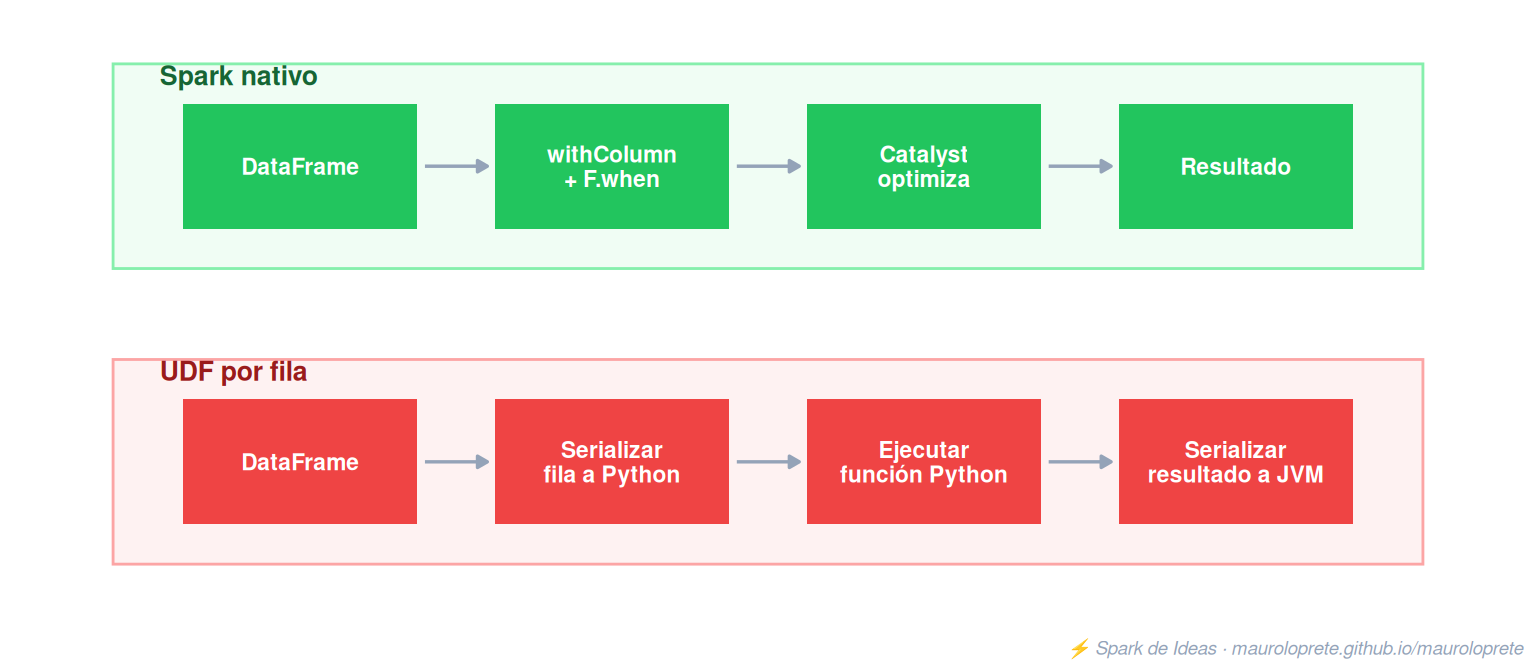
Una función wrapper usa la API nativa de Spark. Spark ve las operaciones, las entiende y las optimiza:
# Esto NO es un UDF — usa la API de Spark por dentro
def add_revenue_flag(df, threshold=1000):
    return df.withColumn(
        "high_revenue",
        F.when(F.col("amount") > threshold, True).otherwise(False)
    )

# Spark ve F.when y F.col → son expresiones nativas
# El Catalyst optimizer las puede combinar, reordenar y optimizar
result = add_revenue_flag(sales_df)
Acá Spark sabe exactamente qué estás haciendo. Tu función es solo una forma de organizar el código — por debajo sigue siendo todo Spark nativo.
Un UDF es cuando le pedís a Spark que ejecute código Python puro fila por fila, sacando los datos del motor optimizado y pasándolos por el intérprete de Python:
# Esto SÍ es un UDF — Python puro, fila por fila
@udf(returnType=BooleanType())
def high_revenue_udf(amount):
    return amount > 1000

result = df.withColumn("high_revenue", high_revenue_udf(F.col("amount")))
¿Qué pasa internamente con el UDF?
- Spark serializa cada fila de datos (JVM → Python)
- El intérprete de Python ejecuta tu función
- El resultado se serializa de vuelta (Python → JVM)
- Repetí esto para cada fila del DataFrame
Esa serialización ida y vuelta se llama serde overhead, y en un dataset de millones de filas es la diferencia entre 3 minutos y 45 minutos.
¿Cuándo sí necesitás un UDF? Casi nunca. Pero hay casos legítimos:
- Lógica que no tiene equivalente en las funciones de Spark (regex custom muy compleja, cálculos matemáticos específicos de tu dominio)
- Llamar a una librería Python que no existe en Spark (un modelo de ML custom, una librería de geocoding)
Y si no te queda otra, usá Pandas UDFs en vez de UDFs comunes — procesan por batch en vez de fila por fila, y son mucho más rápidos:
from pyspark.sql.functions import pandas_udf
import pandas as pd

@pandas_udf("boolean")
def high_revenue_pandas(amount: pd.Series) -> pd.Series:
    return amount > 1000

# Procesa por batch (vectorizado), no fila por fila
result = df.withColumn("high_revenue", high_revenue_pandas(F.col("amount")))
4. dbt: SQL con ingeniería de software
dbt (data build tool) cambió cómo se hacen las transformaciones de datos. La idea es simple: escribí tus transformaciones en SQL, pero con las prácticas de ingeniería de software que siempre faltaron en datos.
Por qué importa
- Modularidad: cada modelo es un
SELECT. Se referencian entre sí con{ ref('model_name') }. - Testing: tests de schema (
not_null,unique,relationships) y tests custom. - Documentación: se genera automáticamente desde el YAML.
- Linaje: sabés exactamente qué modelo depende de qué.
- Versionamiento: todo es código, todo va a Git.
-- models/staging/stg_transactions.sql
WITH source AS (
    SELECT * FROM {{ source('raw', 'transactions') }}
),

cleaned AS (
    SELECT
        transaction_id,
        customer_id,
        CAST(amount AS DECIMAL(18,2)) AS amount,
        CAST(transaction_date AS DATE) AS transaction_date,
        UPPER(TRIM(status)) AS status
    FROM source
    WHERE transaction_id IS NOT NULL
)

SELECT * FROM cleaned# models/staging/stg_transactions.yml
version: 2
models:
- name: stg_transactions
description: "Transacciones limpias del core bancario"
columns:
- name: transaction_id
tests:
- not_null
- unique
- name: amount
tests:
- not_null
- dbt_utils.accepted_range:
min_value: 0
max_value: 1000000
- name: status
tests:
- accepted_values:
values: ['COMPLETED', 'PENDING', 'FAILED', 'REVERSED']dbt en Databricks
dbt funciona nativamente con Databricks via dbt-databricks. Los modelos se materializan como tablas Delta en Unity Catalog.
# profiles.yml
my_project:
  target: dev
  outputs:
    dev:
      type: databricks
      catalog: dev
      schema: analytics
      host: "{{ env_var('DBX_HOST') }}"
      http_path: "{{ env_var('DBX_HTTP_PATH') }}"
      token: "{{ env_var('DBX_TOKEN') }}"
Error que cometí: intenté hacer en Python lo que dbt resuelve mucho mejor en SQL. Si tu transformación es SQL puro (y la mayoría lo son), usá dbt. Si necesitás lógica compleja con APIs, ML o archivos raros, ahí sí PySpark.
Cuándo dbt y cuándo PySpark
| Caso | Herramienta |
|---|---|
| Transformaciones SQL (limpieza, joins, agregaciones) | dbt |
| Lógica compleja con APIs externas | PySpark |
| Machine Learning pipelines | PySpark + MLflow |
| Procesamiento de archivos no estructurados (JSON, XML, imágenes) | PySpark |
| Modelos dimensionales (Kimball) | dbt |
| Streaming / near-real-time | PySpark Structured Streaming |
5. Databricks: la plataforma que lo une todo
Databricks no es solo “Spark en la nube”. Es una plataforma de datos completa: compute, storage, gobernanza, ML, SQL Analytics, y orquestación.
Lo que priorizaría aprender
Unity Catalog: el modelo de gobernanza de 3 niveles (
catalog.schema.table). Permisos, linaje, y auditoría. Sin esto, tu lakehouse es un pantano.Lakeflow Declarative Pipelines (ex-DLT): pipelines declarativos con expectations para calidad. Es la forma más simple de armar un pipeline Bronze → Silver → Gold.
Databricks Asset Bundles: infraestructura como código. Jobs, pipelines, permisos — todo en YAML, todo en Git, todo desplegable con CI/CD.
Workflows: orquestación nativa. Triggers, dependencias entre tasks, retry policies. No necesitás Airflow para el 90% de los casos.
SQL Warehouses: para analistas y dashboards. Serverless, escalable, y con cache inteligente.
-- Lo que tenés que saber hacer en Databricks desde el día 1
-- Crear un catalog y schema
CREATE CATALOG IF NOT EXISTS analytics;
CREATE SCHEMA IF NOT EXISTS analytics.sales;

-- Crear una tabla con Liquid Clustering
CREATE TABLE analytics.sales.transactions (
    transaction_id BIGINT,
    customer_id BIGINT,
    amount DECIMAL(18,2),
    transaction_date DATE
)
USING DELTA
CLUSTER BY (transaction_date, customer_id);

-- Grants (gobernanza básica)
GRANT USE CATALOG ON CATALOG analytics TO `analysts`;
GRANT USE SCHEMA ON SCHEMA analytics.sales TO `analysts`;
GRANT SELECT ON TABLE analytics.sales.transactions TO `analysts`;
Error que cometí: arranqué usando Databricks como “Jupyter en la nube” — notebooks sueltos, sin versionamiento, sin tests. Cuando descubrí DABs y Unity Catalog, entendí que estaba usando el 10% de la plataforma.
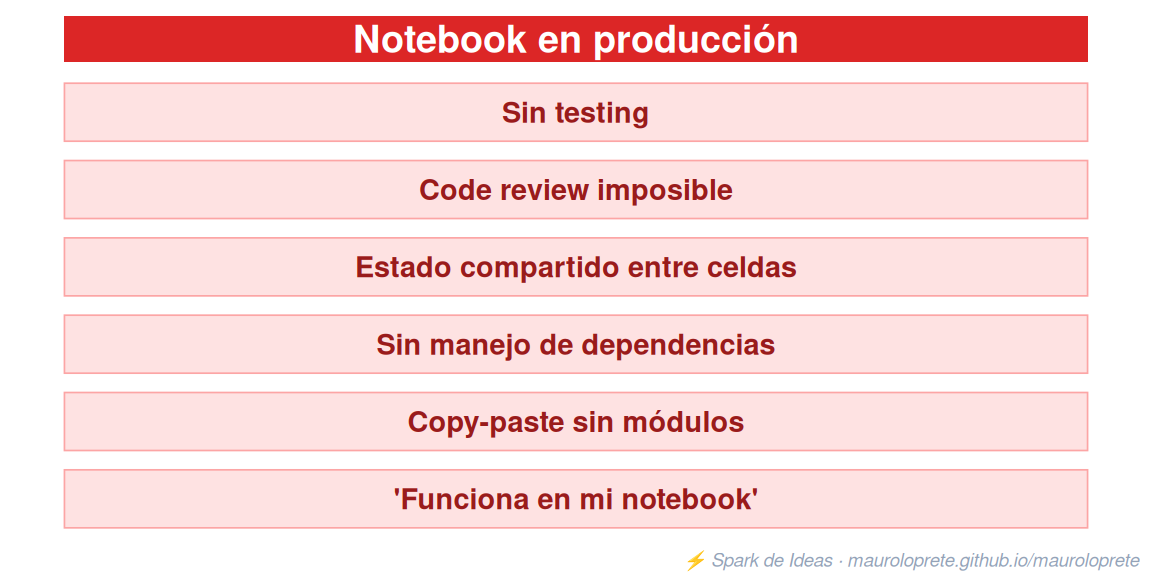
Los notebooks NO son para producción
Esto merece su propia sección porque es el error más común que veo — y el que más cuesta corregir después.
Los notebooks son una herramienta exploratoria. Sirven para:
- Explorar un dataset nuevo
- Probar una transformación antes de productivizarla
- Hacer análisis ad-hoc
- Prototipar una idea rápida
Los notebooks NO sirven para:
- Pipelines productivos que corren todos los días
- Código que necesita testing
- Lógica que otros van a mantener
- Cualquier cosa que necesite code review en un PR
El problema real
Cómo se hace bien
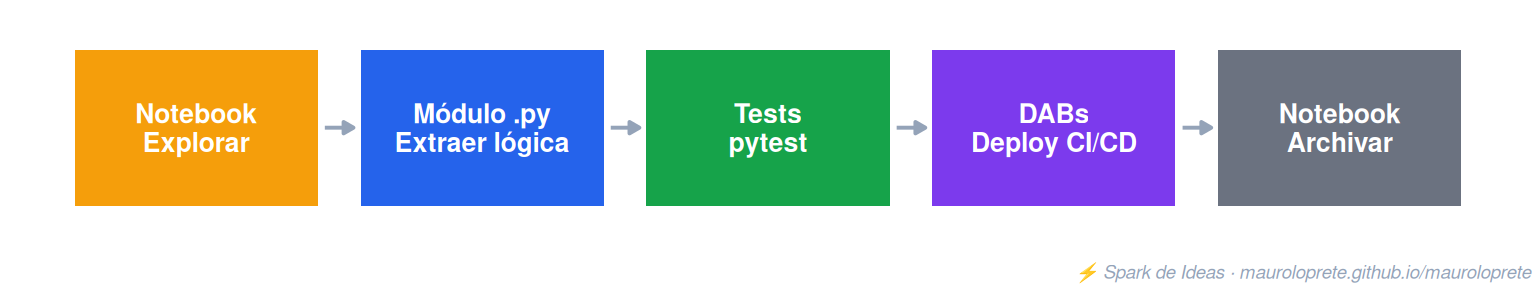
El notebook lo usás para explorar y prototipar. Cuando la lógica funciona, la movés a un módulo Python o a un modelo dbt:
# src/transformations/clean_sales.py  ← ESTO va a producción
def clean_transactions(df):
    """Limpia y valida transacciones del core."""
    return (
        df
        .filter(F.col("transaction_id").isNotNull())
        .withColumn("amount", F.col("amount").cast("decimal(18,2)"))
        .withColumn("status", F.upper(F.trim(F.col("status"))))
        .filter(F.col("amount") > 0)
    )

# tests/test_clean_sales.py  ← ESTO garantiza que no se rompa
def test_clean_removes_nulls(spark):
    input_df = spark.createDataFrame([
        (1, 100.0, "completed"),
        (None, 200.0, "pending"),
    ], ["transaction_id", "amount", "status"])

    result = clean_transactions(input_df)
assert result.count() == 1# databricks.yml ← ESTO lo deploya
resources:
jobs:
clean_sales:
name: "[${var.env}] Clean Sales"
tasks:
- task_key: run
python_wheel_task:
package_name: my_project
entry_point: clean_salesLa regla es simple: si algo corre más de una vez, no debería estar en un notebook. El notebook es el borrador, no el documento final.
Error que cometí: tuve notebooks de 800 líneas corriendo en producción durante meses. Cuando algo fallaba a las 3 AM, debuggearlo era una pesadilla. El día que migré todo a módulos Python + DABs + tests, dejé de recibir alertas los fines de semana.
El roadmap: en qué orden
Si hoy tuviera que arrancar de cero, haría esto:
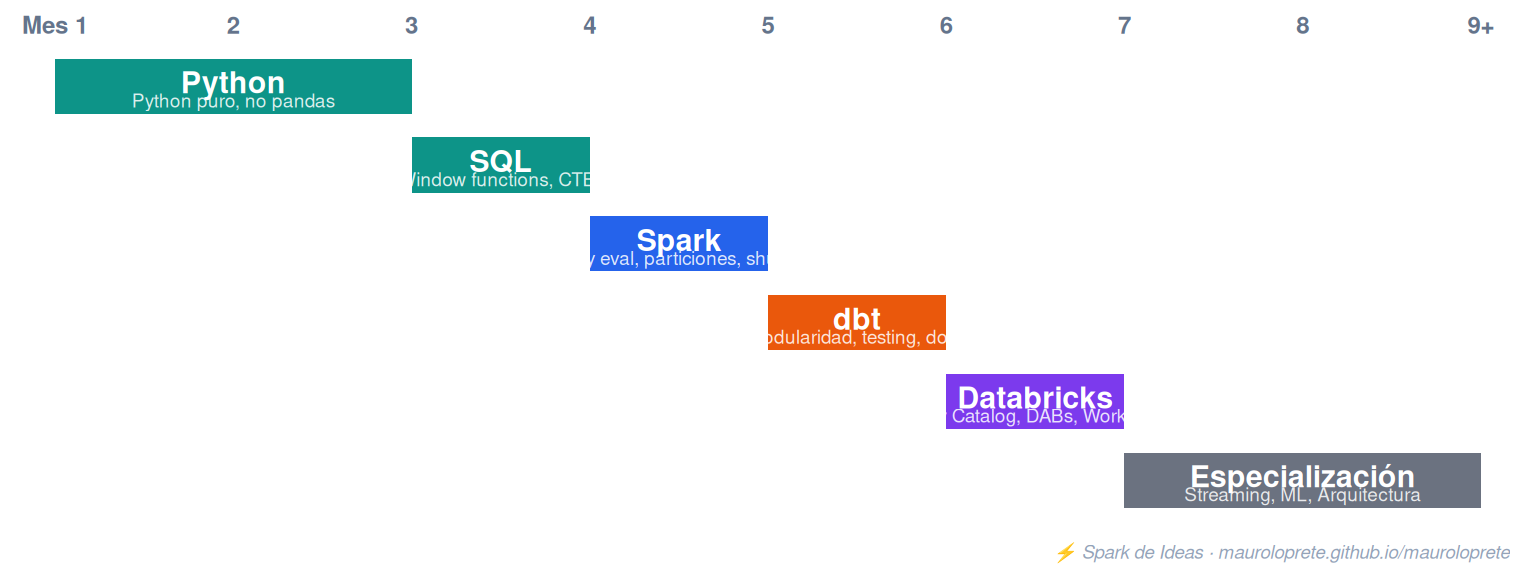
Y lo más importante: construí algo. No hagas solo cursos. Agarrá un dataset público, armá un pipeline de punta a punta, deployalo, rompelo, arreglalo. Eso vale más que 10 cursos.
Lo que NO priorizaría
- Airflow: Databricks Workflows cubre el 90% de los casos. Airflow es una herramienta increíble pero tiene una curva de aprendizaje alta y un overhead operacional grande. Aprendelo después, si lo necesitás.
- Kafka: a menos que tu empresa haga streaming real (no micro-batch), no lo necesitás al principio. Auto Loader + Structured Streaming resuelve la mayoría de los casos.
- Kubernetes: como DE, no necesitás ser experto en K8s. Sabé lo básico, pero no te metas en ese rabbit hole.
- Todos los clouds a la vez: elegí uno (AWS, Azure, GCP) y dominalo. Los conceptos se transfieren, pero intentar aprender los 3 a la vez es contraproducente.
Links
- Notebooks del episodio — Python, SQL y Spark para ejecutar en Databricks Free Edition
- Fundamentals of Data Engineering (Reis & Housley) — el mejor libro para arrancar
- dbt Learn — curso gratuito oficial de dbt
- Databricks Academy — cursos oficiales, algunos gratuitos
La semana que viene en Databricks Tips: Delta Lake — 7 cosas que ojalá me hubieran dicho antes.