Si empezara de cero
Qué priorizaría aprender en Data Engineering
Mauro Loprete
2026-02-22
Spark de Ideas
La chispa de la ingeniería de datos en español
Mauro Loprete
Data Engineer
Yendo por el MVP
Si arrancara de cero
¿qué priorizaría aprender en Data Engineering?
Para un perfil de ingeniero de datos
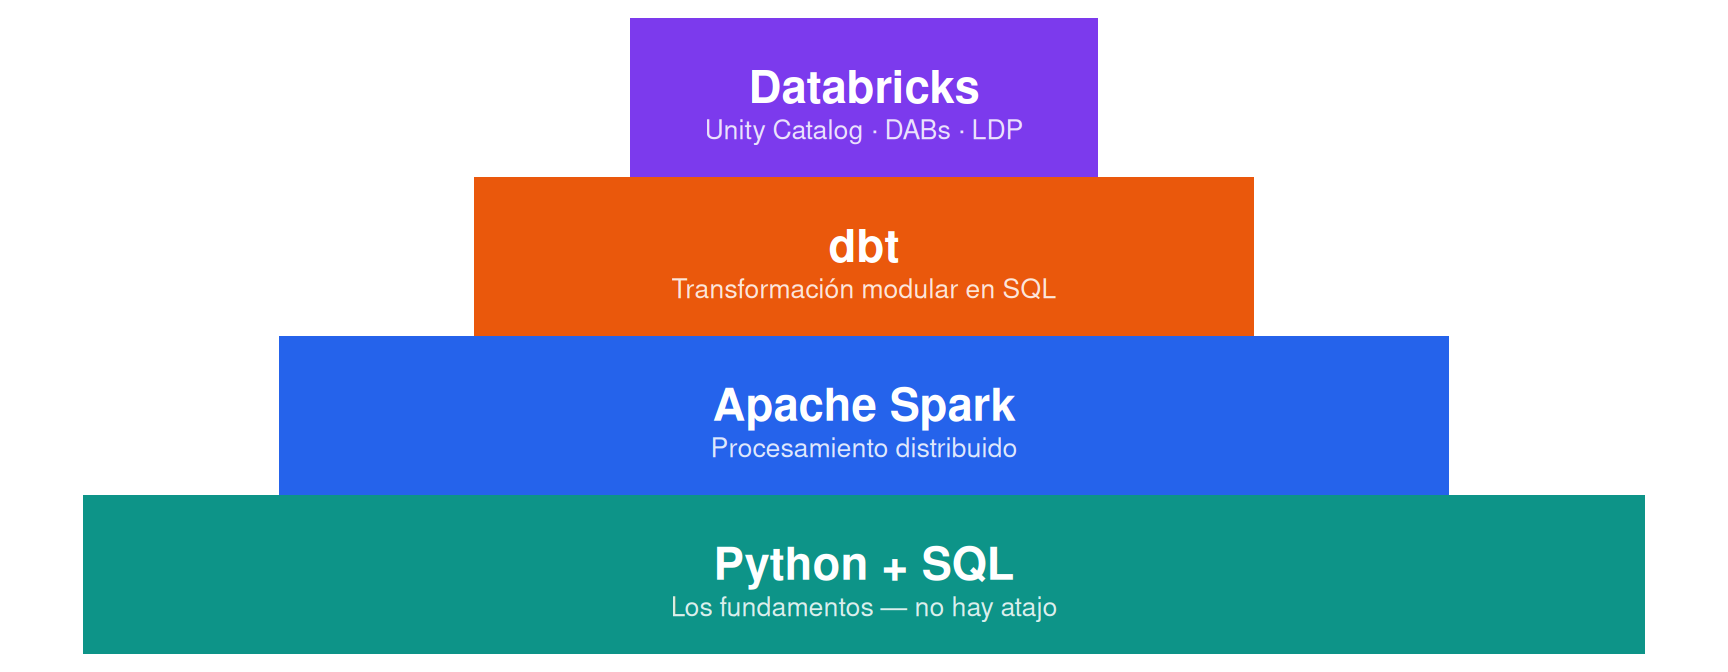
La pirámide: de abajo hacia arriba
1
Python: la base de todo
No estoy hablando de print("Hola mundo")
Python — lo que realmente necesitás
- Estructuras de datos: listas, diccionarios, sets, tuplas
- Funciones y decoradores: composición de funciones
- Manejo de archivos: JSON, CSV, YAML, Parquet
- Entornos virtuales:
venv,pip,pyproject.toml - Testing básico:
pytest
El 80% de lo que hacés en data es manipular estructuras.
Python — dataclasses
Python — dataclasses
from dataclasses import dataclass
from typing import List, Optional

@dataclass
class DataProduct:
    name: str
    owner: str
    tables: List[str]
    sla_hours: Optional[int] = None
def is_critical(self) -> bool:
return self.sla_hours is not None and self.sla_hours <= 4
# Leer config, parsear, validar — el 60% del laburo real
with open("products.json") as f:
products = [DataProduct(**p) for p in json.load(f)]
critical = [p for p in products if p.is_critical()]Python — inmutabilidad
El problema de los objetos mutables:
Python — inmutabilidad
El problema de los objetos mutables:
@dataclass
class Config:
    host: str
    port: int
    timeout: int = 30

config = Config("db.prod.internal", 5432)
# Función B modifica la config sin que te des cuenta
def add_debug_settings(config):
config.host = "localhost" # ← cambió producción
connect(config) # → "db.prod.internal:5432" ✓
add_debug_settings(config)
connect(config) # → "localhost:5432" ← BUGPython — la solución: frozen
@dataclass(frozen=True)
class Config:
    host: str
    port: int
    timeout: int = 30

config = Config("db.prod.internal", 5432)

config.host = "localhost"  # ← FrozenInstanceError

# Si necesitás una versión modificada, creás una nueva:
from dataclasses import replace
debug_config = replace(config, host="localhost", timeout=999)

print(config.host)        # → "db.prod.internal"
print(debug_config.host)  # → "localhost"
Crear en vez de mutar — la forma más segura de trabajar con datos.
Python — Pydantic para validación
from pydantic import BaseModel, field_validator

class DataContract(BaseModel):
    name: str
    owner: str
    sla_hours: int
    columns: list[str]

    @field_validator("sla_hours")
    @classmethod
    def sla_must_be_positive(cls, v):
        if v <= 0:
            raise ValueError("SLA debe ser mayor a 0")
        return v

# Valida automáticamente al crear:
contract = DataContract(
    name="transactions", owner="backend-team",
    sla_hours=4, columns=["id", "amount", "date"]
)Python — ¿cuándo usar cada tipo?
| Situación | Tipo |
|---|---|
| Modelo de datos simple (mayoría) | @dataclass |
| Config que no debe cambiar | @dataclass(frozen=True) |
| Resultado liviano, desempaquetable | NamedTuple |
| Parsing JSON/YAML con validación | Pydantic BaseModel |
| Lógica de negocio compleja | Clase tradicional |
| Dato descartable, se usa una vez | dict |
Arrancá con
@dataclass. Si necesitás inmutabilidad →frozen=True. Si necesitás validación → Pydantic.
2
SQL: el lenguaje que nunca muere
+50 años y sigue siendo el más usado en datos
SQL — lo que tenés que dominar
- Window functions:
ROW_NUMBER(),LAG(),LEAD(),RANK() - CTEs: queries legibles, no anidados de 200 líneas
- JOINs:
CROSS,ANTI,SEMI— no soloINNERyLEFT - Aggregations:
HAVING,GROUPING SETS - Subqueries correlacionadas: para saber cuándo evitarlas
Cuando dominás window functions, resolvés en una query lo que antes te llevaba 3 scripts de Python.
SQL — ejemplo real
WITH daily_sales AS (
    SELECT
        customer_id,
        sale_date AS sale_day,
        SUM(amount) AS daily_total,
        COUNT(*) AS txn_count
    FROM sales
    WHERE status = 'COMPLETED'
    GROUP BY 1, 2
),
ranked AS (
    SELECT *,
        ROW_NUMBER() OVER (
            PARTITION BY customer_id
            ORDER BY daily_total DESC
        ) AS rn,
        LAG(daily_total) OVER (
            PARTITION BY customer_id
            ORDER BY sale_day
        ) AS prev_day_total
    FROM daily_sales
)
SELECT customer_id, sale_day, daily_total,
    prev_day_total,
    ROUND((daily_total - prev_day_total)
          / prev_day_total * 100, 2) AS pct_change
FROM ranked WHERE rn <= 5
ORDER BY customer_id, rn3
Spark: pensar en distribuido
No es “pandas grande” — es un paradigma distinto
Spark — lo esencial
- Lazy evaluation: nada se ejecuta hasta
collect(),count(),write() - Particiones: datos distribuidos —
coalesce(1)en 500GB mata el cluster - Shuffle: la operación más cara — cada
JOIN,GROUP BYpuede generar uno - Broadcast joins: tabla chica (< 10MB) → broadcasteala
- Catalyst optimizer: optimiza tu plan… si usás funciones nativas
Spark — funciones nativas vs UDF
from pyspark.sql import functions as F
from pyspark.sql.window import Window
# Bien: funciones nativas de Spark
df = (
    spark.read.table("sales.transactions")
    .filter(F.col("status") == "completed")
    .withColumn(
        "running_total",
        F.sum("amount").over(
            Window.partitionBy("customer_id")
            .orderBy("transaction_date")
            .rowsBetween(Window.unboundedPreceding,
                         Window.currentRow)
        )
    )
)Spark — la diferencia clave
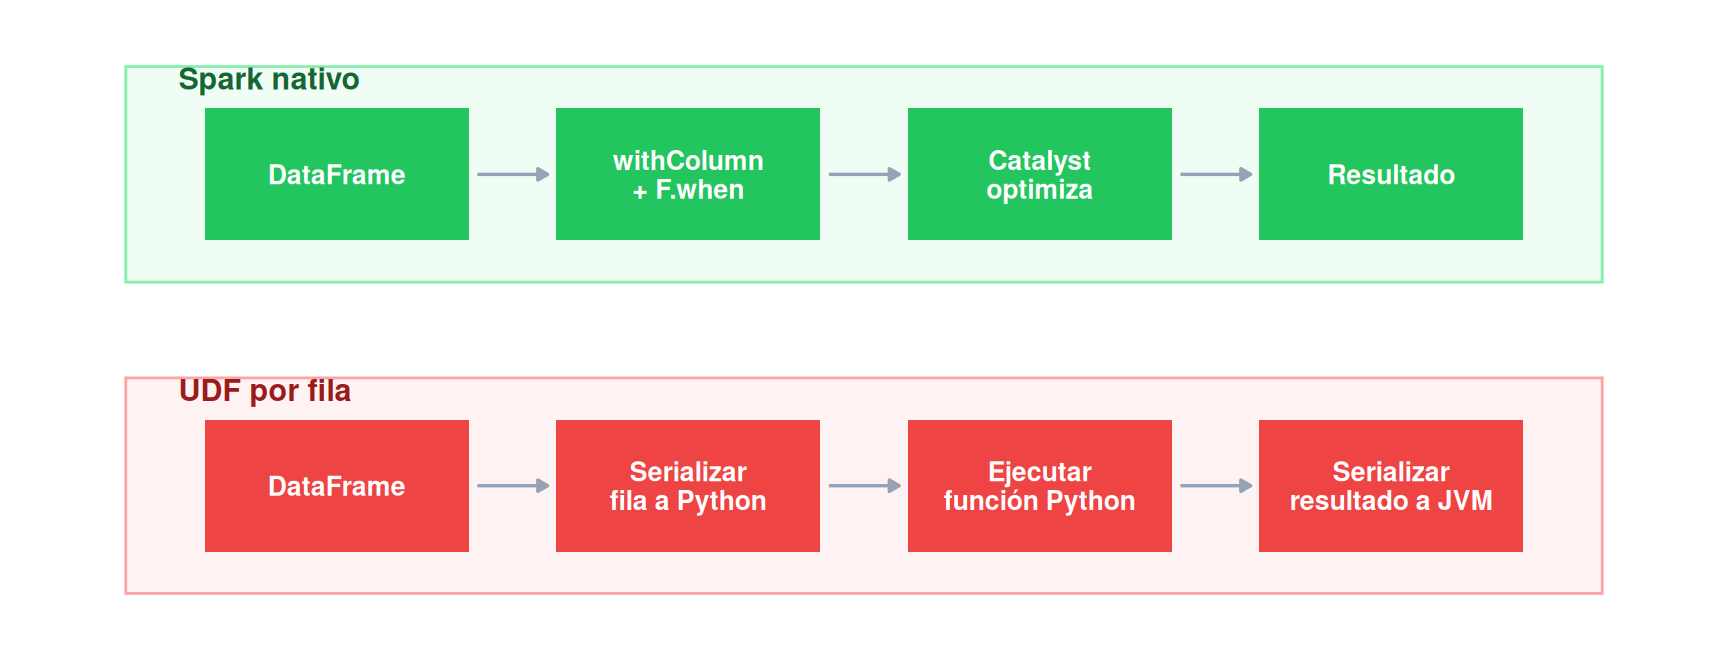
Serde overhead: serialización JVM ↔︎ Python fila por fila = lento.
Spark — wrapper functions ≠ UDFs
# Wrapper: usa API nativa — Spark la entiende y optimiza
def add_revenue_flag(df, threshold=1000):
    return df.withColumn(
        "high_revenue",
        F.when(F.col("amount") > threshold, True)
         .otherwise(False)
    )

# UDF: Python puro — fila por fila, sin optimización
@udf(returnType=BooleanType())
def high_revenue_udf(amount):
    return amount > 1000
Si no te queda otra, usá Pandas UDFs — procesan por batch, no fila por fila.
4
dbt: SQL con ingeniería de software
Modularidad, testing, documentación, linaje
dbt — por qué importa
- Modularidad: cada modelo es un
SELECT, se referencian con{ ref() } - Testing:
not_null,unique,relationships, tests custom - Documentación: se genera automáticamente desde YAML
- Linaje: sabés qué modelo depende de qué
- Versionamiento: todo es código, todo va a Git
dbt — modelo + tests
-- models/staging/stg_transactions.sql
WITH source AS (
    SELECT * FROM {{ source('raw', 'transactions') }}
),
cleaned AS (
    SELECT
        transaction_id,
        customer_id,
        CAST(amount AS DECIMAL(18,2)) AS amount,
        CAST(transaction_date AS DATE) AS transaction_date,
        UPPER(TRIM(status)) AS status
    FROM source
    WHERE transaction_id IS NOT NULL
)
SELECT * FROM cleaned
dbt — modelo + tests
# models/staging/stg_transactions.yml
version: 2
models:
  - name: stg_transactions
    description: "Transacciones limpias del core bancario"
    columns:
      - name: transaction_id
        tests: [not_null, unique]
      - name: amount
        tests:
          - not_null
          - dbt_utils.accepted_range:
              min_value: 0
              max_value: 1000000
      - name: status
        tests:
          - accepted_values:
values: ['COMPLETED', 'PENDING', 'FAILED']dbt — ¿cuándo dbt y cuándo PySpark?
| Caso | Herramienta |
|---|---|
| Transformaciones SQL (limpieza, joins, agg) | dbt |
| Lógica con APIs externas | PySpark |
| ML pipelines | PySpark + MLflow |
| Archivos no estructurados (JSON, XML) | PySpark |
| Modelos dimensionales (Kimball) | dbt |
| Streaming / near-real-time | Structured Streaming |
Si tu transformación es SQL puro, usá dbt. Si necesitás lógica compleja, PySpark.
5
Databricks: la plataforma que lo une todo
No es solo “Spark en la nube”
Databricks — lo que priorizaría
- Unity Catalog — gobernanza de 3 niveles:
catalog.schema.table - Lakeflow Declarative Pipelines — Bronze → Silver → Gold con expectations
- Databricks Asset Bundles — infra como código, todo en YAML + Git
- Workflows — orquestación nativa con triggers y retry
- SQL Warehouses — serverless para analistas y dashboards
Databricks — desde el día 1
-- Crear catalog y schema
CREATE CATALOG IF NOT EXISTS analytics;
CREATE SCHEMA IF NOT EXISTS analytics.sales;

-- Tabla con Liquid Clustering
CREATE TABLE analytics.sales.transactions (
    transaction_id BIGINT,
    customer_id BIGINT,
    amount DECIMAL(18,2),
    transaction_date DATE
)
USING DELTA
CLUSTER BY (transaction_date, customer_id);

-- Gobernanza básica
GRANT USE CATALOG ON CATALOG analytics TO `analysts`;
GRANT USE SCHEMA ON SCHEMA analytics.sales TO `analysts`;
GRANT SELECT ON TABLE analytics.sales.transactions TO `analysts`;BONUS
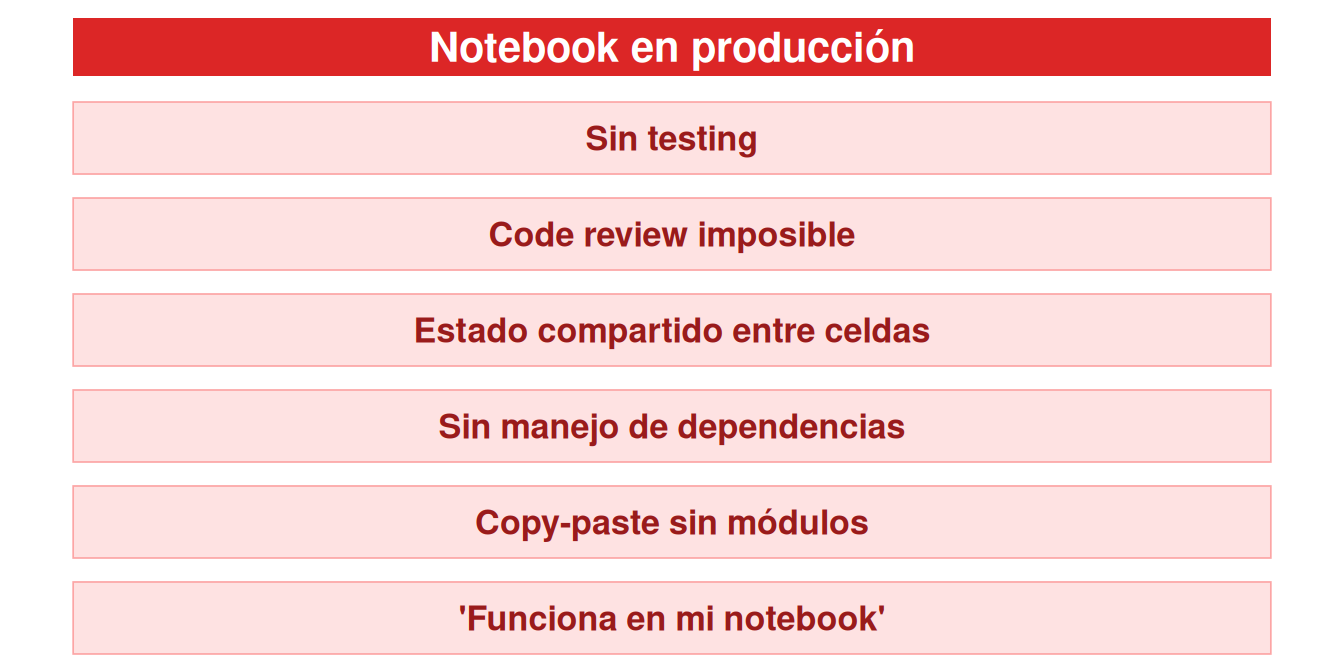
Los notebooks NO son para producción
El error más común — y el que más cuesta corregir
Notebooks — el problema real
Notebooks — cómo se hace bien
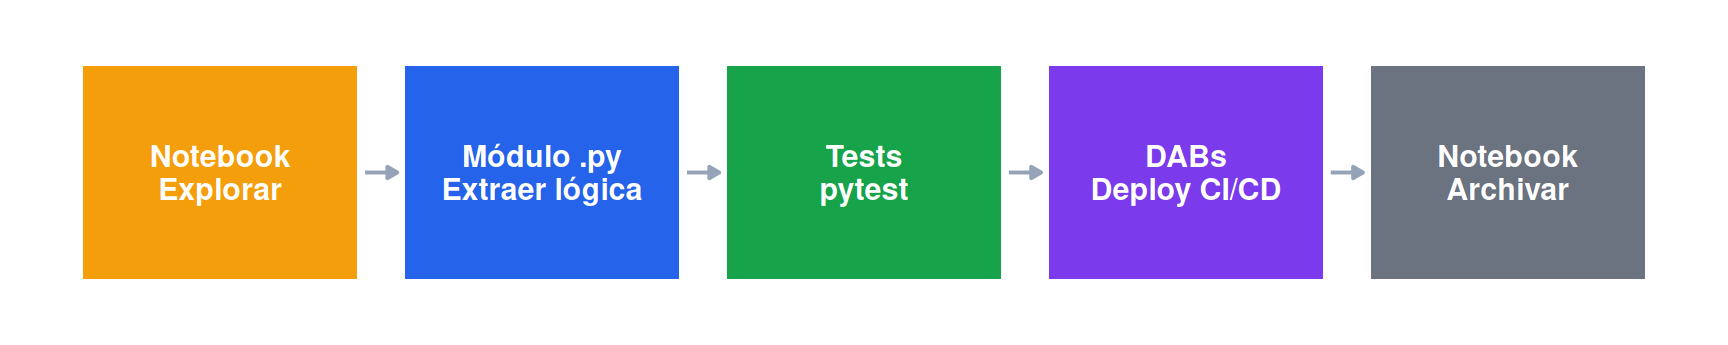
La regla: si algo corre más de una vez, no debería estar en un notebook.
Notebooks — el código que sí va a producción
# src/transformations/clean_sales.py
def clean_transactions(df):
    return (
        df
        .filter(F.col("transaction_id").isNotNull())
        .withColumn("amount",
            F.col("amount").cast("decimal(18,2)"))
        .withColumn("status",
            F.upper(F.trim(F.col("status"))))
        .filter(F.col("amount") > 0)
    )

# tests/test_clean_sales.py
def test_clean_removes_nulls(spark):
    input_df = spark.createDataFrame([
        (1, 100.0, "completed"),
        (None, 200.0, "pending"),
    ], ["transaction_id", "amount", "status"])
    result = clean_transactions(input_df)
assert result.count() == 1El roadmap: en qué orden
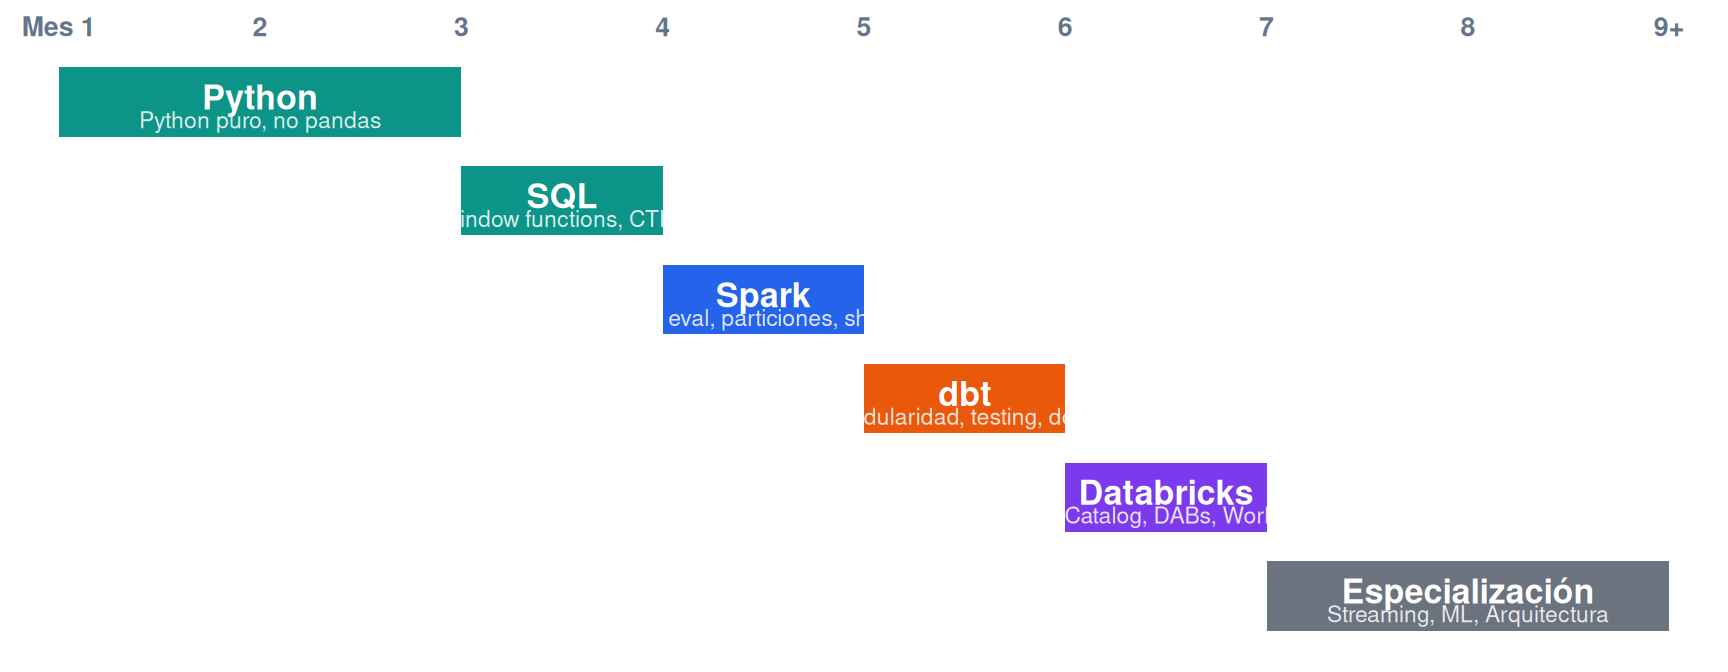
Lo que NO priorizaría
- Airflow — Databricks Workflows cubre el 90% de los casos
- Kafka — Auto Loader + Structured Streaming resuelve la mayoría
- Kubernetes — sabé lo básico, no te metas en ese rabbit hole
- Todos los clouds a la vez — elegí uno y dominalo
Los conceptos se transfieren. No necesitás aprenderlos todos al mismo tiempo.
Lo más importante
Construí algo.
Agarrá un dataset público, armá un pipeline de punta a punta, deployalo, rompelo, arreglalo.
Eso vale más que 10 cursos.
Links y recursos
- Episodio del podcast — la charla completa
- Notebooks del episodio — ejecutalos en Databricks Free Edition
- Fundamentals of Data Engineering — el mejor libro para arrancar
- dbt Learn — curso gratuito oficial
- Databricks Academy — cursos oficiales
Material disponible
A partir de ahora, las slides, notebooks y recursos de cada episodio van a estar en mi página web y en GitHub.
spark-de-ideas-labs — notebooks para ejecutar en Databricks Free Edition
Blog con contenido expandido + slides para revisar a tu ritmo.

Spark de Ideas — Mauro Loprete