Genie ZeroOps: Databricks quiere que tus pipelines se arreglen solos
Data Engineering
Databricks Tips
MLOps
Detect, Assess, Remediate, Verify — cómo funciona el agente de Databricks que monitorea, diagnostica y propone fixes para tus pipelines en producción.
Tenés 47 pipelines en producción. Uno de ellos dejó de escribir rows hace 3 días, pero como no tira excepción nadie se enteró — hasta que un dashboard de revenue muestra cero y el CFO manda un mensaje al canal de Slack. Arrancás a rastrear: la tabla de salida está vacía, el pipeline corrió OK, los logs no dicen nada. Después de dos horas descubrís que alguien cambió un schema tres tablas upstream y tu SELECT * trajo columnas en otro orden. Lo arreglás, lo testeás a mano, lo pusheás. Y sabés que mañana puede pasar de nuevo con cualquiera de los otros 46.
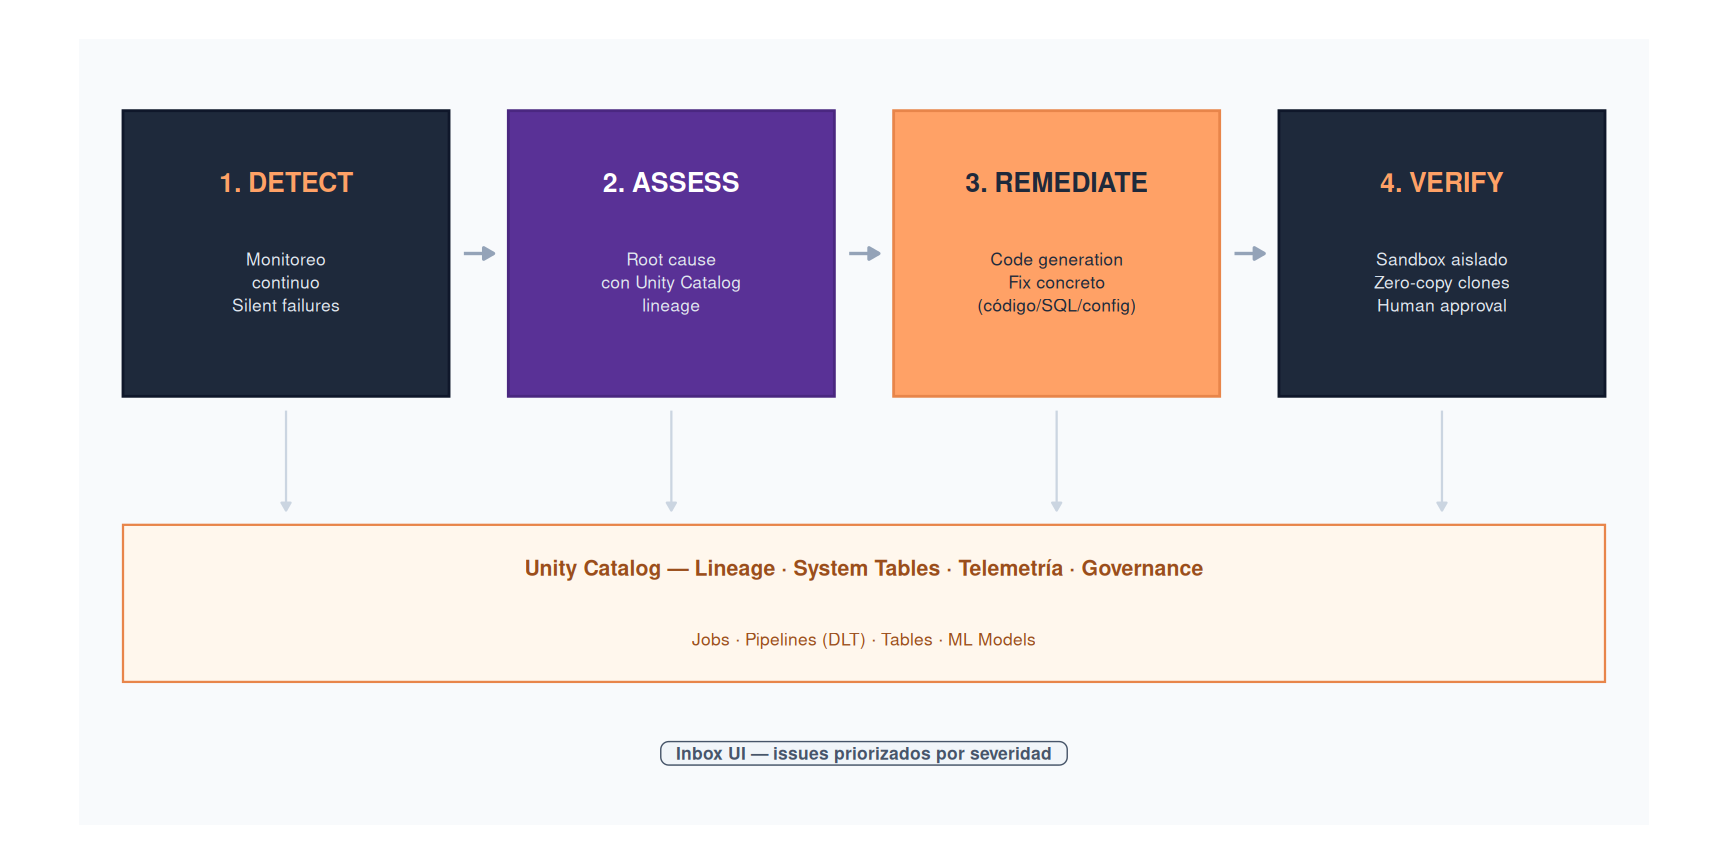
En el Data + AI Summit 2026, Databricks presentó Genie ZeroOps: un agente de AI que corre en background, monitorea tus workloads en producción, diagnostica la causa raíz usando el lineage de Unity Catalog, genera el fix, lo testea en un sandbox aislado y te lo presenta para que lo apruebes.
¿Es el fin de las guardias de datos? Veamos.
NotaTL;DR
- Genie ZeroOps es un agente de AI en background que monitorea jobs, pipelines, tablas y modelos ML.
- Funciona en 4 pasos: Detect → Assess (root cause con lineage) → Remediate (genera el fix) → Verify (sandbox aislado con zero-copy clones).
- No aplica cambios sin aprobación humana — el agente propone, vos decidís.
- Forma parte de Genie One (familia) y Lakeflow (plataforma de data engineering).
- Está en Private Preview. Soporta Jobs, Pipelines DLT, Tables, ML models. Roadmap: Apps, Lakebase.
- No lo pudimos probar todavía — todo lo que cubrimos viene de docs oficiales y sesiones de DAIS 2026.
El problema: construir es más rápido que mantener
Con herramientas de AI coding, crear pipelines es cada vez más rápido. Un engineer que antes tardaba una semana en armar un pipeline de ingesta ahora lo hace en un día con Genie Code. Pero el mantenimiento no escala igual: cada pipeline nuevo que ponés en producción es un pipeline más que puede romperse, degradarse o quedar silenciosamente desactualizado.
El resultado: la mayoría de los equipos de datos pasan más tiempo apagando incendios que construyendo cosas nuevas.
| Build | Maintain | |
|---|---|---|
| Tendencia | Cada vez más rápido (AI coding, IaC, declarativo) | Crece linealmente con la cantidad de assets |
| Quién lo hace | Engineers, con ayuda de AI | Los mismos engineers, sin ayuda |
| Impacto | Más assets en producción | Más guardias, más incidentes, más fatiga |
Es como construir casas cada vez más rápido sin contratar más plomeros. En algún momento, todo se empieza a romper.
Qué es ZeroOps (el concepto)
ZeroOps no es un producto — es una filosofía: cero intervención manual en el steady state de tus pipelines de datos. No significa que nadie opera. Significa que el sistema se opera solo: vos diseñás las reglas, la plataforma las ejecuta.
| Concepto | Automatiza… | Ejemplo |
|---|---|---|
| DevOps | El deploy | CI/CD, IaC, containers |
| DataOps | El ciclo de datos | Testing, quality gates, observabilidad |
| ZeroOps | La operación | Detect → diagnose → fix → verify, sin humanos |
En posts anteriores cubrimos las piezas de DataOps: DABs para IaC, SQL Warehouses serverless, Lakeflow DLT para pipelines declarativos, Jobs con triggers event-driven, y DataOps como práctica. ZeroOps es la capa que falta: la que cierra el loop cuando algo se rompe.
El test ácido: ¿podés irte de vacaciones 2 semanas sin que te llamen por un pipeline? Si no, no tenés ZeroOps.
Dónde encaja ZeroOps en Databricks
Antes de entrar en el producto, ubicamos las piezas:
Genie One es la familia de agentes de AI de Databricks:
| Agente | Función | Analogía |
|---|---|---|
| Genie Code | Desarrollo — te ayuda a escribir pipelines, SQL, notebooks | Tu copilot |
| Genie Spaces | Análisis — responde preguntas de negocio sobre tus datos | Tu analista |
| Genie ZeroOps | Operaciones — monitorea y arregla pipelines en producción | Tu SRE automático |
Lakeflow es la plataforma unificada de data engineering:
- Connect: ingesta con 100+ connectors nativos
- Pipelines: transformaciones declarativas (ex DLT)
- Designer: construcción visual no-code
- ZeroOps: operaciones automáticas
Genie Code te ayuda a construir. Genie ZeroOps opera lo que construiste. Son complementarios.
Cómo funciona Genie ZeroOps
El agente opera en 4 pasos. Cada paso usa un componente nativo de la plataforma — no es un tool externo que se conecta por API.
Paso 1: Detect — monitoreo continuo
El agente corre en background y monitorea jobs, pipelines DLT, tablas y modelos ML. Pero lo interesante no es que detecta errores — eso ya lo hace cualquier alerta. Lo interesante es que detecta silent failures: problemas que no tiran excepción pero que degradan tus datos.
Qué detecta:
| Tipo | Ejemplo |
|---|---|
| Error explícito | Job falló con SchemaEvolutionException |
| Silent failure | Pipeline completó OK pero la tabla tiene 0 rows |
| Data quality | Expectation de DLT empezó a fallar en el 15% de los rows |
| Schema drift | Un campo cambió de INT a STRING tres tablas upstream |
| Late-arriving data | La tabla no se actualizó en las últimas 4 horas |
| ML model drift | Las predicciones del modelo empezaron a degradarse |
Usa la telemetría nativa de la plataforma (system tables, event logs de DLT, métricas de data quality) y no necesita que configures nada externo. Está ahí porque vive dentro de Databricks.
TipSilent failures: el verdadero enemigo
La mayoría de las herramientas de monitoreo te avisan cuando algo falla. Pocas te avisan cuando algo parece que funciona pero los datos están mal. Un pipeline que completa con 0 rows sin error es técnicamente exitoso — pero tu dashboard queda vacío. ZeroOps apunta a detectar eso.
Paso 2: Assess — root cause con lineage
Acá es donde se pone interesante. Cuando ZeroOps detecta un problema, no te dice “el job X falló” y listo. Usa el dependency graph de Unity Catalog para rastrear la causa raíz a través de toda la cadena.
¿El error está en tu pipeline? ¿O es un schema change que alguien hizo tres tablas upstream? ¿O datos inválidos que introdujo otro equipo en una tabla compartida?
ZeroOps correlaciona:
- Logs de ejecución del job que falló
- Lineage de Unity Catalog (tabla → tabla → tabla hasta el origen)
- Data quality metrics (expectations, null rates, row counts)
- Contexto del workload (cuándo fue la última ejecución exitosa, qué cambió desde entonces)
Esto es lo que haría un engineer senior con experiencia en tu plataforma — pero en segundos, no en horas.
ImportanteEl lineage nativo es la diferencia clave
Herramientas como Monte Carlo, Datadog o PagerDuty hacen pedazos de esto. Pero se conectan por API, ven metadata parcial, y no tienen acceso al grafo completo de dependencias. ZeroOps tiene acceso nativo a todo el lineage de Unity Catalog — cada tabla, cada columna, cada transformación. Eso es lo que le permite trazar un error hasta el origen sin configuración adicional.
En la sesión de DAIS sobre Data Quality, mostraron un caso concreto: un dashboard de revenue roto. ZeroOps rastreó la causa hasta un schema change en una tabla upstream y propuso el fix en minutos.
Paso 3: Remediate — genera el fix
Una vez que identificó la causa raíz, ZeroOps genera el fix concreto usando agentic code generation. No es una sugerencia vaga — es código (SQL, Python, config) que podés revisar y aplicar.
Lo que hace diferente a esta generación de código:
- Está informado por el lineage: sabe qué tablas dependen de qué, qué campos se usan downstream
- Conoce tu workflow de desarrollo: GitHub PRs, Jira tickets (cuando están integrados)
- Tiene contexto del historial: sabe cuándo fue la última ejecución exitosa y qué cambió
Para modelos de ML, el flujo es aún más específico:
- Detecta que el modelo degradó (drift en predictions o en métricas de evaluación)
- Construye un modelo candidato corregido
- Lo evalúa con el mismo evaluation suite que usás en producción
- Solo lo propone si performa mediblemente mejor que el modelo actual
No te reemplaza el modelo sin preguntarte. Te dice: “construí este candidato, acá están las métricas comparadas contra tu modelo actual, ¿lo querés deployar?”
Paso 4: Verify — sandbox aislado
Este es el paso que separa a ZeroOps de un script que aplica fixes automáticamente. Nada se aplica en producción sin que vos lo apruebes.
El sandbox tiene 3 capas de seguridad:
| Capa | Qué hace |
|---|---|
| Zero-copy shallow clones | Usa los datos reales sin copiarlos. No duplica storage, no crea réplicas. |
| Scoped permissions | El agente solo accede a lo que necesita para testear el fix. |
| Network isolation | El sandbox está aislado de producción — si el fix tiene un bug, no afecta nada. |
El flujo:
- ZeroOps genera el fix
- Lo ejecuta en el sandbox contra tus datos reales (vía shallow clone)
- Compara resultados: ¿el fix resuelve el problema? ¿introduce regresiones?
- Te presenta todo en una UI inbox-style: el issue, la causa raíz, el fix propuesto, y los resultados del sandbox
- Vos aprobás, editás, o rechazás
AdvertenciaHuman-in-the-loop: no es opcional
ZeroOps requiere aprobación humana explícita antes de aplicar cualquier cambio en producción. Esto no es un setting que se puede desactivar — es parte del diseño. Y tiene sentido: un agente que aplica fixes automáticamente sin supervisión es un agente que puede romper cosas silenciosamente.
Qué soporta hoy y qué viene
| Workload | Estado | Qué detecta/arregla |
|---|---|---|
| Jobs | Private Preview | Failures, timeout, resource issues |
| Pipelines (Lakeflow DLT) | Private Preview | Expectations fallidas, schema drift, CDC issues |
| Tables (Unity Catalog) | Private Preview | Data quality, freshness, schema changes |
| ML Models | Private Preview | Model drift, prediction degradation |
| Apps | Roadmap | TBD |
| Lakebase | Roadmap | TBD |
Disponibilidad: Private Preview en AWS, Azure y GCP — sin fechas confirmadas de GA. Para acceder hay que contactar a tu account team de Databricks.
Cómo se conecta con todo lo anterior
Si venís leyendo la serie, ZeroOps es el eslabón que conecta todas las piezas:
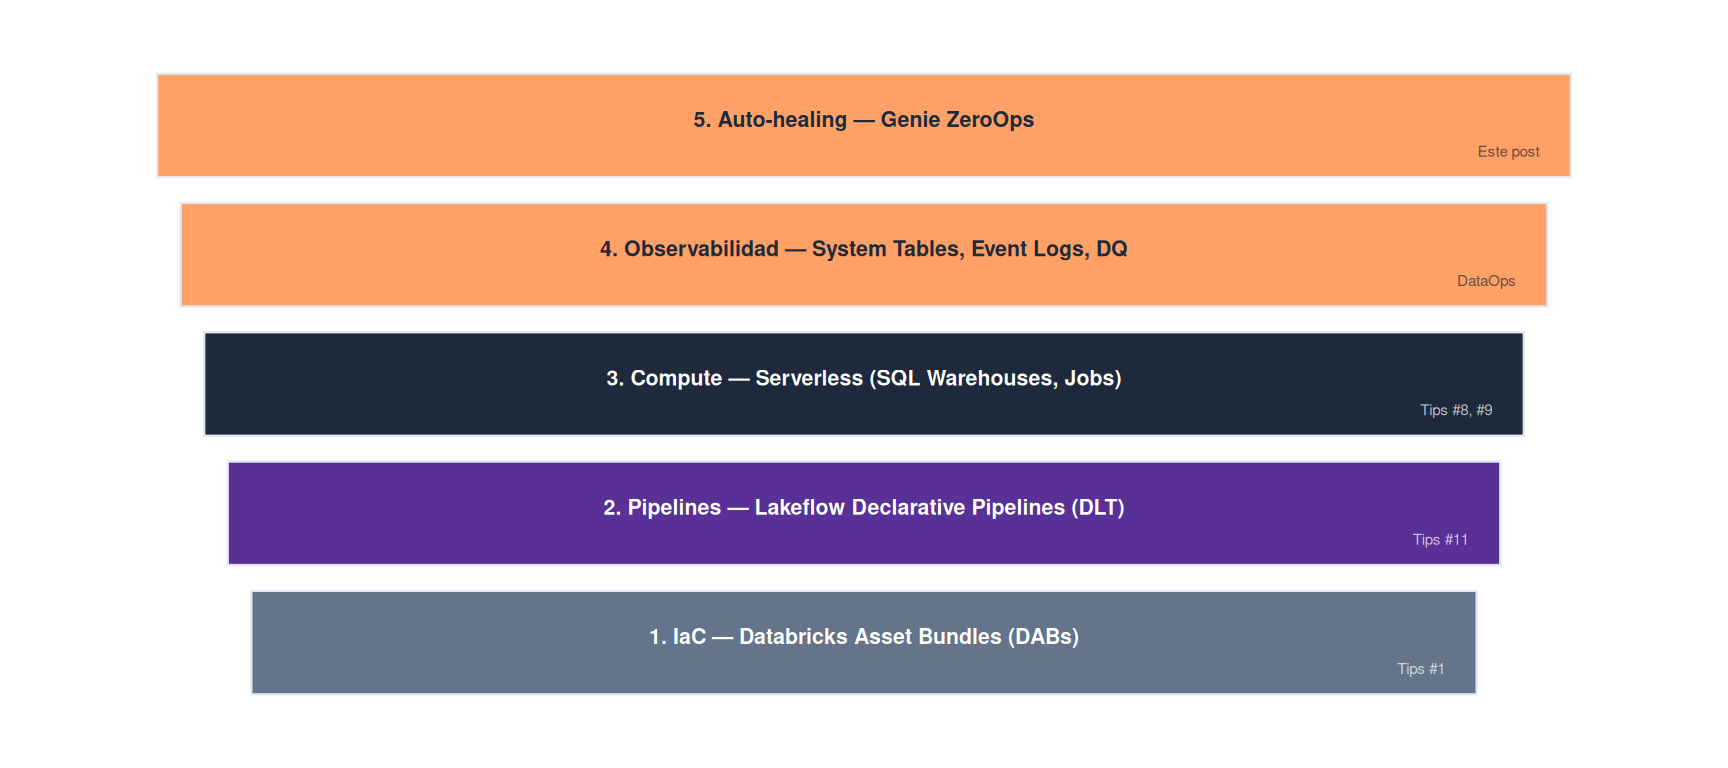
Cada capa la cubrimos en un post. ZeroOps es la capa final que cierra el loop: cuando algo se rompe en las capas 1-4, la capa 5 lo detecta, diagnostica y propone el fix.
| Capa | Post | Qué automatiza |
|---|---|---|
| IaC | Tips #1: DABs | Creación de recursos (jobs, pipelines, permisos) |
| Pipelines | Tips #11: Lakeflow DLT | Orquestación, quality gates, CDC |
| Compute | Tips #8 / #9 | Triggers, auto-scaling, serverless |
| Observabilidad | DataOps | Monitoreo, alertas, SLAs |
| Auto-healing | Este post | Detect → diagnose → fix → verify |
Genie Code vs Genie ZeroOps
Esto genera confusión porque ambos son “Genie” y ambos generan código. Pero hacen cosas fundamentalmente distintas:
| Genie Code | Genie ZeroOps | |
|---|---|---|
| Cuándo | Mientras desarrollás | Mientras tus pipelines corren en prod |
| Cómo | Vos le pedís ayuda | Él detecta problemas solo |
| Qué genera | Pipelines, queries, notebooks nuevos | Fixes para pipelines existentes |
| Interacción | Chat interactivo (copilot) | Inbox async (issues priorizados) |
| Analogía | Pair programmer | SRE automático |
Son complementarios: Code te ayuda a construir más rápido, ZeroOps te ayuda a que lo que construiste no se rompa.
Gotchas y preguntas abiertas
Private Preview = puede cambiar. Todo lo que cubrimos acá es pre-GA. Features, UI, limitaciones — todo puede ser distinto cuando salga a público.
False positives. ¿Qué pasa si el fix propuesto es incorrecto? El sandbox mitiga el riesgo, pero si el agente te llena la inbox de fixes innecesarios, dejás de prestarle atención. La señal/ruido va a ser clave.
Skill atrophy. Si los engineers dejan de debuggear porque el agente lo hace por ellos, pierden la capacidad de resolver lo que el agente no puede resolver. Métrica a monitorear: % de fixes aprobados sin editar. Si es muy alto, o el agente es perfecto (improbable) o tu equipo dejó de revisar.
Costo del agente. ¿Cuánto compute consume el agente corriendo en background 24/7? No hay pricing publicado. Para equipos con presupuesto ajustado, esto puede ser un deal-breaker.
Vendor lock-in. Todo el stack ZeroOps (lineage, sandbox, code generation) es 100% Databricks. Si tu estrategia es multi-cloud o multi-vendor, esto te ata más a la plataforma.
Data Mesh. ¿El agente respeta los boundaries de dominio? Si el equipo de Marketing tiene sus pipelines y el de Finance los suyos, ¿ZeroOps puede proponer un fix que cruce dominios? ¿O se limita al scope del equipo?
TipMétricas que un CIO debería trackear
Si tu organización adopta ZeroOps, estas son las métricas que importan: MTTD/MTTR (tiempo de detección y resolución), % de incidentes cerrados sin intervención humana, accuracy del root cause analysis, false positive rate de los fixes propuestos, costo por incidente neto del compute del agente, y proporción de fixes aprobados sin editar.
Cuándo NO necesitás ZeroOps
| Escenario | Mejor approach |
|---|---|
| Equipo de 1-2 personas, pocos pipelines | DataOps básico + alertas |
| Pipelines experimentales o ad-hoc | Notebooks interactivos |
| No tenés Unity Catalog configurado | Primero governance, después ZeroOps |
| Tu organización exige aprobación manual de cada cambio | ZeroOps tiene human-in-the-loop, pero verificá que cumple tu compliance |
| Presupuesto muy ajustado | Job Clusters + cron + alertas manuales |
Disclaimer: no lo pudimos probar
Genie ZeroOps está en Private Preview. No hay acceso público, no hay free trial, no hay sandbox para jugar. Todo lo que cubrimos en este post viene de la documentación oficial de Databricks, las sesiones de DAIS 2026, y fuentes de terceros.
No vimos la UI en persona, no probamos el sandbox, no validamos la calidad de los fixes. Hasta que no lo uses en tus propios pipelines, es marketing. Cuando esté disponible en GA (o en public preview), vamos a hacer un post de follow-up con pruebas reales y opinión honesta.
Mi opinión: ¿cambia el juego?
Si funciona como prometen, Genie ZeroOps es el feature más importante de DAIS 2026 para engineers que operan pipelines en producción. No porque sea revolucionario en concepto — PagerDuty, Datadog y Monte Carlo hacen pedazos de esto hace años. Lo nuevo es tenerlo nativo, con acceso al lineage completo, telemetría de primera mano y un sandbox integrado que no requiere configuración.
La diferencia de posicionamiento importa: la mayoría de los vendors de agents apuntan al build layer (escribir código más rápido) o al use layer (hacer preguntas sobre datos). ZeroOps apunta al operate layer — el que nadie quiere tocar pero donde se pierde la mayor cantidad de tiempo.
El human-in-the-loop es clave. Sin eso, nadie confiaría. La pregunta real no es si ZeroOps puede detectar y proponer fixes — es cuánto del 80% de mantenimiento puede automatizar en la práctica. Eso solo lo vamos a saber cuando lo probemos.
Lo probamos y les cuento.
Referencias
- Introducing Genie ZeroOps — Databricks Blog
- Databricks targets AI operations bottlenecks with ZeroOps — InfoWorld
- Genie ZeroOps: Automatic Diagnosis and Remediation — TalentBricks
- Genie ZeroOps shifts engineers from firefighting — CompleteAITraining
- Sesión DAIS: Genie ZeroOps for Data Quality and Compliance at Scale
- Lakeflow: A new era of agentic data engineering — Databricks Blog
- Databricks Launches Genie One — Press Release
En la próxima entrega de Databricks Tips vamos a seguir profundizando en el ecosistema de Databricks. Si tenés acceso a la Private Preview de ZeroOps y querés compartir tu experiencia, escribime — me encantaría hacer el follow-up con datos reales.