Databricks Tips #11: Lakeflow Declarative Pipelines (ex DLT) — pipelines declarativos con calidad built-in
Databricks Tips
Data Engineering
Streaming
Streaming tables, materialized views, expectations, AUTO CDC con SCD Type 1/2, modos triggered vs continuous, serverless y los gotchas que no están en el tutorial.
Escribís un pipeline de Spark Structured Streaming. Funciona. Lo ponés en producción. Tres semanas después se rompe porque el schema de la fuente cambió, nadie se enteró de que el 15% de las filas tienen nulos en la clave primaria, y el MERGE que armaste para CDC tiene un bug sutil con eventos fuera de orden.
Lakeflow Declarative Pipelines (lo que antes se llamaba Delta Live Tables / DLT) resuelve exactamente eso: vos declarás qué querés y el framework se encarga del cómo.
NotaTL;DR
- Streaming tables para ingesta incremental, materialized views para aggregaciones, views para lógica intermedia.
- Expectations validan calidad en cada registro: warn, drop o fail.
- AUTO CDC reemplaza tu MERGE manual con SCD Type 1 y Type 2 out-of-the-box.
- Triggered mode para batch eficiente, continuous para latencia sub-minuto.
- Serverless agrega autoscaling vertical y stream pipelining sin configurar compute.
- Requiere plan Premium.
0. El rename: DLT → Lakeflow Declarative Pipelines
Databricks renombró Delta Live Tables a Lakeflow Declarative Pipelines (SDP). El módulo Python ahora es pyspark.pipelines. La funcionalidad es la misma; el nombre refleja que el core se open-sourced como parte de Apache Spark 4.1.
En este post uso “DLT” y “SDP” indistintamente — la industria todavía dice “DLT” y Databricks todavía acepta ambos nombres.
1. Los 3 tipos de datasets
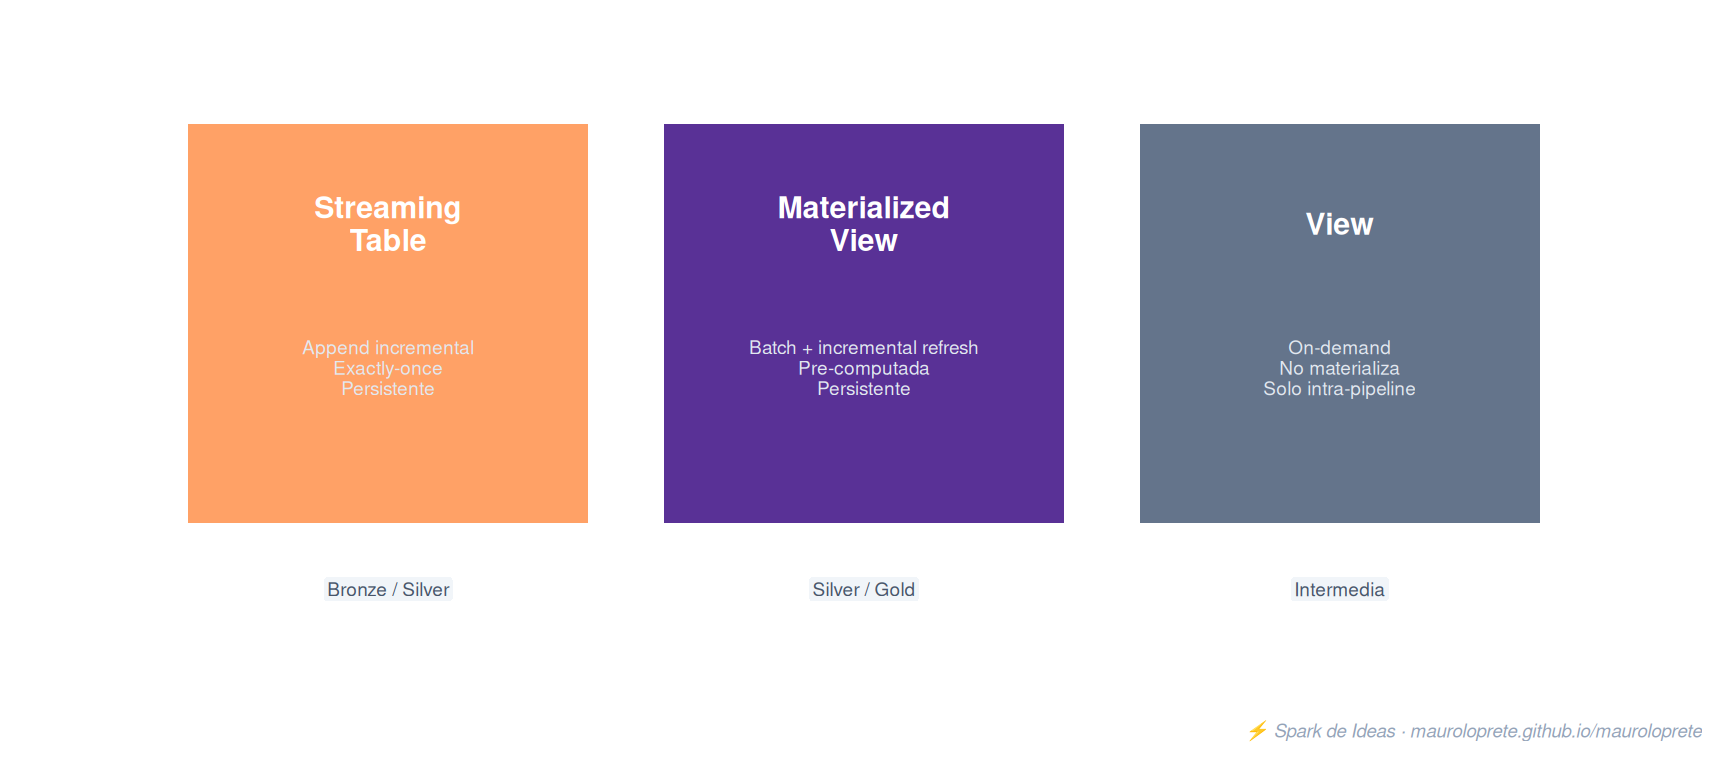
Streaming Table
Tabla Delta persistente que procesa cada registro exactamente una vez (append-only por defecto). Ideal para ingesta desde cloud storage, Kafka, Event Hubs.
CREATE OR REFRESH STREAMING TABLE raw_transactions
AS SELECT * FROM STREAM read_files(
  '/Volumes/catalog/schema/volume/transactions/',
  format => 'json'
)from pyspark import pipelines as dp
@dp.table
def raw_transactions():
return (
spark.readStream
.format("cloudFiles")
.option("cloudFiles.format", "json")
.load("/Volumes/catalog/schema/volume/transactions/")
)Materialized View
Tabla Delta persistente con refresh incremental. Se recalcula eficientemente solo procesando datos nuevos o cambios. Ideal para aggregaciones, joins costosos y tablas Gold.
CREATE OR REFRESH MATERIALIZED VIEW daily_revenue
AS SELECT
  transaction_date,
  segment,
  SUM(amount) AS total_revenue,
  COUNT(*) AS transaction_count
FROM silver_transactions
GROUP BY transaction_date, segment@dp.materialized_view
def daily_revenue():
return (
spark.read.table("silver_transactions")
.groupBy("transaction_date", "segment")
.agg(
F.sum("amount").alias("total_revenue"),
F.count("*").alias("transaction_count"),
)
)View (temporal)
No materializa datos. Se computa on-demand cuando la consulta un otro dataset del pipeline. No existe fuera del pipeline.
CREATE TEMPORARY VIEW valid_transactions
AS SELECT *
FROM STREAM(raw_transactions)
WHERE amount > 0 AND customer_id IS NOT NULL
Tabla comparativa
| Aspecto | Streaming Table | Materialized View | View |
|---|---|---|---|
| Procesamiento | Streaming incremental | Batch con incremental refresh | On-demand |
| Persiste datos | Sí | Sí | No |
| Visible fuera del pipeline | Sí | Sí | No |
| Time travel (Delta) | Sí | No | No |
| Target de AUTO CDC | Sí | No | No |
| Soporte DML (INSERT/UPDATE) | Sí | No | No |
| Caso típico | Ingesta, CDC | Aggregaciones, Gold | Lógica intermedia |
2. Expectations: calidad de datos declarativa
Las expectations son reglas de calidad que se aplican registro por registro. Tres comportamientos posibles:
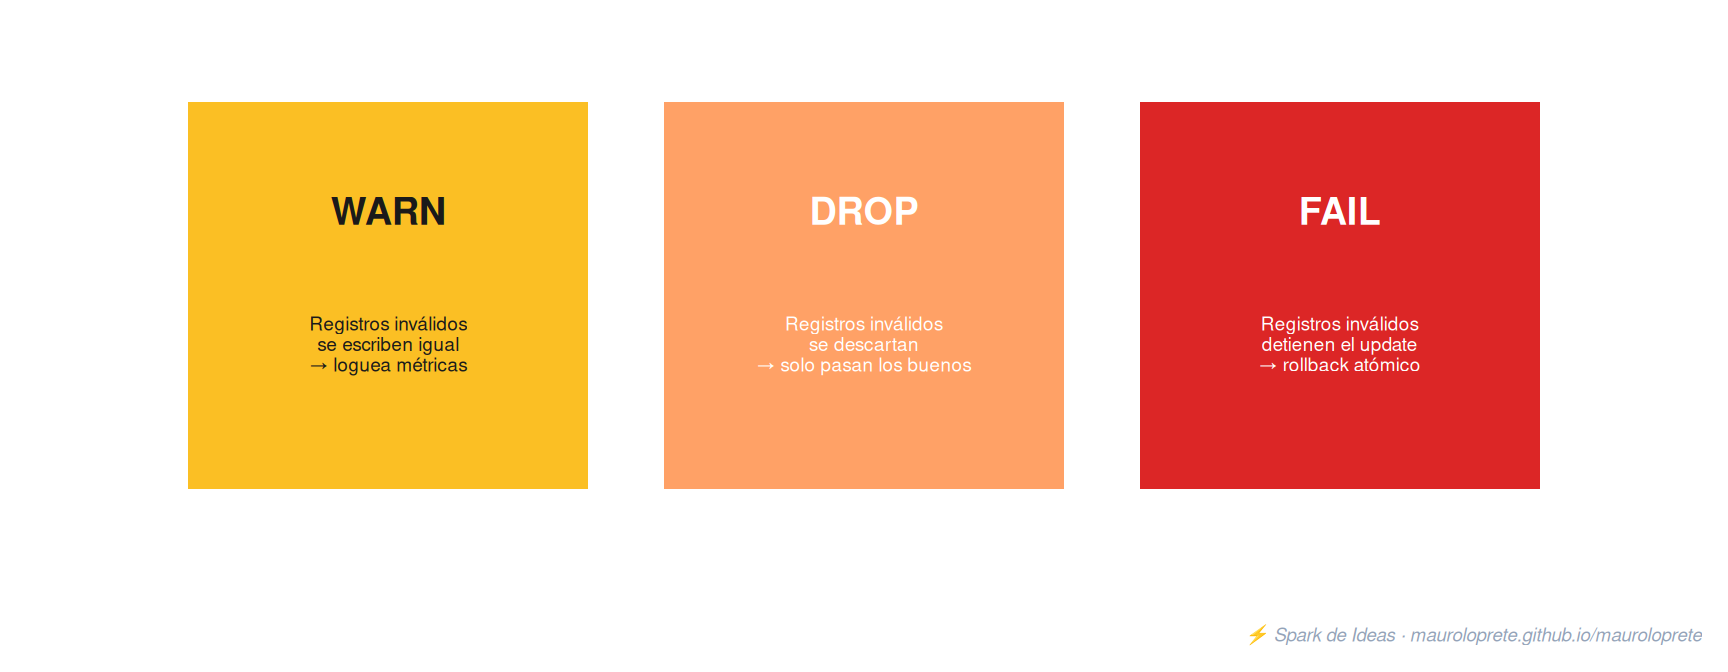
| Acción | SQL | Python | Registros inválidos… |
|---|---|---|---|
| Warn | EXPECT |
@dp.expect |
Se escriben, se loguean métricas |
| Drop | EXPECT ... ON VIOLATION DROP ROW |
@dp.expect_or_drop |
Se descartan silenciosamente |
| Fail | EXPECT ... ON VIOLATION FAIL UPDATE |
@dp.expect_or_fail |
Detienen el pipeline (rollback) |
Ejemplo completo en SQL
CREATE OR REFRESH STREAMING TABLE silver_transactions (
  -- Warn: loguea pero deja pasar
  CONSTRAINT valid_amount
    EXPECT (amount > 0),

  -- Drop: descarta filas inválidas
  CONSTRAINT valid_customer
    EXPECT (customer_id IS NOT NULL AND email IS NOT NULL)
    ON VIOLATION DROP ROW,

  -- Fail: detiene el pipeline si hay violación
  CONSTRAINT valid_currency
    EXPECT (currency IN ('USD', 'EUR', 'ARS', 'UYU'))
    ON VIOLATION FAIL UPDATE
)
AS SELECT
  transaction_id,
  customer_id,
  email,
  amount,
  currency,
  transaction_date,
  current_timestamp() AS _silver_timestamp
FROM STREAM(raw_transactions)
Ejemplo en Python con expect_all
quality_rules = {
    "valid_amount": "amount > 0",
    "valid_customer": "customer_id IS NOT NULL",
    "valid_email": "email IS NOT NULL",
}

@dp.table
@dp.expect_all_or_drop(quality_rules)
def silver_transactions():
    return (
        spark.readStream.table("raw_transactions")
        .withColumn("_silver_timestamp", F.current_timestamp())
    )
Pattern: quarantine (retener los rechazados)
En vez de descartar registros, ruteá los inválidos a una tabla de cuarentena para investigación:
@dp.table
@dp.expect_or_drop("valid_record", "customer_id IS NOT NULL AND amount > 0")
def silver_transactions():
    return spark.readStream.table("raw_transactions")

@dp.table
def quarantine_transactions():
    return (
        spark.readStream.table("raw_transactions")
        .filter("customer_id IS NULL OR amount <= 0")
    )
ImportanteLimitaciones de expectations
- Los constraints son expresiones SQL booleanas. No pueden usar funciones Python custom, llamadas a APIs externas, ni subqueries contra otras tablas.
- Las métricas de
failno se registran (el pipeline falla antes de loguear). - No soportadas con
AUTO CDC FROM SNAPSHOT.
3. AUTO CDC: Change Data Capture sin sufrir
AUTO CDC (antes APPLY CHANGES INTO) maneja Change Data Capture automáticamente: deduplicación, eventos fuera de orden, SCD Type 1 y Type 2. Lo que antes eran cientos de líneas de MERGE manual.
Requiere edición Pro o Advanced (o serverless).
SCD Type 1: solo la última versión
CREATE OR REFRESH STREAMING TABLE customers_current;

CREATE FLOW apply_customers_cdc
AS AUTO CDC INTO customers_current
FROM STREAM(raw_customers_cdc)
KEYS (customer_id)
APPLY AS DELETE WHEN operation = 'DELETE'
SEQUENCE BY updated_at
COLUMNS * EXCEPT (operation, updated_at)
STORED AS SCD TYPE 1;dp.create_streaming_table("customers_current")
dp.create_auto_cdc_flow(
target="customers_current",
source="raw_customers_cdc",
keys=["customer_id"],
sequence_by=col("updated_at"),
apply_as_deletes=expr("operation = 'DELETE'"),
except_column_list=["operation", "updated_at"],
stored_as_scd_type=1,
)SCD Type 2: historial completo
SCD Type 2 mantiene todas las versiones de cada registro con columnas __START_AT y __END_AT:
CREATE OR REFRESH STREAMING TABLE customers_history;

CREATE FLOW apply_customers_history
AS AUTO CDC INTO customers_history
FROM STREAM(raw_customers_cdc)
KEYS (customer_id)
APPLY AS DELETE WHEN operation = 'DELETE'
SEQUENCE BY updated_at
COLUMNS * EXCEPT (operation, updated_at)
STORED AS SCD TYPE 2;
Resultado para un cliente que cambió de ciudad:
| customer_id | name | city | __START_AT | __END_AT |
|---|---|---|---|---|
| 125 | Mercedes | Tijuana | 2 | 5 |
| 125 | Mercedes | Mexicali | 5 | 6 |
| 125 | Mercedes | Guadalajara | 6 | null (activo) |
Trackear solo algunas columnas
Si no querés una nueva versión por cada cambio menor:
STORED AS SCD TYPE 2
TRACK HISTORY ON * EXCEPT (last_login, session_count)
Cambios en last_login o session_count actualizan el registro actual sin crear una nueva versión.
TipTip: secuenciamiento con múltiples columnas
Si tu fuente no tiene un timestamp único, podés usar un struct:
SEQUENCE BY STRUCT(timestamp_col, id_col)4. Pipeline modes: triggered vs continuous
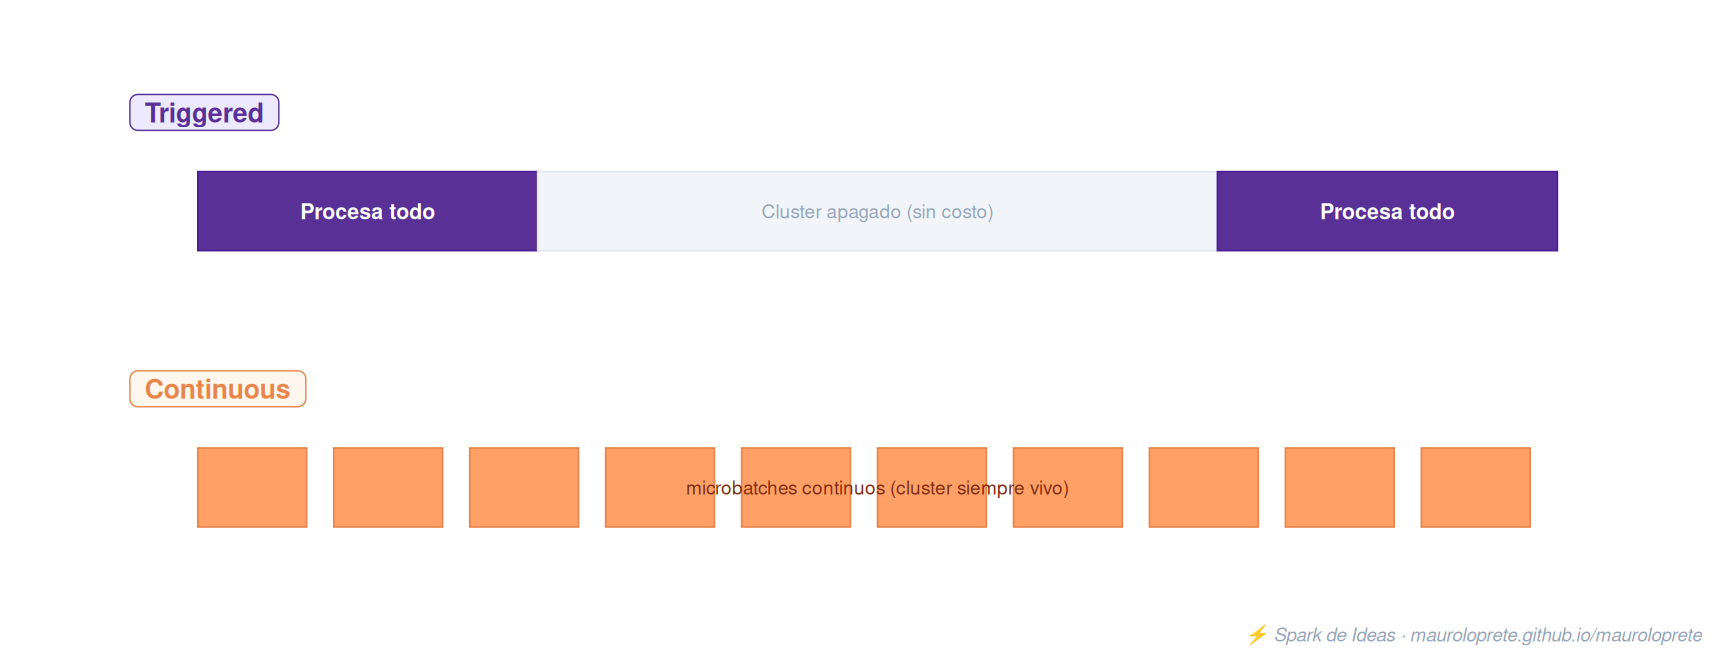
| Triggered | Continuous | |
|---|---|---|
| Cuándo para | Automáticamente al completar | Corre hasta stop manual |
| Qué procesa | Datos disponibles al momento del update | Datos a medida que llegan |
| Latencia | Minutos a horas (según schedule) | 10 segundos a pocos minutos |
| Costo | Cluster solo corre lo necesario | Cluster siempre vivo |
| Caso de uso | La mayoría de pipelines | Latencia sub-minuto |
Regla: empezá con triggered siempre. Solo usá continuous si tenés un requerimiento real de latencia sub-minuto. El 90% de los pipelines no lo necesitan.
Trigger interval en continuous
@dp.table(spark_conf={"pipelines.trigger.interval": "10 seconds"})
def streaming_silver():
    return spark.readStream.table("raw_transactions")
Ediciones del producto
| Edición | CDC | Expectations | Retención de updates |
|---|---|---|---|
| Core | No | No | 5 días |
| Pro | Sí | No | 30 días |
| Advanced | Sí | Sí | 30 días |
Si usás serverless, todas las features están incluidas sin elegir edición.
5. Medallion con DLT: el patrón completo
La arquitectura Medallion calza perfecto con DLT. Un pipeline completo Bronze → Silver → Gold:
Pipeline completo en SQL
-- ========== BRONZE: ingesta raw ==========
CREATE OR REFRESH STREAMING TABLE bronze_transactions
AS SELECT
  *,
  current_timestamp() AS _ingest_timestamp,
  _metadata.file_path AS _source_file
FROM STREAM read_files(
  '/Volumes/catalog/schema/volume/transactions/',
  format => 'json'
);

-- ========== SILVER: limpieza + validación ==========
CREATE OR REFRESH STREAMING TABLE silver_transactions (
  CONSTRAINT valid_amount
    EXPECT (amount > 0),
  CONSTRAINT valid_customer
    EXPECT (customer_id IS NOT NULL)
    ON VIOLATION DROP ROW
)
AS SELECT
  transaction_id,
  customer_id,
  UPPER(TRIM(email)) AS email,
  CAST(amount AS DECIMAL(18,2)) AS amount,
  currency,
  CAST(transaction_date AS DATE) AS transaction_date,
  current_timestamp() AS _silver_timestamp
FROM STREAM(bronze_transactions);

-- ========== GOLD: modelo de negocio ==========
CREATE OR REFRESH MATERIALIZED VIEW gold_daily_revenue
AS SELECT
  transaction_date,
  currency,
  COUNT(*) AS transaction_count,
  SUM(amount) AS total_revenue,
  AVG(amount) AS avg_ticket,
  COUNT(DISTINCT customer_id) AS unique_customers
FROM silver_transactions
GROUP BY transaction_date, currency;
Pipeline en Python
from pyspark import pipelines as dp
from pyspark.sql import functions as F

# Bronze
@dp.table
def bronze_transactions():
    return (
        spark.readStream
        .format("cloudFiles")
        .option("cloudFiles.format", "json")
        .load("/Volumes/catalog/schema/volume/transactions/")
        .withColumn("_ingest_timestamp", F.current_timestamp())
    )

# Silver
quality_rules = {
    "valid_amount": "amount > 0",
    "valid_customer": "customer_id IS NOT NULL",
}

@dp.table
@dp.expect_all_or_drop(quality_rules)
def silver_transactions():
    return (
        spark.readStream.table("bronze_transactions")
        .withColumn("email", F.upper(F.trim(F.col("email"))))
        .withColumn("amount", F.col("amount").cast("decimal(18,2)"))
        .withColumn("_silver_timestamp", F.current_timestamp())
    )

# Gold
@dp.materialized_view
def gold_daily_revenue():
    return (
        spark.read.table("silver_transactions")
        .groupBy("transaction_date", "currency")
        .agg(
            F.count("*").alias("transaction_count"),
            F.sum("amount").alias("total_revenue"),
            F.avg("amount").alias("avg_ticket"),
            F.countDistinct("customer_id").alias("unique_customers"),
        )
    )
TipTip: separar ingesta de transformación
En producción, separar el pipeline de ingesta (Bronze) del de transformación (Silver/Gold). Un fallo en la transformación no bloquea la ingesta, y cada pipeline puede tener su propio schedule y scaling.
6. Event log: monitoring y métricas
El event log registra todo lo que pasa en el pipeline: calidad de datos, progreso, linaje, autoscaling.
Consultar métricas de calidad
SELECT
  row_exp.dataset AS dataset,
  row_exp.name AS expectation,
  SUM(row_exp.passed_records) AS passing,
  SUM(row_exp.failed_records) AS failing
FROM (
  SELECT explode(
    from_json(
      details:flow_progress:data_quality:expectations,
      'array<struct<name:string, dataset:string, passed_records:int, failed_records:int>>'
    )
  ) AS row_exp
  FROM event_log('<pipeline_id>')
  WHERE event_type = 'flow_progress'
)
GROUP BY row_exp.dataset, row_exp.name
Consultar linaje
SELECT
  details:flow_definition.output_dataset AS output,
  details:flow_definition.input_datasets AS inputs,
  details:flow_definition.flow_type AS type
FROM event_log('<pipeline_id>')
WHERE details:flow_definition IS NOT NULL
Consultar consumo de DBUs
SELECT
  sku_name,
  usage_date,
  SUM(usage_quantity) AS dbus
FROM system.billing.usage
WHERE usage_metadata.dlt_pipeline_id = '<pipeline_id>'
GROUP BY sku_name, usage_date
ORDER BY usage_date DESC
Publicar el event log como tabla
Por defecto el event log solo es accesible vía la función event_log(). Para compartirlo:
{
  "event_log": {
    "catalog": "analytics",
    "schema": "monitoring",
    "name": "dlt_event_log"
  }
}
7. Serverless DLT: qué cambia
| Aspecto | Classic compute | Serverless |
|---|---|---|
| Configuración | Instance type, min/max workers, modo enhanced | Nada — Databricks gestiona todo |
| Autoscaling horizontal | Enhanced autoscaling | Siempre habilitado |
| Autoscaling vertical | No | Sí — detecta OOM y sube instance type |
| Stream pipelining | Secuencial (un microbatch a la vez) | Concurrente (mejor throughput) |
| Incremental refresh (MVs) | Limitado | Siempre disponible |
| Startup | 4-6 min (standard), más rápido con pools | Segundos |
Autoscaling vertical
Serverless detecta automáticamente errores de out-of-memory y provisiona instance types más grandes. Si después detecta memoria subutilizada, escala hacia abajo. No tenés que configurar nada.
Stream pipelining
En lugar de procesar microbatches secuencialmente (el modo clásico de Structured Streaming), serverless ejecuta microbatches concurrentemente, mejorando utilización y throughput.
Dos modos de performance
| Modo | Startup típico | Costo DBU | Cuándo usarlo |
|---|---|---|---|
| Standard | 4-6 min | Menor | La mayoría de pipelines |
| Performance-optimized | Segundos | Mayor | Pipelines críticos de latencia |
NotaRequisitos para serverless
- Unity Catalog habilitado
- Región con soporte de serverless
- Al convertir a serverless, todas las configuraciones de compute se pierden. Si volvés a no-serverless, hay que reconfigurar.
8. Enhanced autoscaling
Enhanced autoscaling es el default para pipelines nuevos. Está optimizado para workloads de streaming y escala de forma proactiva.
Diferencias vs autoscaling standard
- Standard: solo baja nodos idle (puede tardar en reaccionar)
- Enhanced: baja nodos infrautilizados proactivamente, garantizando que no haya tasks fallidas durante el shutdown
Métricas que usa para escalar
- Task slot utilization: ratio de slots ocupados / total disponibles
- Task queue size: tasks esperando ejecución
Configuración
{
  "clusters": [{
    "autoscale": {
      "min_workers": 2,
      "max_workers": 10,
      "mode": "ENHANCED"
    }
  }]
}
TipBuena práctica
Dejá min_workers en el default. Configurá max_workers basado en tu presupuesto. En serverless, no configurás nada — el autoscaling es automático en ambas direcciones.
9. Tablas privadas y control de acceso
Tablas privadas
Si una tabla es intermedia y no necesitás exponerla fuera del pipeline:
CREATE PRIVATE STREAMING TABLE internal_staging
AS SELECT * FROM STREAM(raw_data)
WHERE valid = true
Row filters
Podés aplicar row-level security directamente en la definición:
CREATE OR REFRESH STREAMING TABLE orders (
  CONSTRAINT valid_id EXPECT (id IS NOT NULL)
)
WITH ROW FILTER region_filter ON (region)
AS SELECT * FROM STREAM(raw_orders)
AdvertenciaCuidado con row filters + MVs
Si creás una materialized view sobre una fuente con row filters o column masks, el refresh es siempre full refresh (no incremental). Puede impactar significativamente el costo.
10. DLT vs Structured Streaming: cuándo usar cada uno
| Criterio | Lakeflow SDP | Structured Streaming puro |
|---|---|---|
| CDC automático | Nativo (AUTO CDC, SCD 1/2) | MERGE manual, dedup propio |
| Data quality | Expectations con métricas | Validaciones ad-hoc |
| Linaje | Automático en Unity Catalog | Manual |
| Orquestación | Automática (DAG, retry multinivel) | Manual con Jobs |
| Monitoring | Event log + pipeline UI | StreamingQueryListener |
| Incremental refresh de MVs | Nativo en serverless | Lógica custom |
| Flexibilidad | Opinionado, dentro del framework | Control total |
| Plan requerido | Premium | Cualquiera |
| JARs custom | No (solo Python) | Sí |
| Latencia sub-segundo | Solo con real-time mode (beta) | Nativo |
Regla: si estás construyendo pipelines en el lakehouse (bronze/silver/gold) y tenés plan Premium, usá DLT. Si necesitás control granular sobre checkpoints, output modes o sinks custom, usá Structured Streaming directo.
En la práctica, muchos equipos combinan ambos: DLT para el core del pipeline y Jobs con Structured Streaming para casos edge que DLT no cubre.
11. Gotchas
1. Streaming tables son append-only por defecto. Si tu fuente tiene updates o deletes (por ejemplo, otra streaming table modificada con DML), necesitás el flag skipChangeCommits o usar CDF.
2. Materialized views no son fuentes de streaming fuera del pipeline. Una MV creada en un pipeline no puede usarse como readStream en otro pipeline o notebook. Para eso, usá streaming tables.
3. Cuidado con for loops en Python.
# MAL: todas las tablas leen la última tabla del loop
for name in table_names:
    @dp.table(name=name)
    def create_table():
        return spark.read.table(name)  # name se evalúa lazy

# BIEN: capturar el valor con default argument
for name in table_names:
    @dp.table(name=name)
    def create_table(t=name):
        return spark.read.table(t)
4. pipelines.reset.allowed = false para proteger datos. Si hacés DML manual sobre una streaming table (ej: GDPR deletes), un full refresh la recomputa desde cero y perdés los cambios. Protegela:
CREATE OR REFRESH STREAMING TABLE protected_table
TBLPROPERTIES(pipelines.reset.allowed = false)
AS SELECT * FROM STREAM read_files('...')
5. Identity columns + AUTO CDC = no. Identity columns no están soportadas en targets de AUTO CDC. Usá claves de negocio.
6. Archivos subyacentes de MVs pueden contener datos sensibles. Los archivos Delta de una MV pueden incluir datos de upstream (PII) que no aparecen en la definición. No compartas el storage subyacente con consumidores no confiables.
7. El event log no es una tabla normal. Solo se accede vía event_log('<pipeline_id>') a menos que lo publiques explícitamente como tabla.
8. Eliminar un pipeline elimina todas sus tablas. No hay undo. Las tablas individuales eliminadas del código se marcan como inactive y se pueden recuperar con UNDROP por 7 días.
9. JARs no soportados con Unity Catalog. Solo Python libraries de terceros. Si tenés un conector custom en JAR, vas a tener que portarlo a Python o usar Structured Streaming directo.
10. Expectations no validan datos históricos. Solo aplican a registros nuevos que llegan durante un update. Si necesitás validar toda la tabla, usá un notebook separado.
12. Cuándo NO usar DLT
| Necesidad | Usá en su lugar |
|---|---|
| Latencia sub-segundo | Structured Streaming directo con ProcessingTime("1 second") |
| Conectores JAR custom | Job Cluster con Structured Streaming |
| Plan Standard (no Premium) | Jobs + Structured Streaming |
| Output a sinks externos (Kafka, REST) | Structured Streaming con custom sinks |
| Control total sobre checkpoints | Structured Streaming manual |
| ETL sin streaming (puro batch SQL) | SQL Warehouse o Job con notebook |
Referencias
Otros posts de la serie
Si te sirvió este post, mirá los anteriores de Databricks Tips:
- Tips #1: Databricks Asset Bundles — IaC para Databricks
- Tips #2: Delta Lake — las 7 cosas que te hubiera gustado saber
- Tips #3: Unity Catalog — gobernanza que nadie implementa bien
- Tips #4: Structured Streaming — watermarks, triggers y micro-batch
- Tips #5: MLflow + Unity Catalog — del experimento al modelo
- Tips #6: Feature Engineering — features que sobreviven a producción
- Tips #7: Docker en Databricks — contenedores custom
- Tips #8: Jobs & Workflows — streaming y triggers event-driven
- Tips #9: SQL Warehouses — el compute que se prende solo
Próxima semana: AI Gateway — governance centralizada para LLMs en producción.