erDiagram
    dim_customer {
        bigint customer_id PK
        string name
        string segment
        string country
    }
    dim_product {
        bigint product_id PK
        string name
        string category
        string brand
    }
    dim_date {
        int date_id PK
        date full_date
        int month
        int year
    }
    fact_sales {
        bigint sale_id PK
        bigint customer_id FK
        bigint product_id FK
        int date_id FK
        decimal amount
        int quantity
    }

    dim_customer ||--o{ fact_sales : ""
    dim_product  ||--o{ fact_sales : ""
    dim_date     ||--o{ fact_sales : ""
Medallion vs Data Vault vs Kimball: cuándo usar cada uno y por qué importa
Data Architecture
Data Engineering
Podcast
Comparativa práctica de los tres modelos de datos más usados en la industria. Con ejemplos reales, trade-offs y una guía para elegir.
Cada vez que arrancás un proyecto de datos, la primera pregunta arquitectónica es: ¿cómo modelo los datos? Y la respuesta que más escucho es “Medallion, obvio”. Pero no siempre es la mejor opción.
En este post comparo los tres enfoques más usados en la industria, con trade-offs reales y sin vender humo.
El problema
Tenés datos crudos de múltiples fuentes y necesitás llevarlos a un estado consumible por analistas, científicos de datos y dashboards. ¿Cómo organizás las capas intermedias?
Kimball (Dimensional Modeling)
El abuelo del modelado de datos. Ralph Kimball lo publicó en los 90 y sigue vigente.
La idea
Organizás los datos en tablas de hechos (fact tables) y tablas de dimensiones (dimension tables). Los hechos son las métricas (ventas, clicks, transacciones), las dimensiones son el contexto (quién, cuándo, dónde, qué).
Cuándo usarlo
- Reportería clásica: dashboards de BI, KPIs, análisis dimensional
- Equipos de analistas que usan SQL: el modelo estrella es intuitivo, los JOINs son simples
- Requerimientos estables: sabés qué preguntas te van a hacer
Cuándo NO usarlo
- Cuando las fuentes cambian seguido (Kimball asume esquemas estables)
- Cuando necesitás auditoría completa del historial de cambios
- Cuando tenés 50+ fuentes con relaciones complejas
En Databricks
-- Fact table
CREATE TABLE gold.fact_sales (
  sale_id BIGINT,
  customer_id BIGINT,
  product_id BIGINT,
  date_id INT,
  amount DECIMAL(18,2),
  quantity INT
)
USING DELTA
CLUSTER BY (date_id, customer_id);

-- Dimension table con SCD Type 2
CREATE TABLE gold.dim_customer (
  customer_sk BIGINT GENERATED ALWAYS AS IDENTITY,
  customer_id BIGINT,
  name STRING,
  segment STRING,
  country STRING,
  valid_from DATE,
  valid_to DATE,
  is_current BOOLEAN
)
USING DELTA;
Data Vault 2.0
Inventado por Dan Linstedt. Es el enfoque más robusto para empresas con muchas fuentes y requerimientos de auditoría.
La idea
Tres tipos de tablas: Hubs (entidades de negocio), Links (relaciones entre hubs) y Satellites (atributos descriptivos con historial).
erDiagram
    hub_customer {
        string hash_key PK
        bigint customer_id
        timestamp load_date
        string record_source
    }
    hub_product {
        string hash_key PK
        bigint product_id
        timestamp load_date
        string record_source
    }
    link_sale {
        string hash_key PK
        string customer_hk FK
        string product_hk FK
        timestamp load_date
        string record_source
    }
    sat_customer {
        string hash_key FK
        string name
        string segment
        string hash_diff
        timestamp load_date
    }
    sat_product {
        string hash_key FK
        string name
        string category
        string hash_diff
        timestamp load_date
    }

    hub_customer ||--o{ link_sale : ""
    hub_product  ||--o{ link_sale : ""
    hub_customer ||--o{ sat_customer : ""
    hub_product  ||--o{ sat_product : ""
Cuándo usarlo
- Muchas fuentes heterogéneas (50+): Data Vault no se rompe cuando agregás una fuente nueva
- Auditoría y compliance: cada registro tiene
load_dateyrecord_source, sabés exactamente de dónde vino cada dato - Equipo grande: se paraleliza bien, cada desarrollador puede trabajar en un Hub/Link sin pisar al otro
- Esquemas que cambian seguido: agregar un atributo es crear un Satellite nuevo, no alterar tablas existentes
Cuándo NO usarlo
- Equipos chicos (< 5 personas): el overhead de mantener Hubs/Links/Satellites no se justifica
- Proyectos rápidos o POCs: demasiada ceremonia
- Si tus analistas van a hacer SQL directamente sobre el vault (es feo de consumir sin una capa de presentación)
En Databricks
-- Hub
CREATE TABLE vault.hub_customer (
  customer_hk STRING,  -- hash de business key
  customer_id BIGINT,
  load_date TIMESTAMP,
  record_source STRING
)
USING DELTA;

-- Satellite
CREATE TABLE vault.sat_customer (
  customer_hk STRING,
  name STRING,
  segment STRING,
  country STRING,
  hash_diff STRING,  -- hash de los atributos para detectar cambios
  load_date TIMESTAMP,
  record_source STRING
)
USING DELTA;

-- Link
CREATE TABLE vault.link_sale (
  sale_hk STRING,
  customer_hk STRING,
  product_hk STRING,
  load_date TIMESTAMP,
  record_source STRING
)
USING DELTA;
Medallion (Bronze / Silver / Gold)
El enfoque que popularizó Databricks. No es un modelo de datos en el sentido de Kimball o Data Vault — es una arquitectura de capas.
La idea
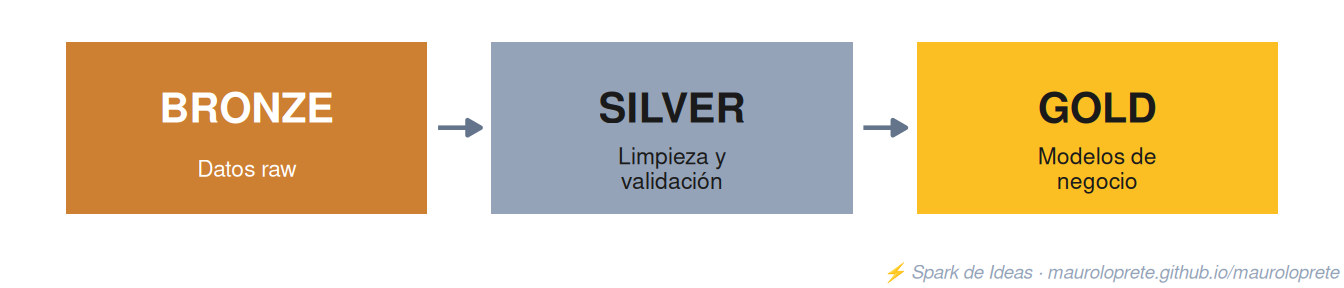
El punto clave que muchos no ven
Medallion no te dice cómo modelar Gold. Solo te dice que hay capas. En Gold podés usar Kimball, Data Vault, o tablas planas. La decisión de modelado sigue siendo tuya.
Cuándo usarlo
- Siempre como arquitectura de capas: es un patrón de organización, no compite con Kimball ni Data Vault
- Equipos que recién arrancan: es simple de entender y de implementar
- Proyectos con Databricks/Delta Lake: está optimizado para el ecosistema
Cuándo NO usarlo (solo)
- Cuando necesitás auditoría formal (Medallion no tiene
record_sourcenativo) - Cuando Gold necesita modelado dimensional serio (ahí combinás con Kimball)
En Databricks
-- Bronze: dato crudo
CREATE TABLE bronze.raw_transactions (
  _ingest_timestamp TIMESTAMP DEFAULT current_timestamp(),
  _source_file STRING,
  payload STRING  -- JSON crudo
)
USING DELTA;

-- Silver: limpio y tipado
CREATE TABLE silver.transactions (
  transaction_id BIGINT,
  customer_id BIGINT,
  amount DECIMAL(18,2),
  transaction_date DATE,
  status STRING,
  _silver_timestamp TIMESTAMP DEFAULT current_timestamp()
)
USING DELTA
CLUSTER BY (transaction_date);

-- Gold: modelo de negocio (acá elegís Kimball, plano, etc.)
CREATE TABLE gold.daily_revenue (
  date DATE,
  segment STRING,
  total_revenue DECIMAL(18,2),
  transaction_count BIGINT,
  avg_ticket DECIMAL(18,2)
)
USING DELTA;
La comparativa
| Criterio | Kimball | Data Vault | Medallion |
|---|---|---|---|
| Complejidad | Media | Alta | Baja |
| Auditoría | Limitada (SCD) | Completa | No nativa |
| Escalabilidad de fuentes | Media | Alta | Alta |
| Curva de aprendizaje | Media | Alta | Baja |
| Consumo por analistas | Excelente | Malo (sin capa) | Depende de Gold |
| Flexibilidad ante cambios | Baja | Alta | Alta |
| Ideal para | BI clásico | Enterprise, compliance | Lakehouse, startups |
Mi recomendación
No son mutuamente excluyentes. El patrón que mejor funciona en la práctica:
Medallion como arquitectura de capas + Kimball en Gold para consumo.
Fuentes → Bronze (raw) → Silver (clean) → Gold (Kimball star schema)Si estás en un contexto enterprise con 50+ fuentes y requerimientos de auditoría:
Medallion + Data Vault en Silver + Kimball en Gold.
Fuentes → Bronze (raw) → Silver (Data Vault) → Gold (Kimball)Y si estás en un equipo chico haciendo un MVP:
Medallion con Gold plano. Sin ceremonias.
Fuentes → Bronze → Silver → Gold (tablas agregadas simples)Lo importante es entender que cada enfoque resuelve un problema distinto. No hay una respuesta universal — hay contexto.
Links
- The Data Warehouse Toolkit (Kimball) — el libro fundacional
- Data Vault 2.0 (Dan Linstedt) — la referencia oficial
Medallion Architecture (Databricks) — documentación oficial
Próxima semana: Data Contracts — cómo diseñar un framework desde cero.