Data Mesh en la práctica: lo que funciona, lo que no, y lo que nadie te dice
Data Architecture
Data Engineering
Podcast
Data Mesh más allá del hype. Los 4 principios, implementación real con Unity Catalog, y por qué la mayoría de las empresas lo implementan mal.
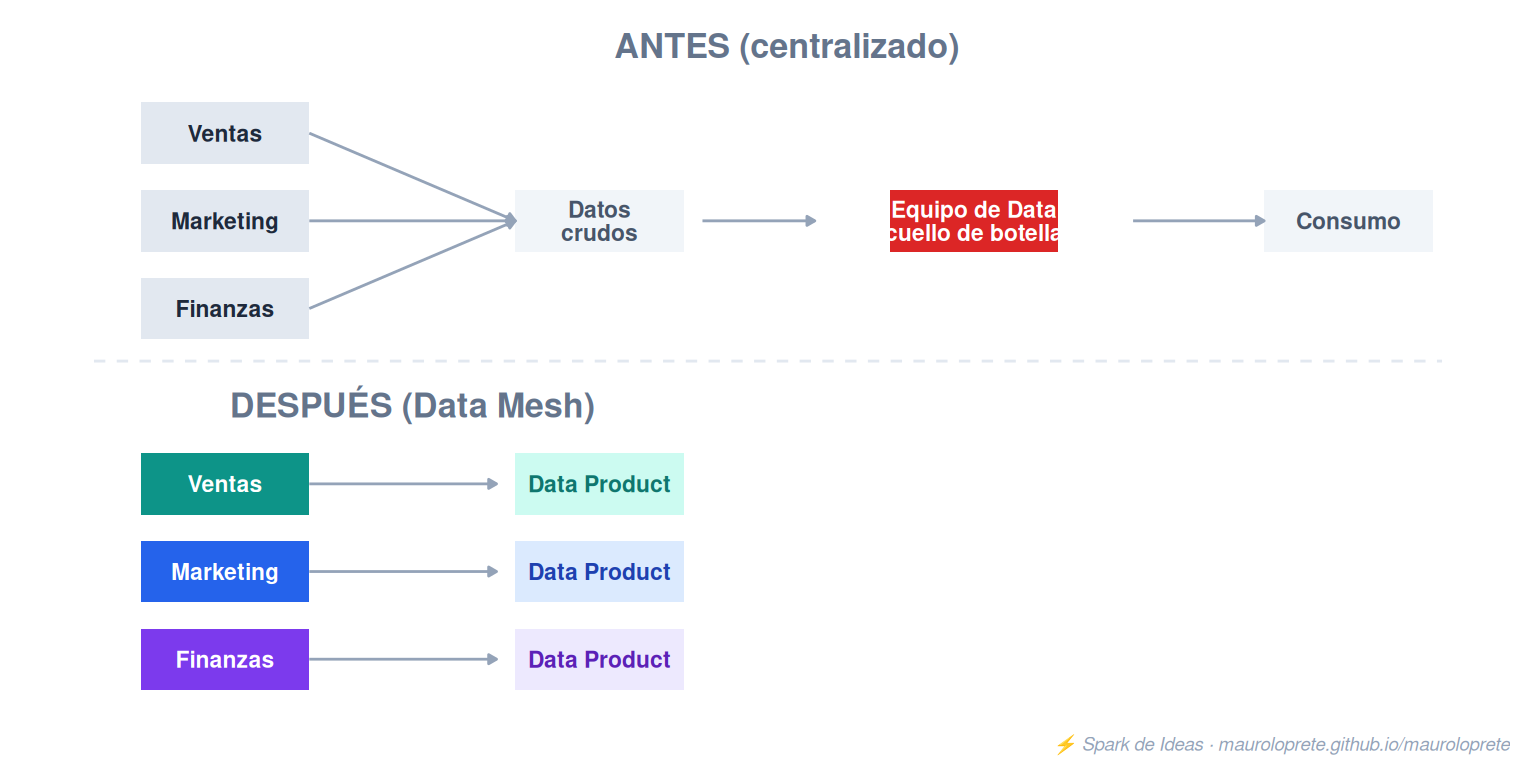
Data Mesh es probablemente el concepto más malinterpretado de la ingeniería de datos moderna. Todo el mundo habla de Data Mesh, pocos lo implementan bien, y muchos lo usan como excusa para que cada equipo haga lo que quiera.
En este post voy al grano: qué es, qué no es, y cómo se implementa en la práctica.
Qué es Data Mesh (de verdad)
Data Mesh es una arquitectura organizacional propuesta por Zhamak Dehghani en 2019. No es una tecnología, no es un producto, no es “cada equipo tiene su propio lakehouse”.
Se basa en 4 principios:
1. Domain Ownership (propiedad por dominio)
Los datos son responsabilidad del equipo que los genera, no del equipo central de datos.
Lo que funciona: los equipos de dominio conocen mejor sus datos. Las transformaciones son más correctas.
Lo que no funciona: si el equipo de Ventas no tiene un data engineer, no van a poder mantener pipelines de calidad. Data Mesh requiere que cada dominio tenga capacidad técnica.
2. Data as a Product
Los datos publicados por un dominio deben tratarse como un producto: con documentación, SLAs, calidad garantizada y un dueño responsable.
# Data Product: ventas diarias
product:
  name: daily_sales
  domain: sales
  owner: sales-data-team
  sla:
    freshness: "daily by 8:00 AM UTC"
    availability: "99.5%"
  schema:
    table: prod.sales.daily_revenue
    format: Delta
    documentation: "https://wiki/sales/daily-revenue"
  quality:
    - "No nulls in revenue column"
    - "Date range: last 3 years"
    - "Reconciled with ERP daily"
  consumers:
    - finance-team
    - executive-dashboards
    - ml-churn-model
Lo que funciona: cuando tratás los datos como producto, la calidad sube. Hay un dueño, hay SLAs, hay documentación.
Lo que no funciona: si no tenés Data Contracts y Quality Monitors, “data as a product” es solo un lindo nombre para una tabla que nadie mantiene.
3. Self-Serve Data Platform
Un equipo de plataforma provee las herramientas para que los dominios puedan publicar sus data products sin depender de un equipo central.
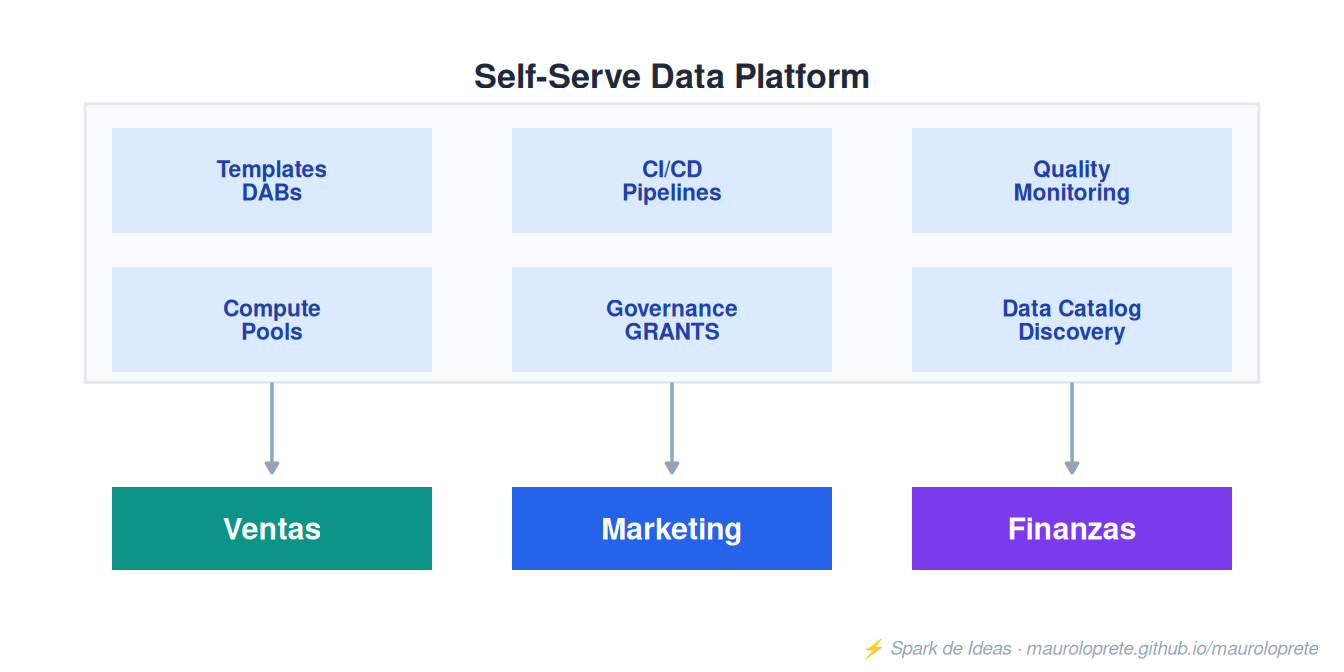
Lo que funciona: Databricks Asset Bundles + Unity Catalog es una combinación muy buena para esto. Cada dominio tiene su bundle template, deploya con CI/CD, y la gobernanza es centralizada.
Lo que no funciona: construir la plataforma lleva meses. Si arrancás con Data Mesh antes de tener la plataforma lista, es caos.
4. Federated Computational Governance
La gobernanza es global pero la ejecución es local. El equipo de plataforma define las reglas, cada dominio las implementa.
-- Gobernanza global: reglas definidas por plataforma

-- Todas las tablas Gold deben tener estas propiedades
ALTER TABLE prod.sales.daily_revenue SET TBLPROPERTIES (
  'domain' = 'sales',
  'data_product' = 'daily_revenue',
  'owner' = 'sales-data-team',
  'sla_freshness' = 'daily',
  'pii' = 'false'
);

-- Todas las columnas PII deben tener masking
-- (esta regla la define plataforma, cada dominio la implementa)
ALTER TABLE prod.sales.customers
ALTER COLUMN email SET MASK platform.security.mask_email;
Implementación con Databricks + Unity Catalog
Estructura de catálogos
-- Un catalog por dominio
CREATE CATALOG sales;
CREATE CATALOG marketing;
CREATE CATALOG finance;
CREATE CATALOG platform;  -- para funciones compartidas

-- Schemas estándar en cada dominio
CREATE SCHEMA sales.bronze;
CREATE SCHEMA sales.silver;
CREATE SCHEMA sales.gold;      -- data products publicados acá

-- Permisos: cada dominio gestiona su catalog
GRANT ALL PRIVILEGES ON CATALOG sales TO `sales-data-team`;
GRANT USE CATALOG ON CATALOG sales TO `data-consumers`;
GRANT SELECT ON SCHEMA sales.gold TO `data-consumers`;
DABs por dominio
# domains/sales/databricks.yml
bundle:
  name: sales-domain

include:
  - ../../platform/shared-config.yml

resources:
  pipelines:
    sales_pipeline:
      name: "[${var.env}] Sales Data Pipeline"
      target: sales.silver
      serverless: true
      libraries:
        - notebook:
            path: ./notebooks/transform.py

  jobs:
    daily_gold:
      name: "[${var.env}] Sales Gold Refresh"
      tasks:
        - task_key: build_gold
          notebook_task:
            notebook_path: ./notebooks/gold.py
      schedule:
        quartz_cron_expression: "0 0 7 * * ?"
        timezone_id: "America/Montevideo"
Quality Monitors
-- Monitor automático sobre data product
CREATE OR REPLACE QUALITY MONITOR sales.gold.daily_revenue (
  TIME_SERIES (
    timestamp_col = "date"
  ),
  CUSTOM_METRICS (
    (
      name = "revenue_not_negative",
      definition = "AVG(CASE WHEN total_revenue < 0 THEN 1 ELSE 0 END)",
      type = AGGREGATE
    ),
    (
      name = "row_count",
      definition = "COUNT(*)",
      type = AGGREGATE
    )
  )
);
Los errores más comunes
1. “Data Mesh = no tener equipo central de datos”
Mal. Data Mesh cambia el rol del equipo central: de construir pipelines a construir la plataforma. Si eliminás el equipo central, no tenés gobernanza.
2. “Cada dominio elige su stack”
Mal. La plataforma es una. Si Ventas usa Spark, Marketing usa dbt, y Finanzas usa Pandas, no tenés interoperabilidad. El stack lo define plataforma, cada dominio lo usa.
3. “Arrancamos con Data Mesh mañana”
Mal. Data Mesh es una transformación organizacional, no técnica. Necesitás: ownership definido, equipos con capacidad de DE, plataforma self-serve lista, y buy-in de management.
4. “Data Mesh reemplaza el data warehouse”
Mal. Los data products de cada dominio pueden alimentar un warehouse centralizado para reportería ejecutiva. Data Mesh y warehouse coexisten.
¿Cuándo tiene sentido?
| Situación | ¿Data Mesh? |
|---|---|
| Empresa con 3-5 fuentes de datos | No, overkill |
| Equipo de datos < 10 personas | No, centralizado funciona mejor |
| +50 fuentes, +5 dominios, +20 personas de datos | Sí |
| Equipos de dominio sin DE skills | No todavía, primero capacitá |
| Ya tenés Unity Catalog + DABs | Buena base para empezar |
Links
- Data Mesh (Zhamak Dehghani) — referencia original
- How to Move Beyond a Monolithic Data Lake (Zhamak) — el artículo que arrancó todo
Unity Catalog (Databricks) — gobernanza federada en la práctica
Próxima semana: volvemos a Databricks Tips con Lakeflow Declarative Pipelines.