Buenas prácticas #4: Liquid Clustering, cuando los datos piden orden
Taller semanal del equipo de datos · Sesión 4
2026-08-19
Buenas prácticas de datos
Liquid Clustering
Cuando el problema no es la query: es cómo están guardados los datos
Taller semanal · Sesión 4
Mauro Loprete
La señal que venimos arrastrando
Desde la sesión 1, en la tabla de alarmas:
Files pruned ≈ 0 con filtro selectivo → el layout no ayuda a podar archivos
- La query filtra por
cliente_idy devuelve 200 filas - Pero el Scan leyó todos los archivos de la tabla
- El filtro está bien escrito (sesión 2): la columna limpia, sin funciones encima
Hoy: por qué pasa, y qué se hace.
El experimento del taller
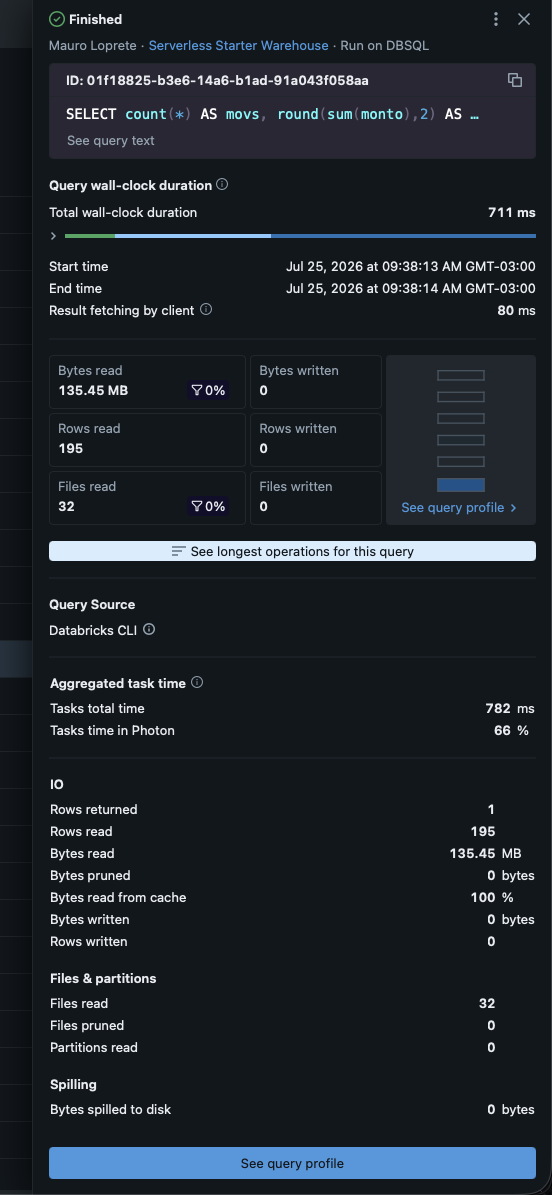
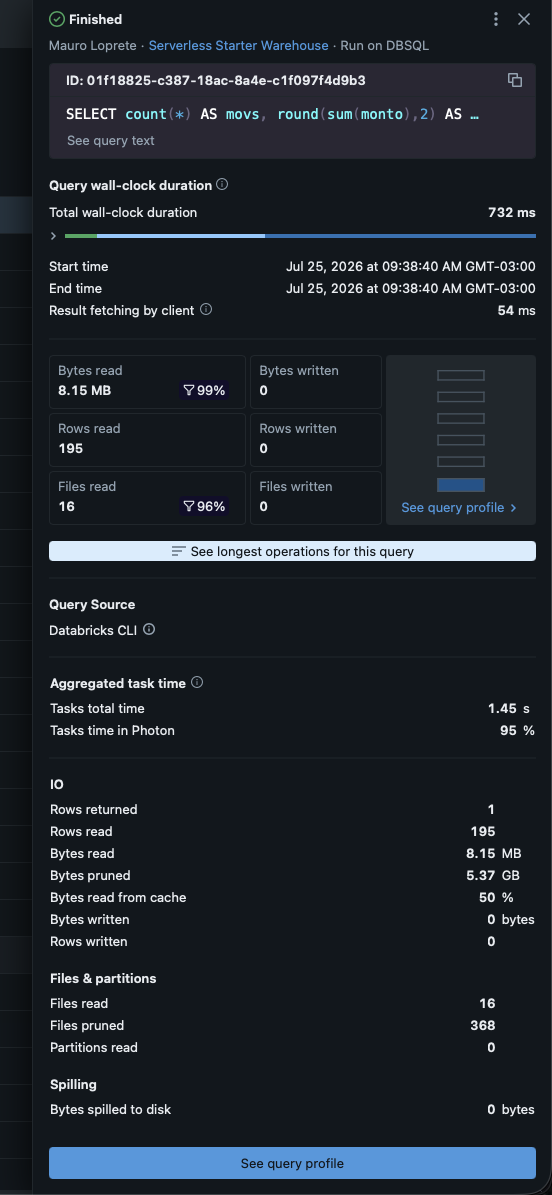
Misma query, mismos datos, mismas 195 filas de respuesta: sin clustering lee 135 MB y poda 0; con Liquid lee 8 MB y poda 368 de 384 archivos.
Por qué el motor no puede podar
- Delta guarda estadísticas min y max por archivo (sesión 2)
- Si los datos llegaron en orden de llegada, cada archivo tiene clientes mezclados: el rango de
cliente_idde cada archivo cubre casi todo - El filtro pregunta “¿puede estar el cliente 12034 acá?” y todos los archivos responden que sí
Cómo se arreglaba esto antes
Dos técnicas venían a resolver el mismo problema, cada una con su peaje:
- Particionado Hive-style: una carpeta por cada valor de la clave (
fecha=2024-01-15/)- Solo rendía en tablas grandes: la guía clásica pedía más de 1 TB y particiones de al menos 1 GB
- Alta cardinalidad prohibida (una carpeta por
cliente_idson miles de carpetas con archivos chiquitos), y si elegiste mal la clave: reescribir toda la tabla
- Z-ORDER:
OPTIMIZE tabla ZORDER BY (cliente_id)agrupa los valores cercanos de varias columnas en los mismos archivos- Mejoraba la poda, pero era un job a mano que había que correr cada vez que entraban datos
- No es incremental: para incorporar un lote nuevo reescribe casi toda la tabla
El orden se lograba, pero pagando mantenimiento manual para siempre. Eso es lo que viene a jubilar Liquid Clustering.
1
Liquid Clustering
Ordenar los archivos según cómo consultás
Qué es
- Reorganiza físicamente los archivos de la tabla según clustering keys que definís
- Con los archivos agrupados por esas claves, los rangos min y max se vuelven angostos → el data skipping empieza a funcionar
- Reemplaza a las dos técnicas viejas, y no se combina con ellas: es una cosa o la otra
- Lo que ninguna de las dos tenía:
- Las claves se pueden cambiar sin reescribir los datos existentes
- El mantenimiento es incremental: cada
OPTIMIZEordena solo lo que falta, no reescribe la tabla como Z-ORDER
Databricks lo recomienda hoy para todas las tablas nuevas.
Cómo se usa
-- Tabla nueva
CREATE TABLE plata.movimientos (
  mov_id BIGINT, cliente_id BIGINT, fecha DATE, monto DECIMAL(18,2)
)
CLUSTER BY (cliente_id, fecha);

-- Tabla existente
ALTER TABLE plata.movimientos CLUSTER BY (cliente_id, fecha);

-- Reorganizar: el clustering es INCREMENTAL, esto lo dispara
OPTIMIZE plata.movimientos;

-- Primera vez o cambio de claves: forzar el recluster completo
OPTIMIZE plata.movimientos FULL;
Gotcha número 1:
ALTER TABLE ... CLUSTER BYno reordena nada por sí solo. Sin elOPTIMIZE FULLinicial, el histórico queda como estaba.
Cómo elegir las claves
| Criterio | Por qué |
|---|---|
| Columnas por las que filtrás seguido | Son las que activan la poda |
| Alta cardinalidad (ids, timestamps) | Con particiones viejas eran inviables; acá son ideales |
| Hasta 4 claves, pero menos suele ser mejor | En tablas medianas, 2 claves podan mejor que 4 |
- La evidencia está en Query History: ¿por qué columnas filtran de verdad las queries del equipo?
- Existe
CLUSTER BY AUTO: Databricks elige las claves según los patrones de consulta. Requiere tablas gestionadas por Unity Catalog y predictive optimization activo
2
En nuestro flujo
Desde dbt y Prophecy
Activarlo desde dbt
El adapter de dbt para Databricks lo expone como config del modelo:
O en el propio modelo:
No hace falta salir del flujo de Prophecy y dbt: el clustering queda declarado en el proyecto, versionado como todo lo demás.
Nota: También se puede y se debe hacer en el contrato.
Casos comunes
- Habilitar no reordena: sin
OPTIMIZE FULL, el histórico sigue desordenado - No convive con particionado clásico ni Z-ORDER: es una cosa o la otra
- Sube la versión de protocolo de la tabla y no se puede bajar: clientes Delta muy viejos pueden dejar de poder leerla
- Las claves deben estar entre las columnas con estadísticas (por defecto, las primeras 32 de la tabla)
- Más claves no es mejor: en tablas medianas, 4 claves podan peor que 2
El método completo
- Medí (sesión 1): Query History → Query Profile → las tres preguntas
- Arreglá la query (sesión 2): columnas, filtros limpios, grano testeado, filtrar temprano
- Usá la herramienta correcta (sesión 3): window functions donde corresponde, con PARTITION BY sano
- Y si la query está bien y el Scan igual lee todo (hoy): el problema es el layout → clustering keys según los filtros reales
Siempre en ese orden. Clusterizar una tabla para salvar una query mal escrita es esconder el problema.
Para esta semana
- Buscá en Query History la tabla más consultada por el equipo
- Anotá por qué columnas filtran las queries reales que le pegan
- Mirá un Query Profile de esas queries: ¿files pruned dice cero?
- Si dice cero: armá la propuesta de clustering keys y la charlamos la próxima
No clusterices nada todavía: primero la evidencia, después el cambio (y el
OPTIMIZE FULLse coordina, no se lanza un viernes).
Fin de la primera vuelta
¿Y ahora qué?
Candidatos para las próximas sesiones: modelos incrementales, MERGE, archivos chicos, caching en warehouses…
¿Preguntas? · Mauro Loprete
Referencias
Buenas prácticas · Mauro Loprete