Buenas prácticas #2: queries mal optimizadas, los patrones que más duelen
Taller semanal del equipo de datos · Sesión 2
Mauro Loprete
2026-08-05
Buenas prácticas de datos
Queries mal optimizadas
Los patrones que más duelen
Taller semanal · Sesión 2
Mauro Loprete
Recap de la sesión 1
Query History: todo lo que corre contra un warehouse queda registrado
Query Profile: el plan ejecutado, con números reales por operador
Las tres preguntas: ¿cuánto leyó?, ¿algo multiplicó filas?, ¿dónde se fue el tiempo?
Hoy: los cinco patrones que explican la mayoría de los profiles feos.
1
SELECT *
Pagás por columnas que no usás
Por qué duele: el formato es columnar
Delta Lake guarda los datos por columna, no por fila
Si tu query pide 4 columnas, el motor lee solo esas 4 del disco
Con SELECT * leés todas: en una tabla ancha, eso es pagar 10 veces más por lo mismo
Señal en el profile: bytes leídos enormes en el Scan para una query que al final usa pocas columnas.
SELECT * en cadena
-- Modelo intermedio: arrastra TODOWITH movimientos AS (SELECT*FROM bronze.movimientos -- 80 columnas),enriquecido AS (SELECT*FROM movimientos mJOIN dim.clientes c ON m.cliente_id = c.cliente_id)SELECT cliente_id, fecha, monto -- usás 3FROM enriquecido
-- Proyectar temprano: el Scan lee 3 columnas, no 80WITH movimientos AS (SELECT cliente_id, fecha, montoFROM bronze.movimientos)...
La señal, medida
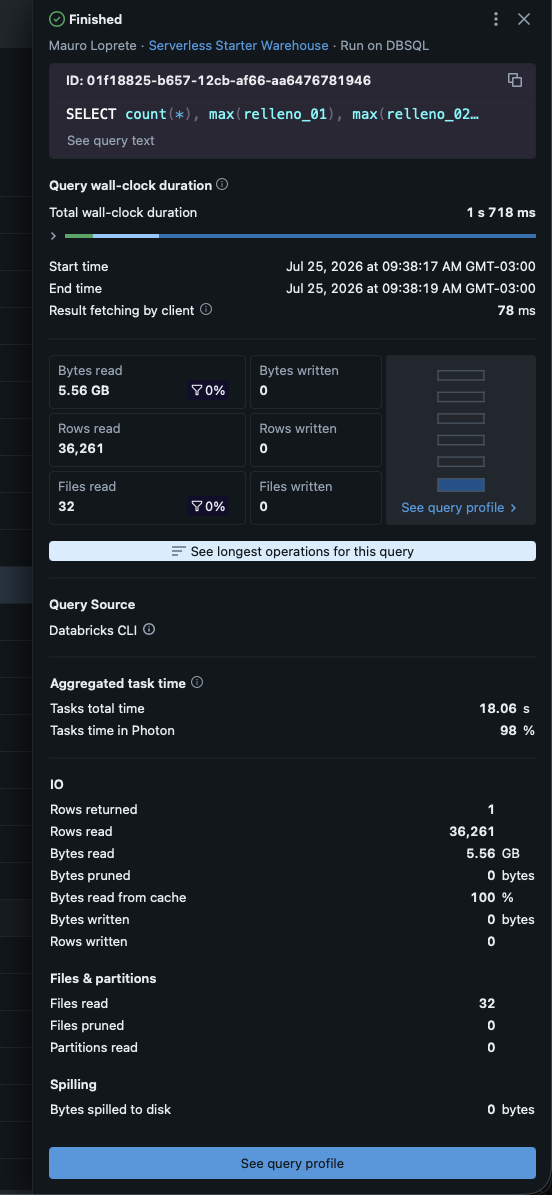
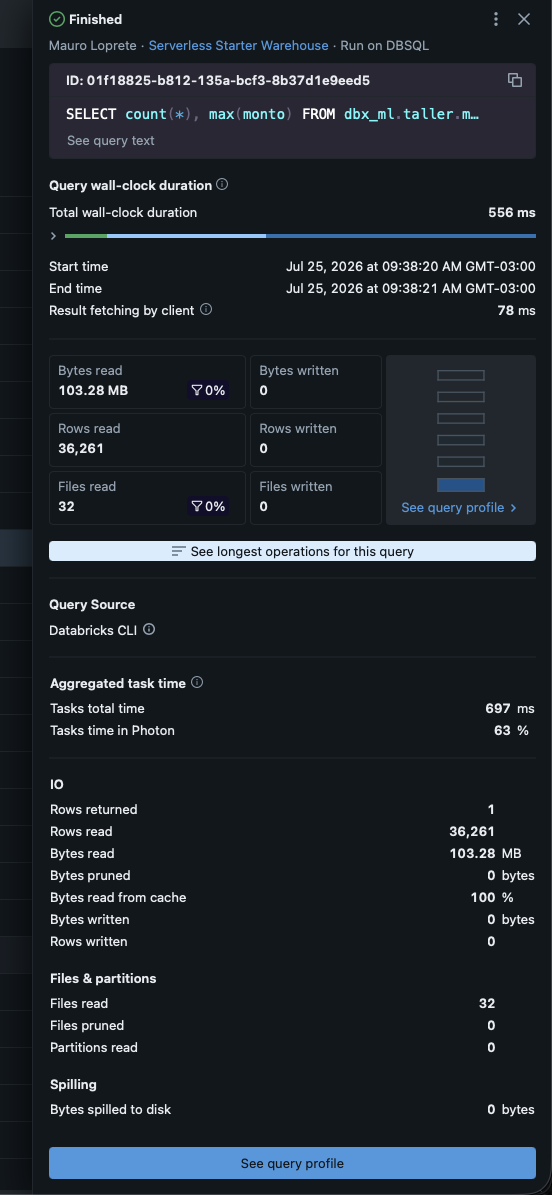
-- Izquierda: leer todas las columnas -- Derecha: solo lo necesarioSELECTcount(*), max(relleno_01), /* ... */SELECTcount(*), max(monto)max(relleno_16), max(canal), max(monto)FROM dbx_ml.taller.movimientos WHERE fecha = DATE'2024-06-15'
Misma tabla, mismo filtro, mismas 36.261 filas: 5,56 GB vs 103 MB leídos y 18 s vs 0,7 s de CPU.
2
Filtros que no podan
El WHERE que obliga a leer todo
Data skipping: podar sin leer
Delta guarda estadísticas min y max por archivo para cada columna
Con WHERE fecha = '2026-08-01', el motor descarta los archivos cuyo rango no incluye esa fecha: eso es files pruned
Pero si envolvés la columna en una función, el motor ya no puede comparar contra las estadísticas
-- No poda: la función tapa la columnaWHERE DATE_FORMAT(fecha_hora, 'yyyy-MM-dd') ='2026-08-01'-- Poda: la columna queda limpia, comparás por rangoWHERE fecha_hora >='2026-08-01'AND fecha_hora <'2026-08-02'
Variantes del mismo problema
-- Cast sobre la columnaWHERECAST(cliente_id AS STRING) ='12034'-- Mejor: comparar con el tipo realWHERE cliente_id =12034-- Función de texto sobre la columnaWHEREUPPER(canal) ='WEB'-- Mejor: normalizar el dato al escribirlo, no al leerloWHERE canal ='web'
Si el dato necesita limpieza para poder filtrarlo, la limpieza va una vez al escribir, no en cada query que lee.
La señal, medida
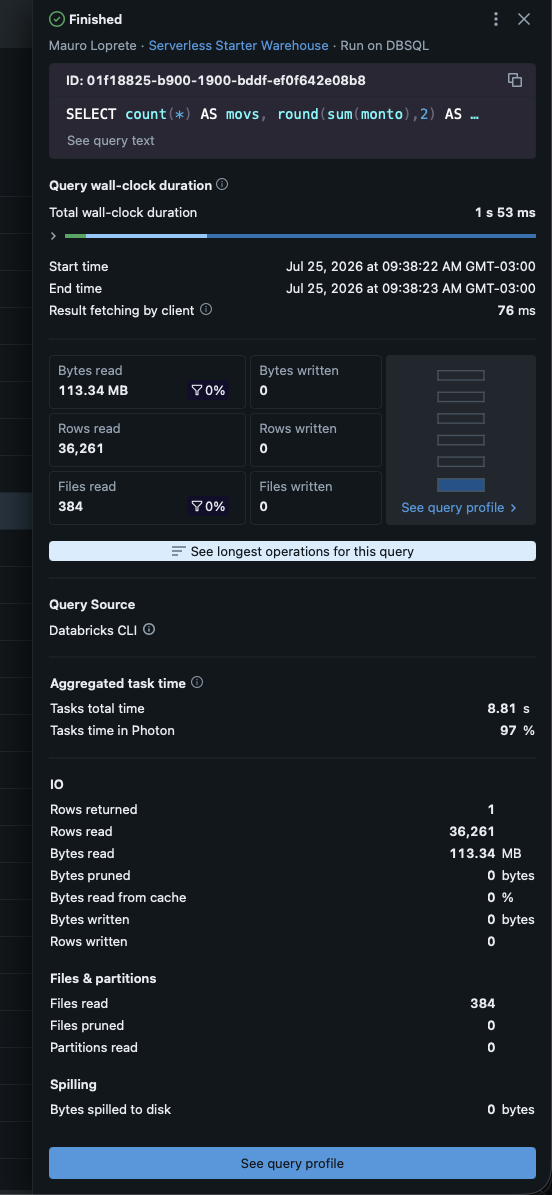
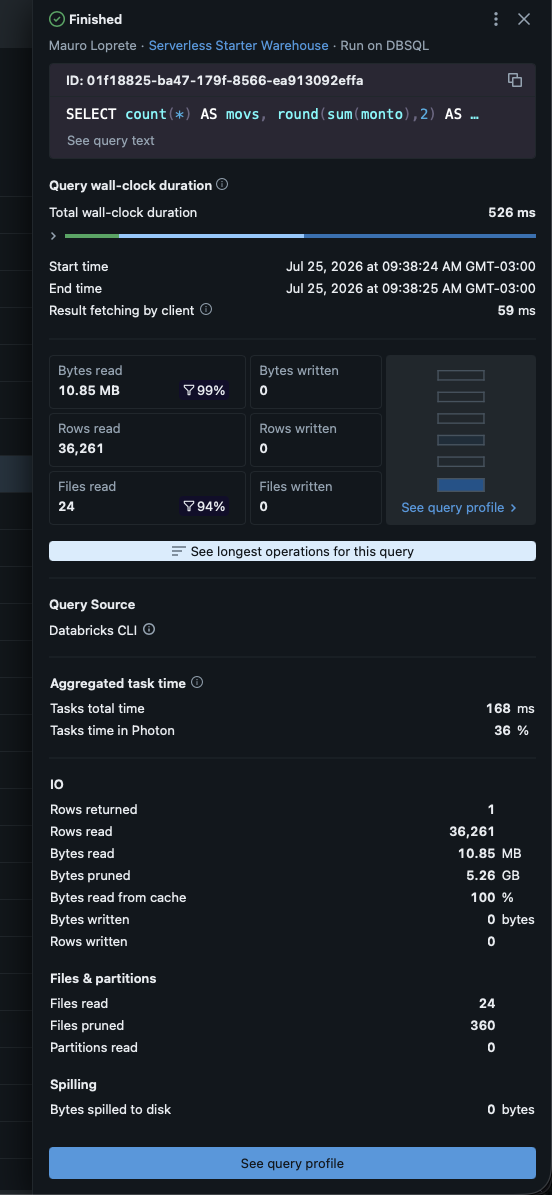
SELECTcount(*) AS movs, round(sum(monto), 2) AS totalFROM dbx_ml.taller.movimientos_liquidWHERE date_format(fecha, 'yyyy-MM-dd') ='2024-06-15'-- izquierda: no podaWHERE fecha = DATE'2024-06-15'-- derecha: poda casi todo
Misma query: con la función encima, 384 archivos leídos y 0 podados; con el filtro limpio, 24 leídos y 360 podados.
3
El join explosivo
Cuando la granularidad es incorrecta
Claves duplicadas multiplican filas
SELECT m.*, c.segmentoFROM movimientos mLEFTJOIN clientes_historia cON m.cliente_id = c.cliente_id
clientes_historia tiene una fila por cliente y por versión (historia completa)
Cada movimiento matchea todas las versiones del cliente: 1M de movimientos → 20M de filas
Señal en el profile: el Join saca muchas más filas de las que entran
-- Fijar el grano antes del join: una fila por clienteLEFTJOIN (SELECT cliente_id, segmentoFROM clientes_historiaWHERE es_vigente =true) c ON m.cliente_id = c.cliente_id
Que la granularidad sea una garantía, no una suposición
En dbt (y por lo tanto en Prophecy) el grano se declara y se testea:
El test corre en cada ejecución: si aparece un duplicado, falla el pipeline, no el job
Un join contra una tabla con unique testeado no puede explotar por ese lado
4
Filtrar tarde
El optimizador no ve a través de las tablas
Cada tabla materializada corta la optimización
Dentro de una query, el optimizador empuja los filtros hacia abajo solo
Pero cuando un modelo escribe una tabla y otro la lee, son queries separadas: el filtro del modelo 3 no le llega al Scan del modelo 1
modelo_1: lee 500M de movimientos (histórico completo) ← acá se pagamodelo_2: enriquece esos 500M con 4 joins ← y acámodelo_3: WHERE fecha >= '2026-01-01' → quedan 30M ← el filtro llegó tarde
El filtro va en el primer modelo que toca la tabla grande, no tres modelos después.
La versión incremental
Si el pipeline corre todos los días, ¿hace falta reprocesar todo el histórico cada vez?
-- Modelo incremental en dbt: solo lo nuevo{{ config(materialized='incremental') }}SELECT...FROM bronze.movimientos{% if is_incremental() %}WHERE fecha >= (SELECTMAX(fecha) FROM {{ this }}){% endif %}
Primera corrida: procesa todo. Las siguientes: solo lo nuevo
Prophecy lo soporta: es la materialización incremental de dbt
5
DISTINCT como parche
Tapar el síntoma sale caro
El combo join explosivo + DISTINCT
SELECTDISTINCT m.mov_id, m.monto, c.segmentoFROM movimientos mJOIN clientes_historia c ON m.cliente_id = c.cliente_id
Lo que ejecuta el motor:
El join explota filas (patrón 3): 1M → 20M
El DISTINCT agrupa las 20M para volver a 1M: shuffle y aggregate gigantes, y ahí suele aparecer el spill
Pagaste dos veces: una por explotar, otra por desexplotar. El fix del patrón 3 (arreglar el grano) hace ambas cosas gratis.
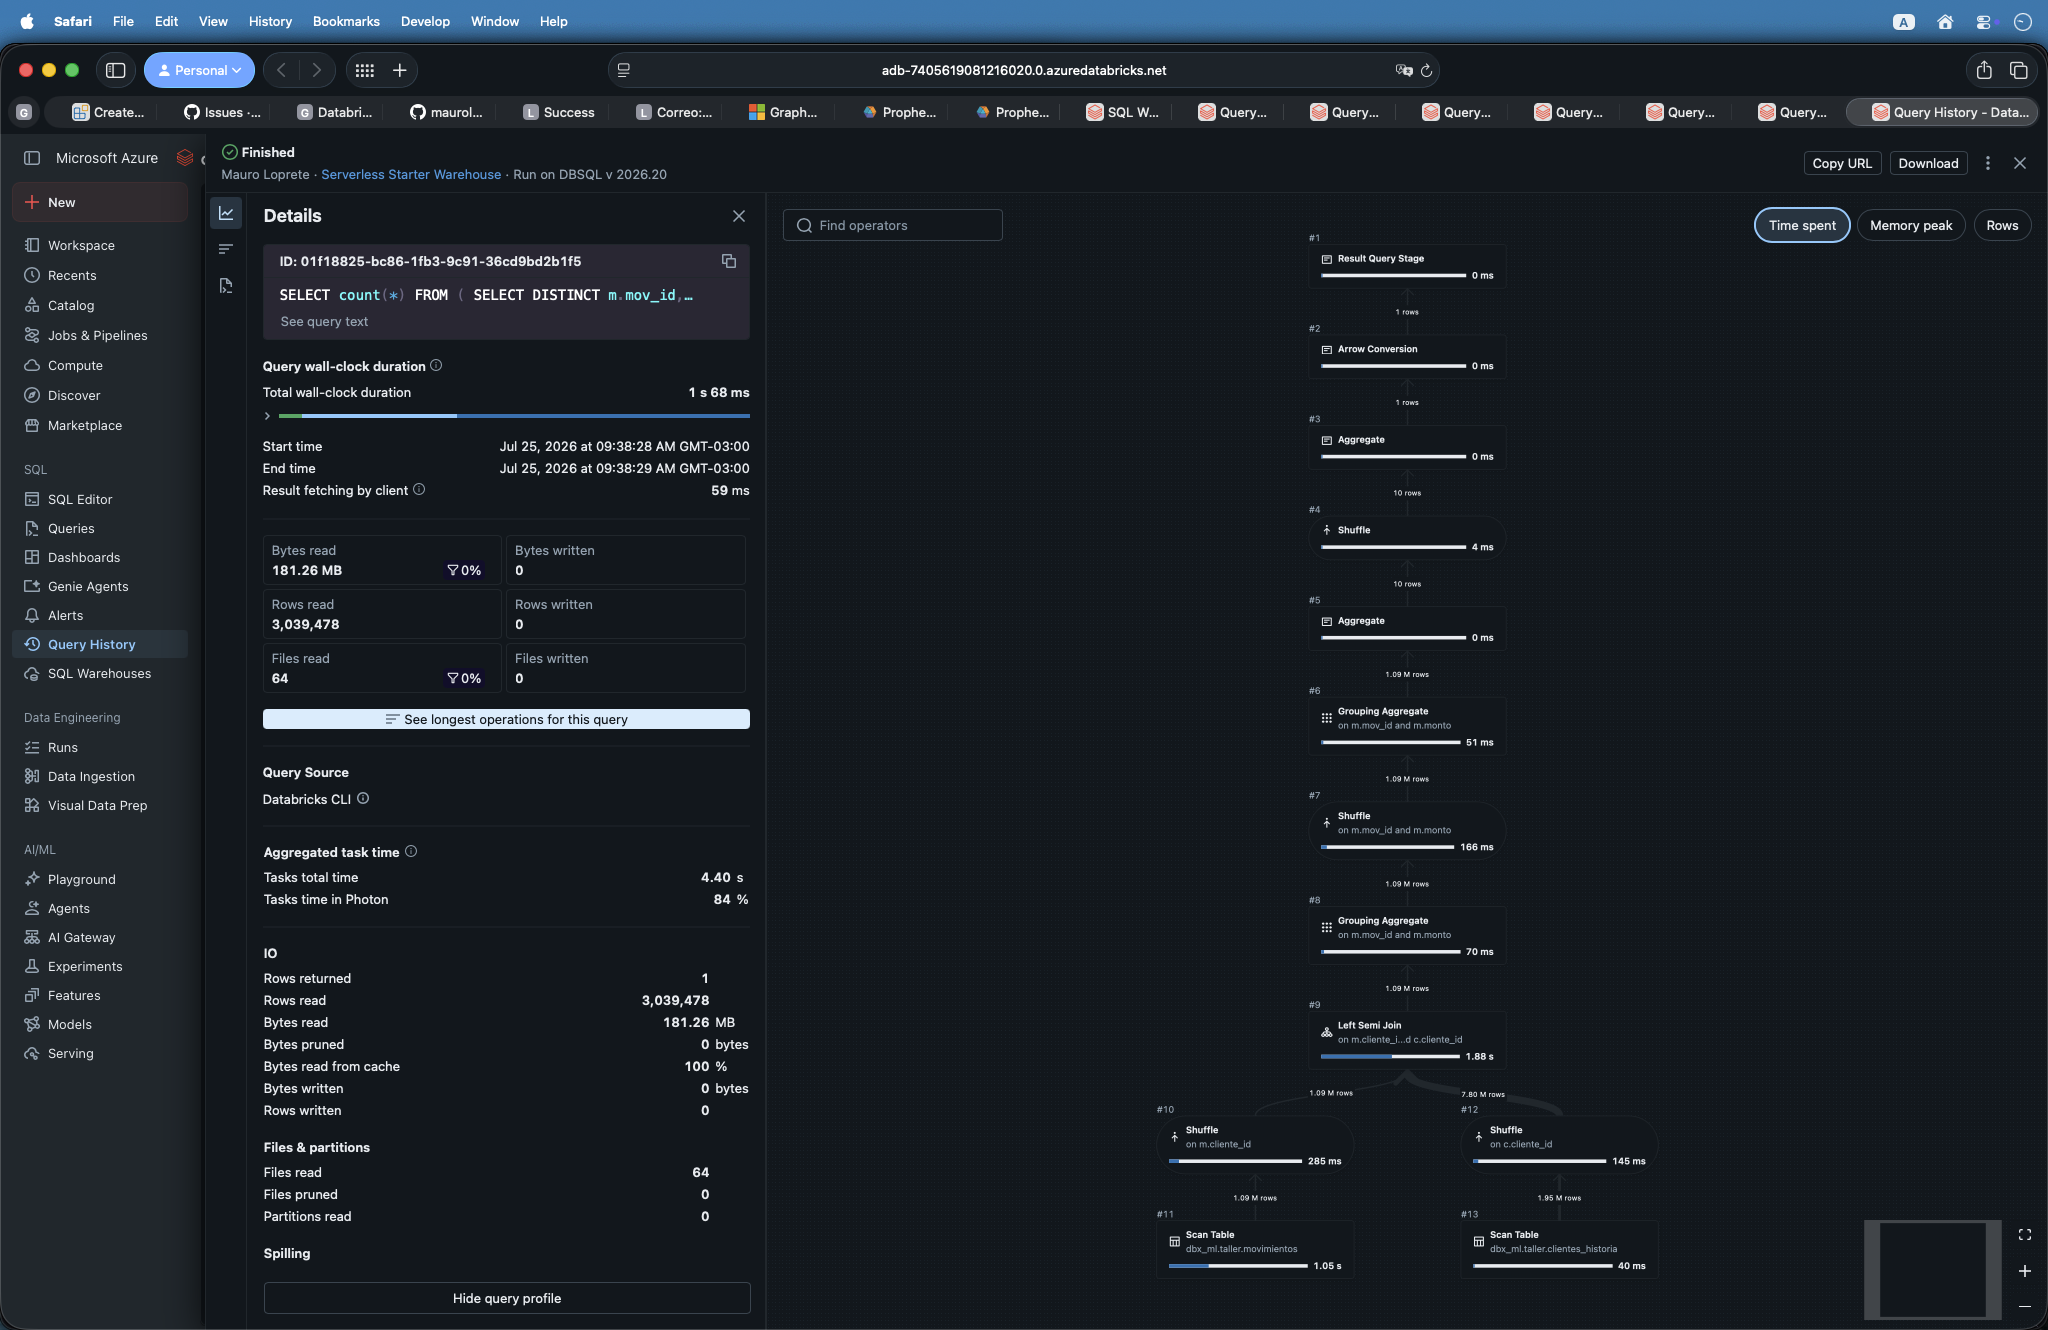
El combo, visto en el profile
SELECTcount(*) FROM (SELECTDISTINCT m.mov_id, m.montoFROM dbx_ml.taller.movimientos mJOIN dbx_ml.taller.clientes_historia c ON m.cliente_id = c.cliente_idWHERE m.fecha >='2024-06-01'AND m.fecha <'2024-07-01')
El Join explota a 21,2 millones de filas y el Aggregate del DISTINCT las vuelve a comprimir
Todo ese trabajo para volver al 1,1 millón que ya tenías antes del join
El checklist de la sesión
Antes de mandar el PR
Patrón
¿Proyecto solo las columnas que necesito?
1
¿Mis filtros dejan la columna limpia (sin funciones encima)?
2
¿Sé la granularidad de cada lado de cada join? ¿Está testeado con unique?
3
¿Filtro en el primer modelo que toca la tabla grande?
4
¿Ese DISTINCT tapa un duplicado que debería arreglar?
5
Para esta semana
Agarrá un pipeline tuyo que corra a diario
Pasale el checklist de los 5 patrones
Si encontrás uno: arreglalo y compará el antes y el después en el Query Profile
Traé los números: duración, bytes leídos, filas por operador
Un solo patrón arreglado con evidencia vale más que los cinco anotados.
Próxima sesión
Window functions
La herramienta más potente que estamos subusando (y cómo no pagarla cara)