Buenas prácticas #1: el Query Profile

Taller semanal del equipo de datos · Sesión 1

Mauro Loprete

2026-07-29

Buenas prácticas de datos

El Query Profile

Qué hizo tu query de verdad

Taller semanal · Sesión 1

Mauro Loprete

Por qué este taller

  • Todos escribimos SQL: en Prophecy, en dbt, en el editor de Databricks
  • Ese SQL corre en Databricks, y ahí hay cosas que no se ven desde Prophecy
  • Una query lenta o un warehouse saturado casi siempre viene de cómo está escrita la query o de cómo están guardados los datos

Nada de esto se arregla adivinando: hay que mirar qué ejecutó Databricks.

La serie

Sesión Tema
1 (hoy) El Query Profile: leer qué hizo tu query
2 Queries mal optimizadas: los patrones que más duelen
3 Window functions: potencia y costo
4 Liquid Clustering: ordenar los datos para leer menos

Cada sesión: un tema, casos que fui viendo con ustedes, algo para probar en la semana.

1

De Prophecy a los archivos

Qué corre abajo cuando ejecutás

De Prophecy a Databricks

  1. Prophecy genera un proyecto dbt: cada “pipeline” visual es SQL versionado
  2. Ese SQL se ejecuta en un SQL Warehouse: el cómputo de Databricks para queries SQL
  3. Las tablas viven en Delta Lake: archivos Parquet más un log de transacciones
  4. El motor que ejecuta es Photon: procesa columnas en bloque, no fila por fila

Vos escribís (o dibujás) la query. Databricks decide el plan: en qué orden filtrar, unir y agregar. El Query Profile muestra ese plan, ejecutado, con números reales.

2

El monitor

Query History y Query Profile

Query History: todo queda registrado

En el menú lateral de Databricks: SQL → Query History

  • Todas las queries que corrieron contra un SQL Warehouse
  • Venga de Prophecy, de un job de dbt o del editor SQL: todo aparece acá
  • Filtros por usuario, warehouse, duración, estado y fecha
  • Ordenás por duración y arriba quedan las que hay que mirar primero

Cuando algo anda lento, lo primero es abrir Query History y ver qué pasó. Por ahí empieza cualquier diagnóstico.

Query Profile

Click en una query → Query Profile. Tres partes:

  1. Resumen: cuánto tardó y en qué se fue el tiempo (compilar, encolar, ejecutar)
  2. Grafo de operadores: los pasos que ejecutó el motor, conectados
  3. Métricas por operador: tiempo, filas, bytes leídos, memoria

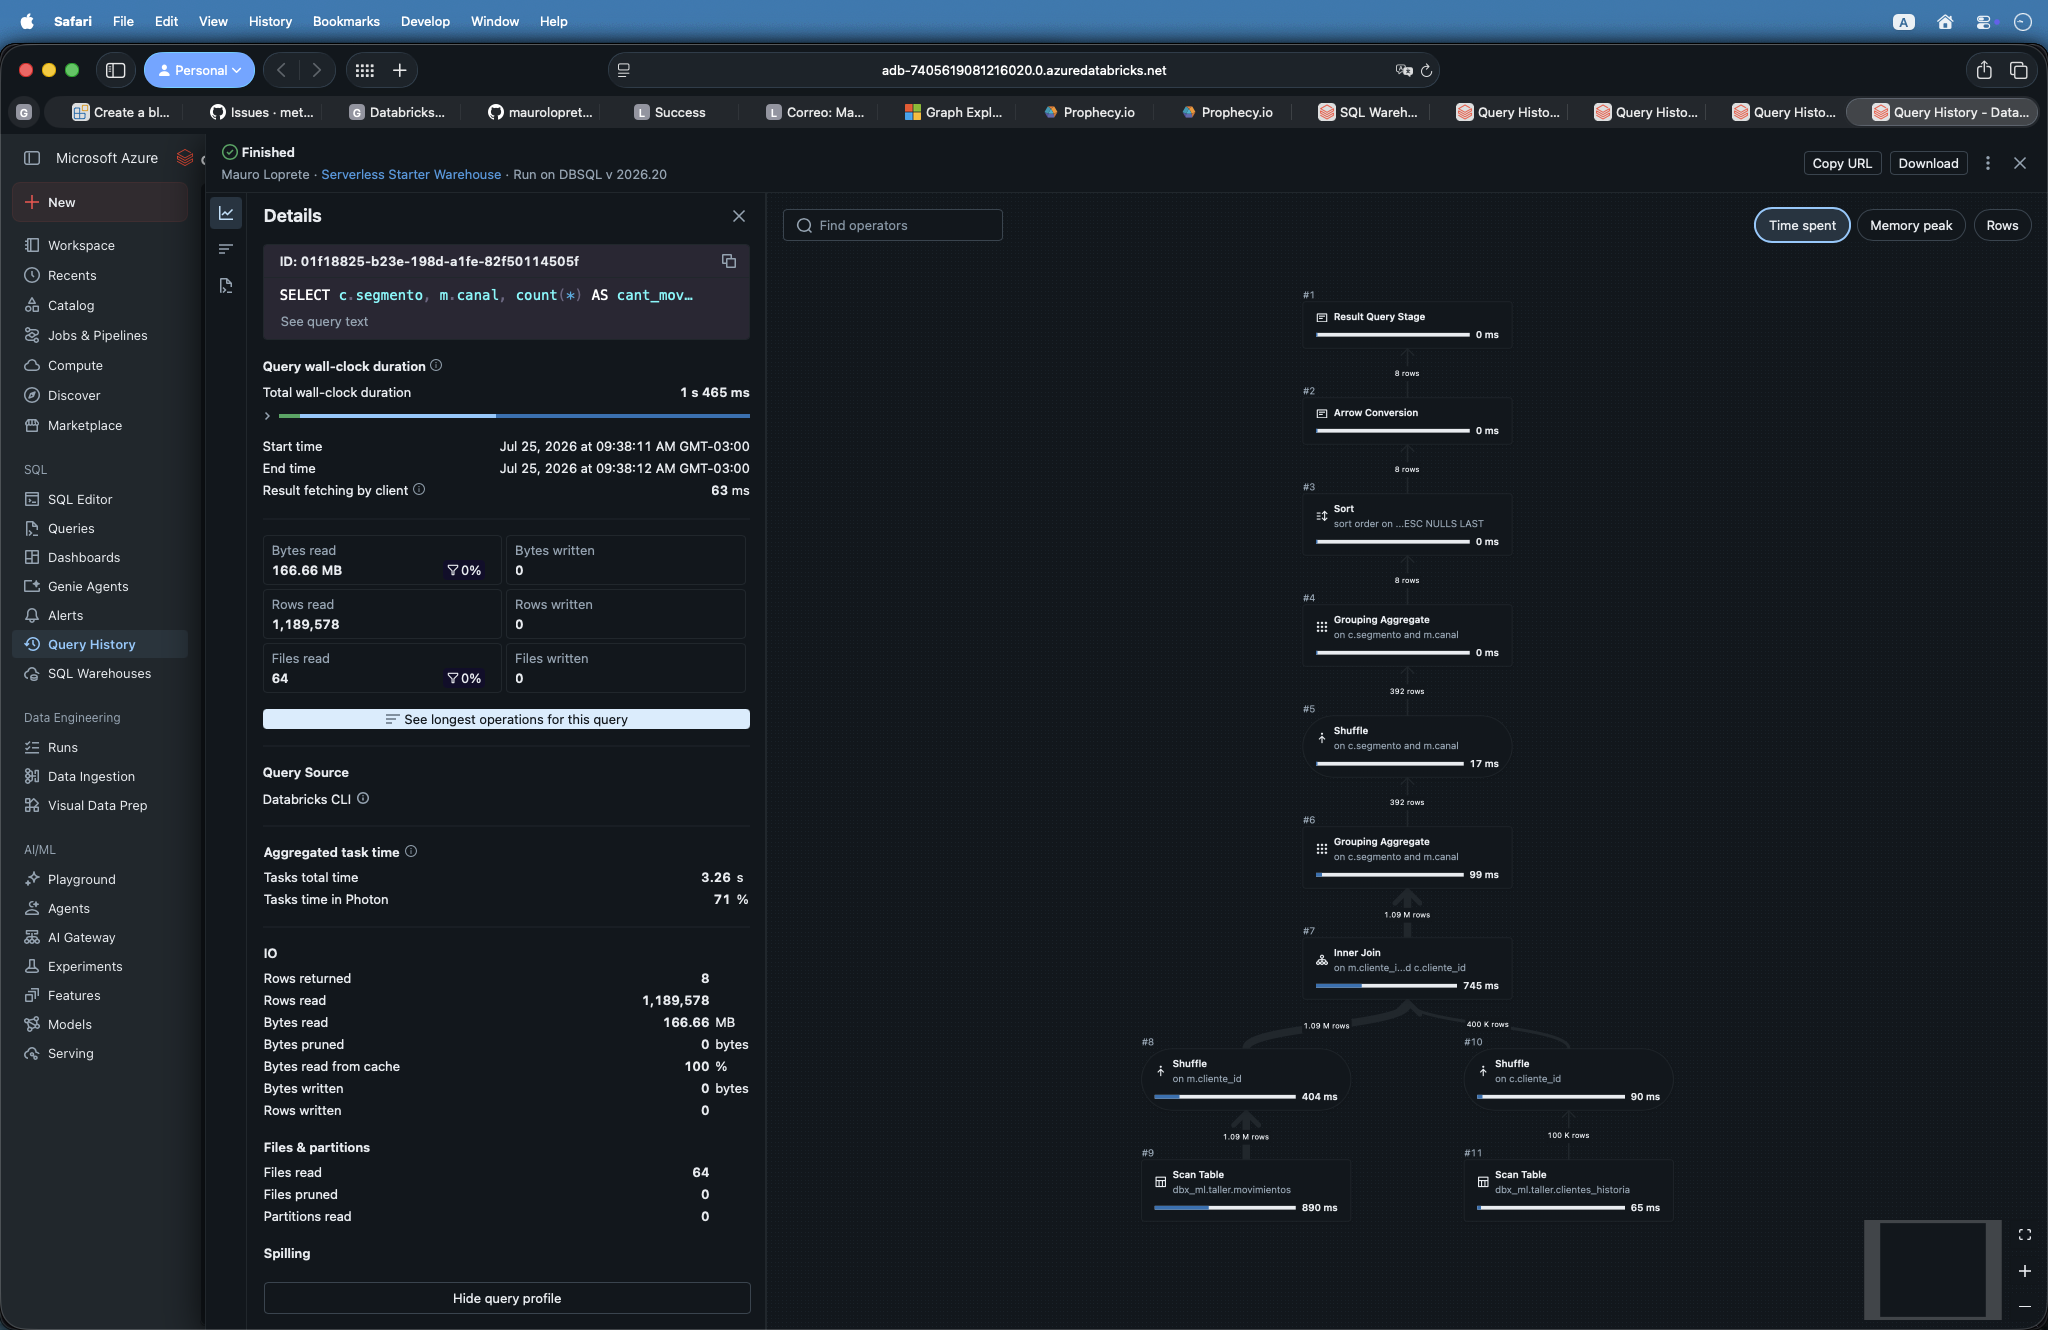
Así se ve en el workspace

SELECT c.segmento, m.canal, count(*) AS cant_movs, round(sum(m.monto), 2) AS total
FROM dbx_ml.taller.movimientos m
JOIN (SELECT cliente_id, segmento FROM dbx_ml.taller.clientes_historia WHERE es_vigente) c
  ON m.cliente_id = c.cliente_id
WHERE m.fecha >= '2024-06-01' AND m.fecha < '2024-07-01'
GROUP BY 1, 2 ORDER BY total DESC
3

Los operadores

Scan, Join, Shuffle y compañía

Los operadores que vas a ver siempre

Operador Qué hace
Scan Lee los archivos de una tabla Delta
Filter Aplica el WHERE
Project Selecciona y calcula columnas
Join Une dos fuentes (casi siempre hash join)
Shuffle Redistribuye filas entre workers por una clave
Aggregate El GROUP BY: agrupa y calcula
Sort Ordena filas
Window Funciones de ventana (sesión 3)

Cómo se lee

  • El plan se lee desde los Scan hacia el resultado
  • Cada operador muestra filas que entran y filas que salen
  • El Query Profile te marca dónde se fue el tiempo: buscá el operador que concentra la mayoría

Tres preguntas, en orden:

  1. ¿Cuánto leyó cada Scan? ¿Era necesario leer todo eso?
  2. ¿Algún operador multiplica filas en vez de reducirlas?
  3. ¿Dónde se concentra el tiempo?

Las 5 señales de alarma

Señal Qué significa Sesión
Files pruned ≈ 0 con filtro selectivo El layout no ayuda a podar archivos 4
Filas de salida ≫ filas de entrada en un Join Claves duplicadas: cartesiano 2
Spill (disco) > 0 No entró en memoria: sort o join gigante 2 y 3
Un operador con >80% del tiempo Ahí está tu problema, no en el resto hoy
Bytes leídos enormes para pocas columnas SELECT * aguas arriba 2

Con estas cinco señales alcanza para arrancar: cubren casi todos los problemas que nos vamos a cruzar en el taller.

Caso real 1: la query que lee todo

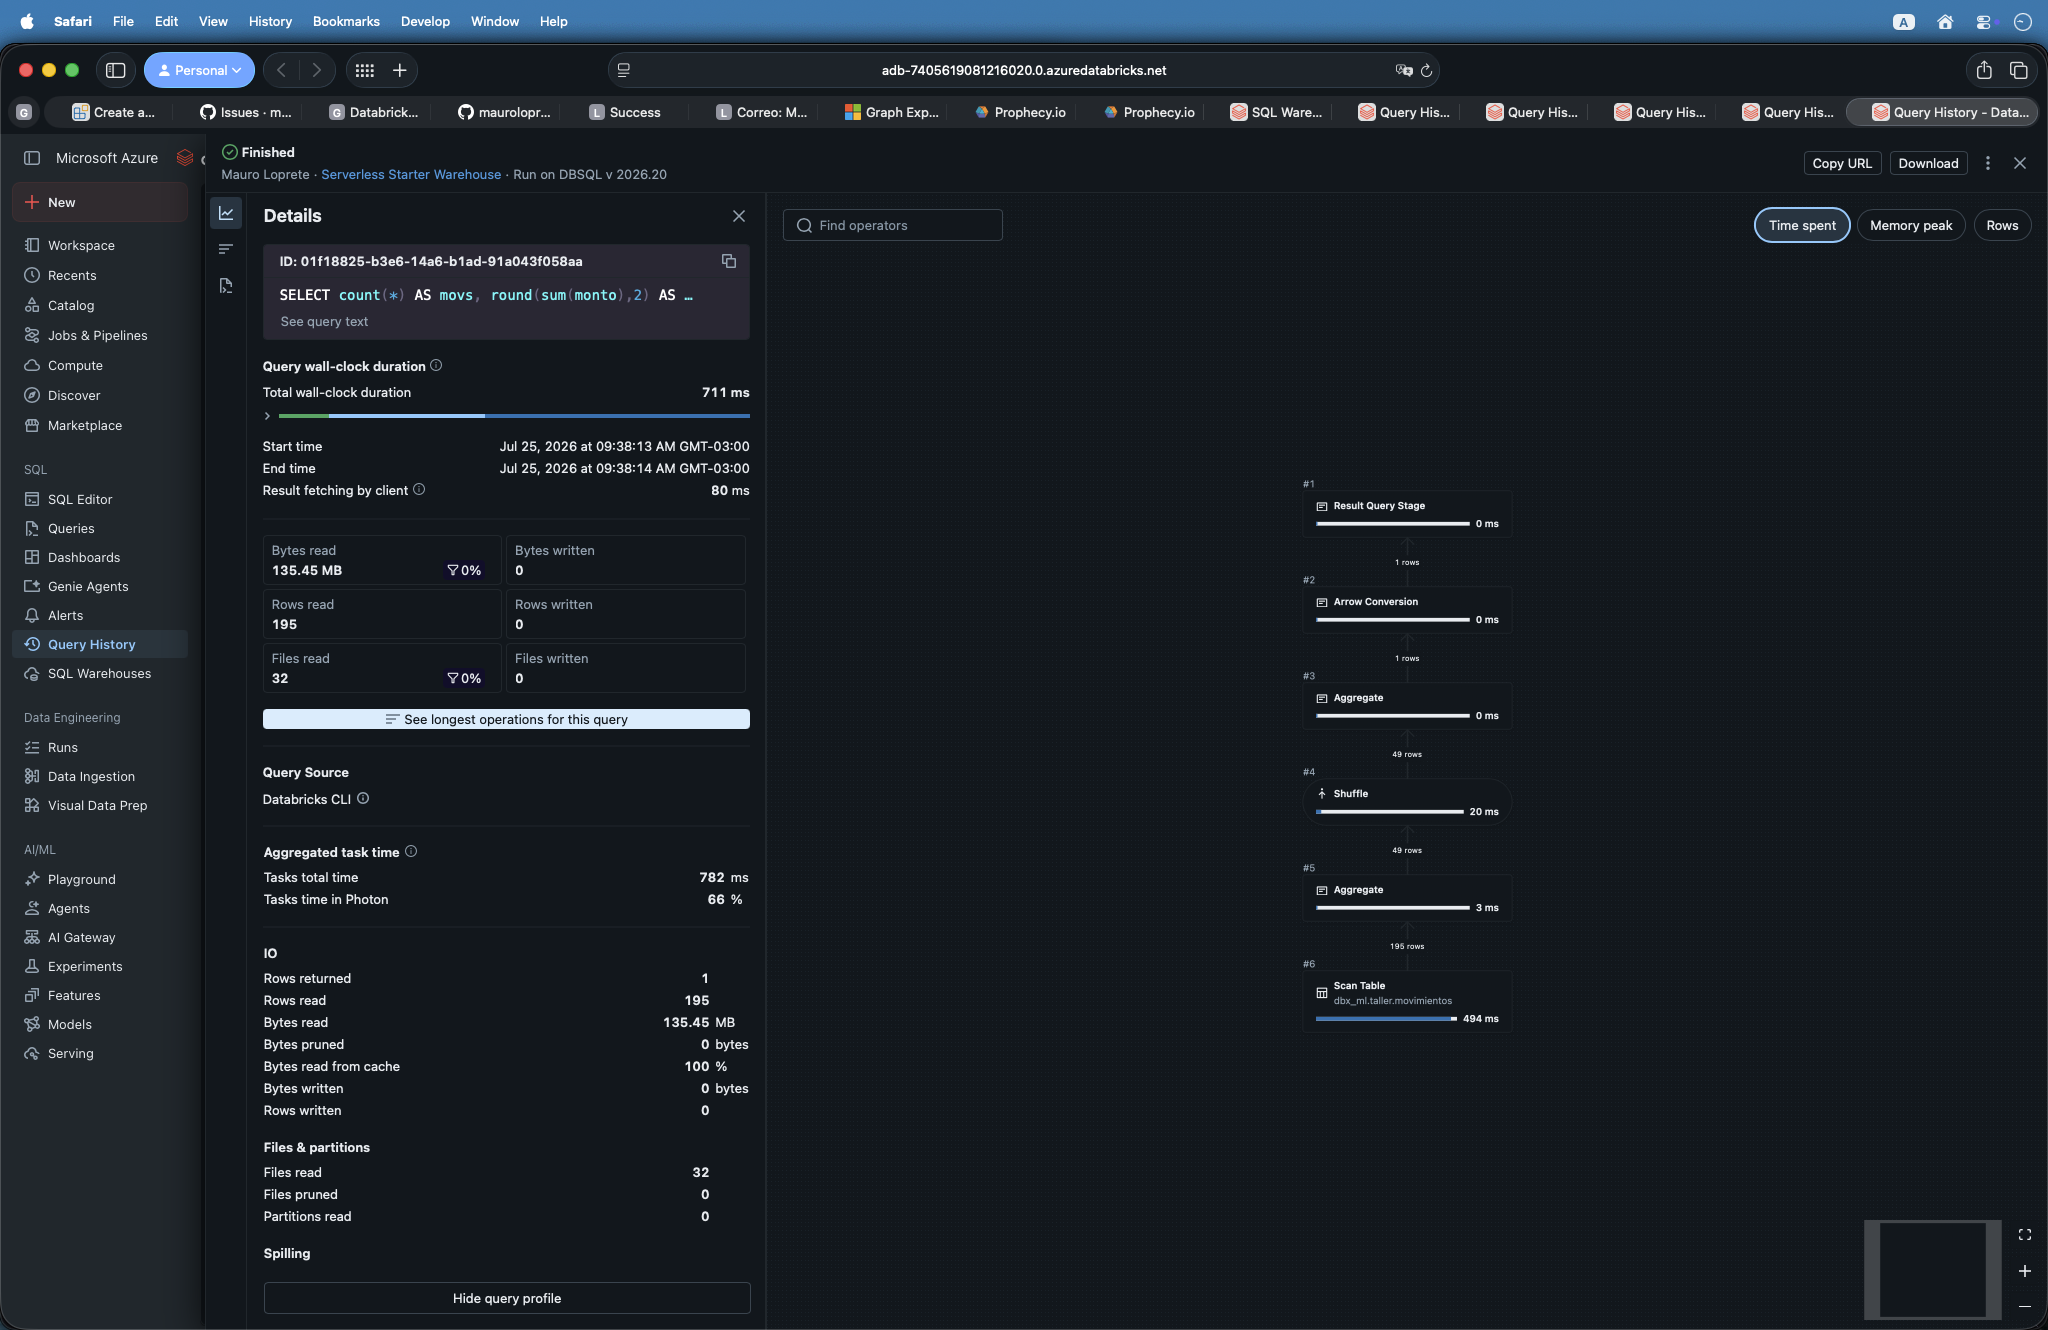
SELECT count(*) AS movs, round(sum(monto), 2) AS total
FROM dbx_ml.taller.movimientos
WHERE cliente_id = 12034

  • Devuelve 195 filas de un solo cliente, y para eso leyó los 32 archivos de la tabla: files pruned 0
  • El filtro está bien escrito; por qué no pudo podar lo vemos en la sesión 4

Caso real 2: el join que multiplica
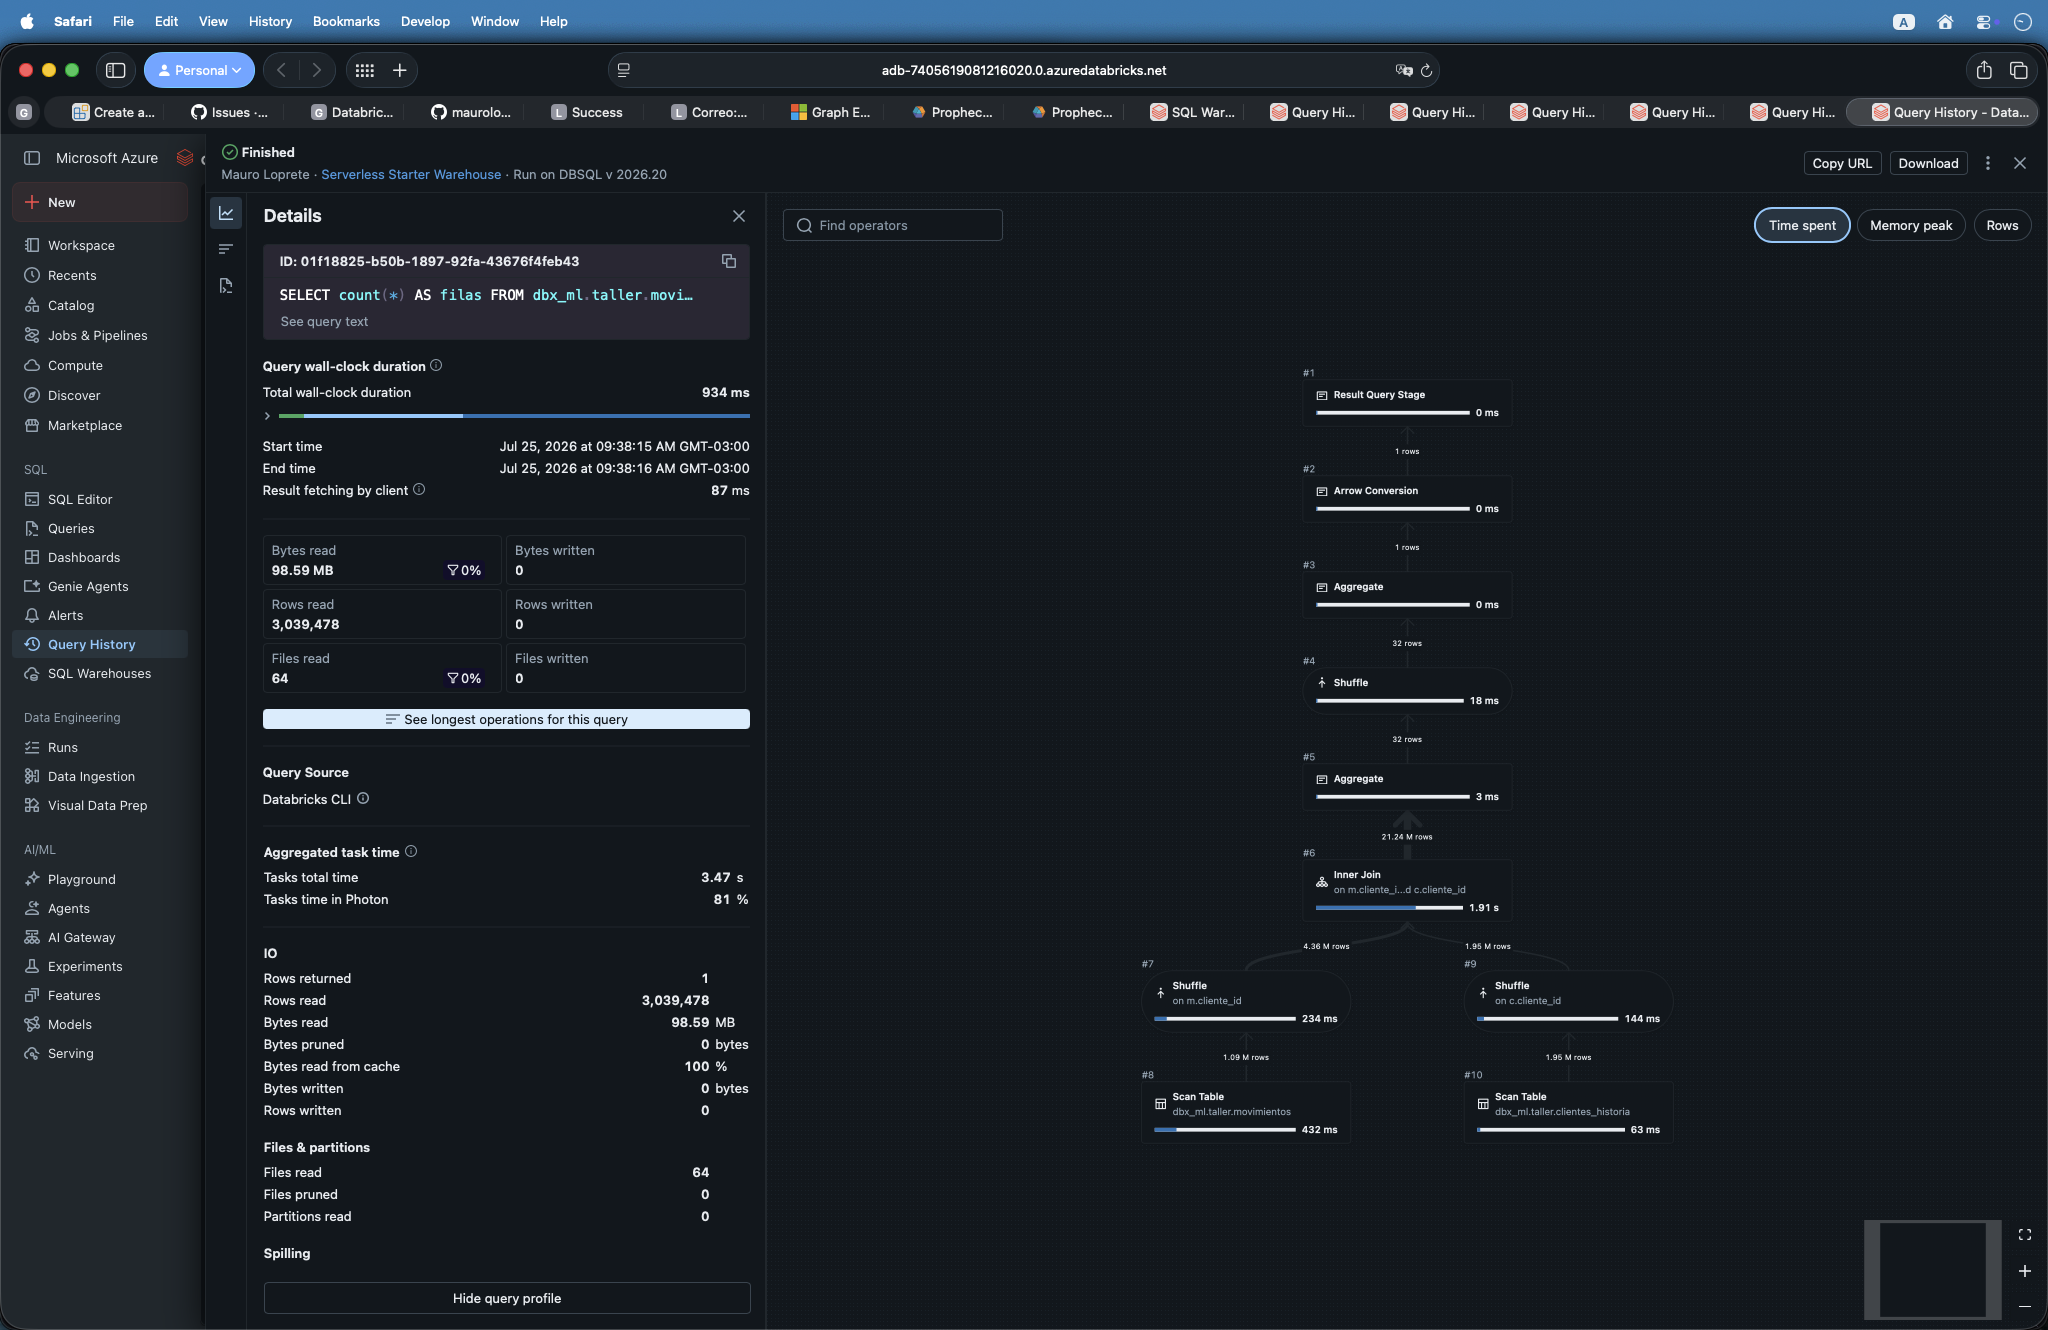
SELECT count(*) AS filas
FROM dbx_ml.taller.movimientos m
JOIN dbx_ml.taller.clientes_historia c ON m.cliente_id = c.cliente_id
WHERE m.fecha >= '2024-06-01' AND m.fecha < '2024-07-01'

  • Al Join entran 1,1 millones de movimientos y salen 21,2 millones de filas
  • Cuando un join devuelve 20 veces lo que entró, hay claves duplicadas en algún lado
Un detalle: Photon no siempre puede

  • Photon es el motor rápido, pero no soporta todas las operaciones
  • Cuando encuentra algo que no soporta (una UDF, por ejemplo), esa parte cae al motor clásico de Spark: más lento, y sin avisar
  • En el Query Profile se ve qué porcentaje corrió en Photon

Si una query venía rápida y de golpe es lenta, revisá si algo la sacó de Photon.

Para esta semana

  1. Abrí Query History y filtrá por el job de tu pipeline
  2. Encontrá tu query más lenta de la semana
  3. Abrí el Query Profile y respondé las tres preguntas:
    • ¿Cuánto leyó? ¿Algo multiplicó filas? ¿Dónde se fue el tiempo?
  4. Traé el caso la próxima sesión: los mejores los vemos entre todos

No hay que arreglar nada todavía. Solo mirar y contar qué encontraste.

Próxima sesión

Queries mal optimizadas

SELECT *, filtros que no podan, joins explosivos y otros clásicos

¿Preguntas? · Mauro Loprete